
از آگوست ۲۰۲۶، متنی که از بزرگترین دستیارهای هوش مصنوعی دریافت میکنید، دیگر صرفاً متن نیست. Claude و Gemini اکنون یک واترمارک آماری در کلماتی که انتخاب میکنند پنهان کردهاند و OpenAI اعلام کرده است که متن نوبت بعدی برای ChatGPT است. شما نمیتوانید آن را ببینید، اما ارائهدهنده میتواند آن را بررسی کند و همچنین هر کسی که یک آشکارساز به او داده شود. اگر وبسایتها میسازید، برای مشتریان مینویسید یا در مقیاس بزرگ منتشر میکنید، در اینجا آنچه امروز در متنهای تولید شده توسط هوش مصنوعی وجود دارد، نحوه بررسی محتوای خودتان، نحوه حذف واترمارکهای هوش مصنوعی و نحوه تولید متن تمیز با استفاده از NoTrack API از همان ابتدا آورده شده است.
برچسب نامرئی روی محتوای شما
در ۲ آگوست ۲۰۲۶، قوانین شفافیت قانون هوش مصنوعی اتحادیه اروپا (ماده ۵۰) اجرایی شد. آنها ارائهدهندگان هوش مصنوعی مولد را ملزم میکنند تا آنچه سیستمهایشان تولید میکنند را به صورت قابل خواندن توسط ماشین علامتگذاری کنند، تا بتوان آن را به عنوان تولید هوش مصنوعی تشخیص داد. آزمایشهای بزرگ سریع حرکت کردند.
- Anthropic (Claude). در ۱۴ آگوست ۲۰۲۶ Anthropic اعلام کرد که مدلهای جدید Claude متنی تولید میکنند که حاوی یک واترمارک است، و مدلهای قدیمیتر در ماههای بعد بهروزرسانی شدند. یک API تشخیصدهنده برای تنظیمکنندگان، نیروهای پلیس، رسانهها، راستیآزمایها، محققان و سازمانهای آموزشی در حال حاضر در پیشنمایش خصوصی قرار دارد.
- Google (Gemini). Gemini از سال ۲۰۲۴ خروجی متنی خود را با SynthID واترمارک کرده است، روشی که Google DeepMind در Nature منتشر کرد و در سال ۲۰۲۴ به صورت متنباز ارائه داد. واترمارک Claude بر اساس همان رویکرد ساخته شده است.
- OpenAI (ChatGPT). OpenAI از پیش تصاویر و صوت تولید شده را علامتگذاری میکند و گفته است که میخواهد اثبات محتوا را به متن نیز گسترش دهد. گزارش شده است که یک واترمارک متنی به صورت داخلی ساخته است اما هنوز آن را منتشر نکرده است.
برای یک کاربر معمولی که به دنبال دستور پخت غذاست، هیچکدام از این مسائل اهمیت ندارد. اما برای هر کسی که متون تولیدشده با کمک هوش مصنوعی را منتشر میکند، میفروشد یا به مشتریان تحویل میدهد، این موضوع بازی را تغییر میدهد: محتوای شما اکنون دارای امضایی است که خودتان اضافه نکردهاید، نمیتوانید آن را ببینید و نمیتوانید آن را خاموش کنید.
دو نوع واترمارک برای متون هوش مصنوعی
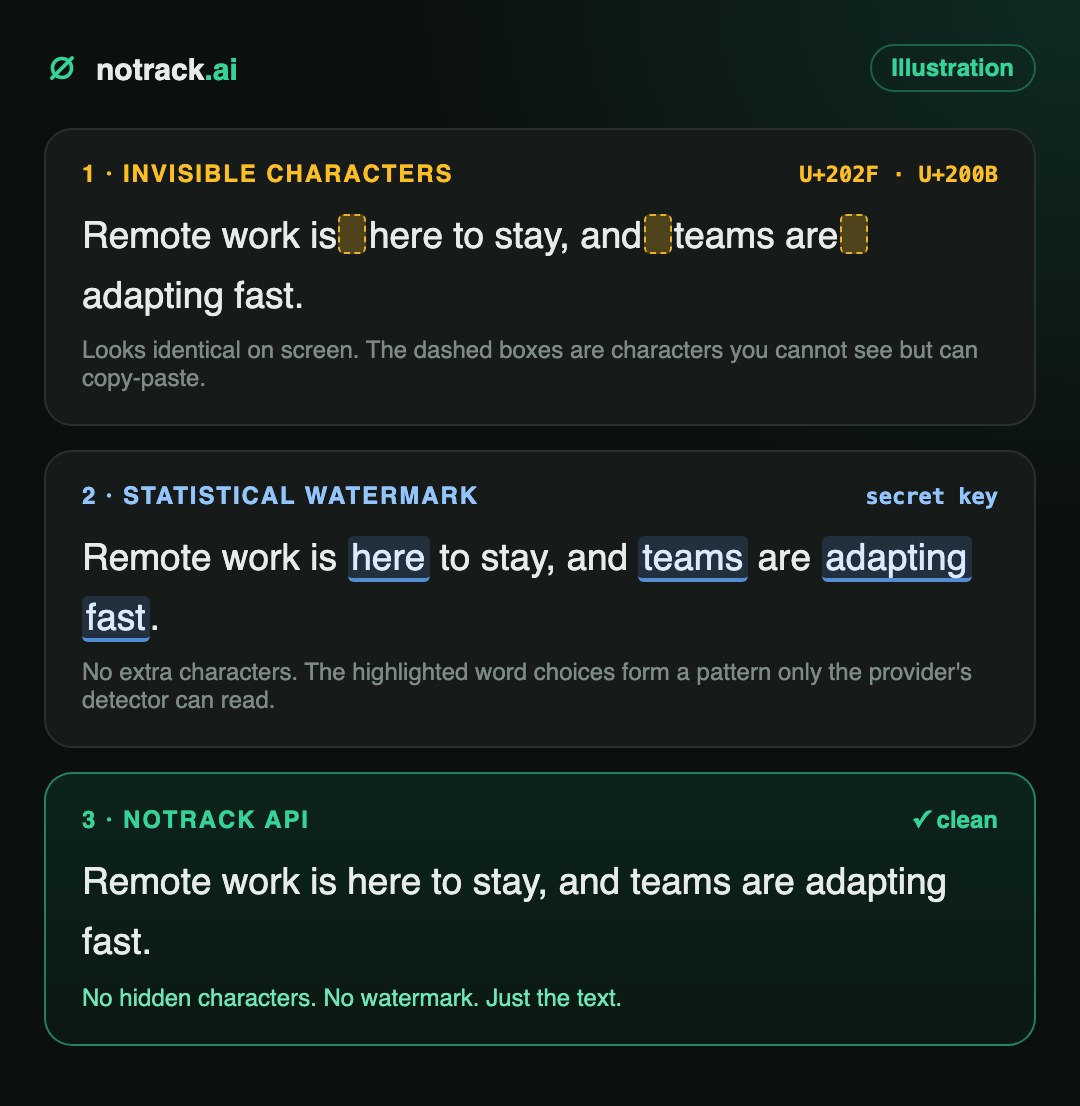
عبارت «واترمارک هوش مصنوعی» برای دو مفهوم کاملاً متفاوت به کار میرود. دانستن اینکه با کدام نوع سروکار دارید، تعیینکننده روش حذف آن است.
کاراکترهای نامرئی
کاراکترهای Unicode که دقیقاً مانند یک فاصله معمولی یا حتی بدون هیچگونه فاصلهای به نظر میرسند: کاراکترهای فضای خالی بدون عرض، پیوندهر کلمه و فاصلههای بدون شکست باریک.
- تشخیص آنها با یک اسکریپت ساده آسان است
- حذف آنها آسان است: میتوان آنها را حذف یا جایگزین کرد
- تخریب آرام: جستجو، شمارش کلمات، تطبیق کلیدواژهها، کدنویسی
واترمارکهای آماری
هیچ کاراکتر اضافی وجود ندارد. انتخابهای واژگانی مدل توسط یک کلید مخفی هدایت میشود و الگویی ایجاد میکند که تنها تشخیصدهنده ارائهدهنده میتواند آن را بخواند.
- نامرئی برای خوانندگان و هر ویرایشگر متنی
- مقاوم در برابر کپی-پیست و ویرایشهای سبک
- با بازنویسی سنگین ضعیف میشود؛ بازنویسی کامل آن را از بین میبرد
کاراکترهای نامرئی: اپیزود ChatGPT
در آوریل ۲۰۲۵، پژوهشگران متوجه شدند که متن مدلهای تازهتأسیس OpenAI یعنی o3 و o4-mini حاوی فضاهای باریک بدون شکست (U+202F) در مکانهایی است که باید یک فضای معمولی وجود داشت. هنگام چسباندن متن در Word با فعال بودن نشانگرهای قالببندی، آنها به جای نقطه، به صورت دایرههای کوچک نمایش داده میشدند. OpenAI اعلام کرد که این کاراکترها ناشی از یک ویژگی یادگیری تقویتی مقیاس بزرگ هستند و نه یک واترمارک عمدی، و بعداً این کاراکترها دیگر ظاهر نشدند. با این حال، درس مهمی در ذهن ماند: متن تولیدشده توسط هوش مصنوعی میتواند حاوی کاراکترهایی باشد که شما هرگز آنها را نمیبینید، و این کاراکترها با هر عملیات کپی-پیست به CMS شما منتقل میشوند.
واترمارکهای آماری: SynthID و Claude
یک مدل زبانی هر کلمه بعدی را از لیستی از گزینههای محتمل انتخاب میکند که کمی تصادف در آن وجود دارد. یک واترمارک آماری، آن تصادف را با یک انتخاب شبهتصادفی که با یک کلید مخفی بذرخوری شده است، جایگزین میکند. برای یک خواننده، متن کاملاً عادی به نظر میرسد. اما برای کسی که کلید را در اختیار دارد، یک متن به اندازه کافی طولانی، الگویی از انتخاب کلمات را نشان میدهد که تقریباً هرگز به صورت شانس رخ نمیدهد.
کلماتی که Claude انتخاب میکند همچنان تصادفی هستند، اما اکنون میتوان دنباله کلمات را بررسی کرد و دید که آیا با انتخابهایی که Claude در صورت استفاده از کلید انجام میداد، سازگار است یا خیر.
Anthropic, نحوه کار واترمارک متنی Claude (آگوست ۲۰۲۶)
دو جزئیات برای ناشران اهمیت دارد. واترمارک با افزایش طول متن قویتر میشود و طبق Anthropic، ویرایش سبک آن را از بین نمیبرد، اما بازنویسی کاملی که در آن هر کلمه جایگزین شود، آن را حذف میکند.
چه کسی متن هوش مصنوعی را واترمارک میکند (سپتامبر ۲۰۲۶)
| ارائهدهنده | واترمارک متن | نوع | چه کسی میتواند آن را بررسی کند |
|---|---|---|---|
| Google Gemini | بله، از سال ۲۰۲۴ | آمارایی (SynthID) | ابزارهای SynthID متعلق به Google |
| Claude Anthropic | بله، مدلهای جدید از آگوست ۲۰۲۶ | آمارشناختی (مبتنی بر SynthID) | تشخیص API توسط Anthropic، نمایش خصوصی محدود برای تنظیمگران، رسانهها، مربیان و پژوهشگران |
| ChatGPT OpenAI | هنوز برای متن پیادهسازی نشده؛ تصاویر و صوت از پیش علامتگذاری شدهاند | اثباتپذیری متن به عنوان یک هدف اعلام شده است | ابزارهای OpenAI (تصاویر و صوت امروز) |
| NoTrack API | خیر | بدون واترمارک، بدون کاراکترهای پنهان | هیچکس |
چرا متنهای دارای واترمارک به ضرر تولیدکنندگان محتواست
Google سالهاست که اعلام کرده است محتوا را بر اساس کیفیت رتبهبندی میکند، نه بر اساس نحوه تولید آن. مشکل این است که همه دیگران در این زنجیره حضور دارند.
- مشتریان شما میتوانند بررسی کنند. آژانسها و فریلنسرها متن را به افرادی تحویل میدهند که پیش از پرداخت، روزبهروز بیشتر از بررسیهای هوش مصنوعی استفاده میکنند. یک واترمارک، عبارت «کمکشده توسط هوش مصنوعی و با دقت ویرایش شده» را به «پرچمدار» تبدیل میکند و جای هیچگونه ظرافتی باقی نمیگذارد.
- پلتفرمها و بازارها غربالگری میکنند. پلتفرمهای انتشار، بازارهای فریلنسری، شبکههای تبلیغاتی و سایتهای بررسی، در حال افزودن تشخیص هوش مصنوعی هستند. یک امضای قابل تشخیص، آسانترین چیزی است که میتوان آن را فیلتر کرد.
- روند کاری شما را فاش میکند. یک واترمارک به هر کسی که یک ابزار تشخیص داشته باشد نشان میدهد که محتوای شما توسط کدام ابزار نوشته شده است. برای یک کسبوکار محتوایی، این یک اطلاعات رقابتی است که شما هرگز موافقت نکردهاید آن را منتشر کنید.
- همراه متن به همهجا میرود. متنهای واترمارکدار، چه به صورت توزیع مجدد، چه با ترجمه سبک و چه با بازنشر، امضای خود را حفظ میکنند. شما نمیتوانید چیزی را که نمیبینید، حسابرسی کنید.
- کاراکترهای پنهان باعث خرابی میشوند. کاراکترهای نامرئی Unicode به آرامی جستجوی درونسایتی، کلمات کلیدی با تطبیق دقیق، شمارش کلمات، بررسیهای املایی و هر کدی که جایگذاری میکنید را خراب میکنند. همچنین میتواند باعث شود دو صفحه که ظاهراً یکسان به نظر میرسند، از نظر بایتبهبایت با هم تفاوت داشته باشند.
نحوه بررسی متن خود برای واترمارکهای هوش مصنوعی
۱. کاراکترهای نامرئی: بررسی در چند ثانیه
آزمایش دستی سریع: متن را در Microsoft Word جایگذاری کنید و Ctrl+Shift+8 (Cmd+8 در مک) را فشار دهید تا نشانهای قالببندی نمایش داده شوند. فواصل معمولی به صورت نقطه ظاهر میشوند؛ فواصل ویژه به صورت دایرههای کوچک یا نمادهای دیگر ظاهر میشوند. برای هر چیزی در مقیاس بزرگ، از یک اسکریپت استفاده کنید:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
یک نکته مهم که دانستن آن ارزش دارد: پیوندگر صفر-عرض (U+200D) همچنین بخشی مشروع از بسیاری از ایموجیهاست، مانند 🚴♂️. اگر یک مورد درون یک ایموجی قرار دارد، آن را دستنخورده بگذارید.
۲. واترمارکهای آماری: شما نمیتوانید آنها را خودتان بررسی کنید
در متن چیزی برای دیدن وجود ندارد. تنها آشکارساز ارائهدهندهای که کلید مخفی را در اختیار دارد، میتواند مشخص کند که آیا یک بخش دارای واترمارک است یا خیر. تشخیص Anthropic API در پیشنمایش خصوصی برای سازمانهای منتخب است، نه برای عموم. در عمل این بدان معناست که باید فرض کنید: اگر یک مدل واترمارکگذاری آن را نوشته و شما آن را به طور کامل بازنویسی نکردهاید، دارای علامت است.
نحوه حذف واترمارکهای متنی هوش مصنوعی
- حذف کاراکترهای نامرئی. فاصلههای ویژه را با فاصلههای معمولی جایگزین کنید و کاراکترهای صفر-عرض را حذف کنید. ایمن، فوری و بدون افت کیفیت.
- بازنویسی کامل با یک مدل مستقل. ویرایشهای سبک واترمارک آماری را دستنخورده نگه میدارند. بازنویسی کامل که در آن ساختار جمله و انتخاب واژگان در سراسر متن تغییر میکند، این کار را نمیکند. از مدلی استفاده کنید که خروجی خود را واترمارک نمیکند، در غیر این صورت شما فقط یک امضا را با دیگری عوض میکنید.
- انسانیسازی سبک. یک بازنویسی کامل به همراه پرامپت انسانیسازی از راهنمای انسانیسازی متن هوش مصنوعی عبارات کلیشهای و ریتم یکنواختی که آشکارسازها دوست دارند را حذف میکند.
- یک بار دیگر اسکن کنید. قبل از انتشار، بررسی کاراکترها را دوباره اجرا کنید. تنها چند ثانیه زمان میبرد.
مرحله ۱ در کد: پاکسازی کاراکترها
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
مرحله ۲ در کد: بازنویسی کامل از طریق NoTrack API
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content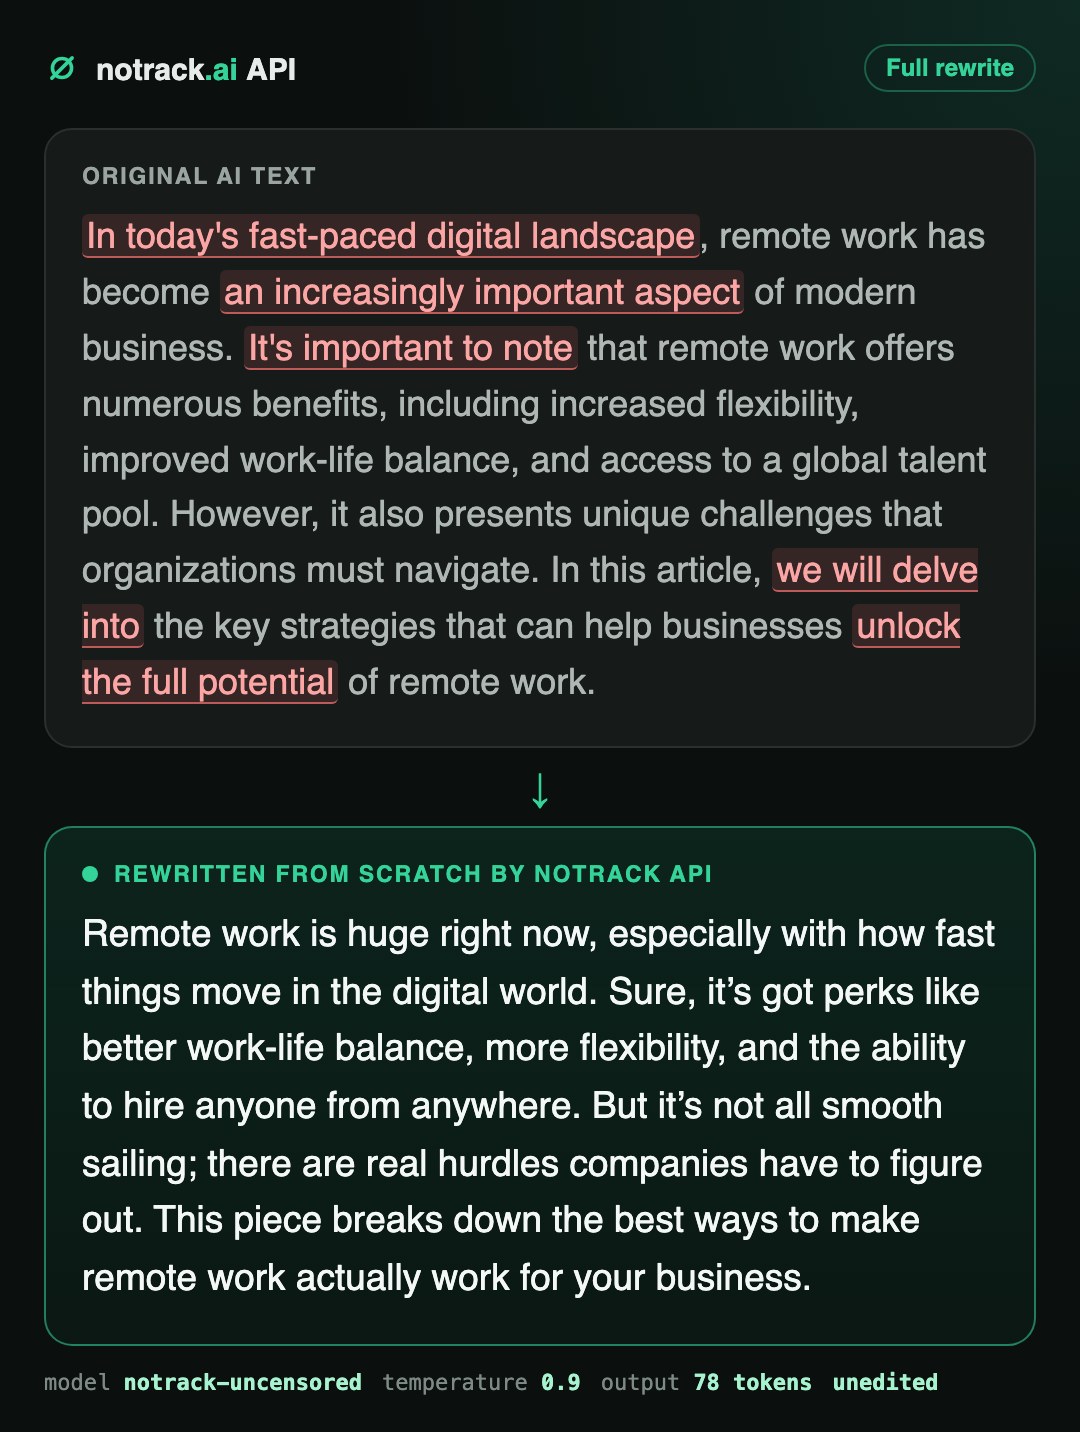
اسناد طولانی را بخش به بخش بازنویسی کنید. این کار کیفیت را بالا نگه میدارد و اطمینان حاصل میکند که هر بخش از متن بازنویسی میشود، نه فقط بخش ابتدایی.
یا به طور کامل از واترمارک صرفنظر کنید
پاکسازی متن پس از وقوع کار میکند. نداشتن چیزی برای پاکسازی بهتر عمل میکند. NoTrack API مدل بیسانسور اختصاصی خود را روی GPUهای خود اجرا میکند. این یک wrapper اطراف OpenAI، Anthropic یا Google نیست، بنابراین هیچ ارائهدهنده بالادستی امضای خود را روی متن شما در حین پردازش نمیزند.
- بدون واترمارک. خروجیهای NoTrack فاقد واترمارک آماری و امضای پروونینس هستند. متن متعلق به شماست و هیچ چیز دیگری به آن پیوسته نیست.
- بدون کاراکترهای پنهان، سنجششده. ما ۲۶ پاسخ NoTrack API را بهطور دقیق اسکن کردیم که حدود ۲۰,۰۰۰ کاراکتر بود تا کاراکترهای فضای خالی نامرئی و کاراکترهای خاص در آنها پیدا شود. خارج از یک ایموجی، شمارش آنها صفر بود.
- بدون لاگ. پرامپتها و پاسخها هرگز روی دیسک نوشته نمیشوند؛ نه توسط دروازه (gateway) و نه توسط سرورهای مدل. ما یک شناسه درخواست و شمارش توکنها را برای صورتحساب نگه میداریم. هیچکس نمیتواند محتوای شما را بعداً جستجو کند.
- بدون فیلتر موضوع. حیات شبانه، قرارهای عاشقانه، بزرگسالان، قمار، ارزهای دیجیتال، داستانهای تاریک: مدل متنها را مینویسد و بازنویسی میکند؛ کارهایی که دستیارهای رایج از انجام آنها خودداری میکنند یا آنها را ملایم میسازند.
- کلید تغییر دو خطی. سازگار با OpenAI. آدرس پایه URL را به
https://api.notrack.ai/v1و کلید API را تغییر دهید و بقیه کد، ابزارها و افزونههای خود را حفظ کنید.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
نوشتن ۱,۰۰۰ مقاله ۸۰۰ کلمهای حدود ۱.۱۰ دلار هزینه توکنهای خروجی دارد. اعتبار رایگان روی اولین کلید شما برای تست کل فرآیند کار قبل از اینکه حتی یک سنت هزینه کنید، کافی است. کلید خود را بسازید یا مستندات API را بخوانید.
سوالات متداول
آیا ChatGPT متن خود را واترمارک میکند؟
تا سپتامبر ۲۰۲۶ خیر. OpenAI تصاویر و فایلهای صوتی تولیدی را علامتگذاری میکند و اعلام کرده که میخواهد قابلیت اثبات اصالت (provenance) را به متنها نیز گسترش دهد. در آوریل ۲۰۲۵ برخی مدلهای ChatGPT کاراکترهای فضای بدون شکست پهن نامرئی تولید میکردند که OpenAI آنها را بهعنوان یک ویژگی آموزشی (quirk) توصیف کرد، نه یک واترمارک.
آیا Claude متن خود را واترمارک میکند؟
بله. Anthropic در اوت ۲۰۲۶ اعلام کرد که مدلهای جدید Claude متنهای دارای واترمارک تولید میکنند و از یک روش آماری مبتنی بر SynthID مالک Google استفاده میشود و مدلهای قدیمیتر نیز در حال بروزرسانی هستند. این واترمارک هیچ کاراکتری اضافه نمیکند؛ بلکه در انتخاب کلمات نهفته است.
آیا Gemini متن خود را واترمارک میکند؟
بله. Google از سال ۲۰۲۴ خروجی متنی Gemini را با استفاده از SynthID واترمارک کرده است.
آیا میتوانم با ویرایش چند کلمه واترمارک را حذف کنم؟
خیر. واترمارکهای آماری حتی پس از ویرایشهای سبک باقی میمانند. خود Anthropic نیز اشاره میکند که بازنویسی کاملی که در آن هر کلمه جایگزین شود، واترمارک را حذف میکند. متن را بهطور کامل با یک مدل دیگر که واترمارک اختصاصی خود را اضافه نمیکند، بازنویسی کنید.
واترمارکربای ChatGPT یا Claude چیست؟
این یک فرآیند دو مرحلهای است: حذف کاراکترهای نامرئی و سپس بازنویسی کامل متن با یک مدل مستقل. قطعهکدهای Python بالا هر دو کار را انجام میدهند و برای بازنویسی از NoTrack API استفاده میکنند.
آیا NoTrack API واترمارک یا کاراکترهای پنهان اضافه میکند؟
خیر. NoTrack مدل اختصاصی خود را روی سختافزار خود اجرا میکند و هیچ واترمارک، امضای اصالت (provenance) یا کاراکتر پنهانی اضافه نمیکند. همچنین پرامپتها یا خروجیهای شما را ذخیره نمیکند.
آیا Google به محتوای تولیدشده توسط هوش مصنوعی جریمه (penalize) اعمال میکند؟
Google اعلام کرده است که به محتوای مفید و باکیفیت، صرفنظر از نحوه تولید آن، پاداش میدهد. واترمارکها برای رتبهبندی اهمیت کمتری دارند و بیشتر برای مخاطبان و پلتفرمهایی که محتوا را به آنها ارائه میدهید، اهمیت دارند.