
2026-cı il avqust ayından etibarən ən böyük AI köməkçilərindən aldığınız mətn artıq sadəcə mətn deyil. Claude və Gemini artıq seçdikləri sözlərdə statistik bir su işarəsi gizlədir və OpenAI mətnin növbəti hədəf olduğunu ChatGPT üçün bəyan edib. Onu görə bilməzsiniz, lakin təminatçı onu yoxlaya bilər və onlar detektoru alan hər kəs də bunu edə bilər. Əgər veb saytlar hazırlayırsınız, müştərilər üçün yazırsınız və ya miqyaslı şəkildə nəşr edirsinizsə, bu, AI ilə yaradılmış mətnin bugünkü vəziyyəti, öz məzmununuzu necə yoxlayacağınız, AI su işarələrini necə ləğv edəcəyiniz və NoTrack API vasitəsilə ilk növbədə təmiz mətnin necə yaradılacağı haqqındadır.
Məzmununuzdakı Görünməz Etiket
2026-cı il avqustun 2-də Avropa İttifaqı AI Aktının (50-ci maddə) şəffaflıq qaydaları tətbiq olunmağa başladı. Bu qaydalar yaradıcı AI təminatçılarından sistemlərinin istehsal etdiyi məhsulları maşınla oxuna bilən şəkildə qeyd etməyi tələb edir ki, bu da AI ilə yaradılmış kimi aşkarlana bilsin. Böyük laboratoriyalar sürətlə hərəkət etdi.
- Anthropic (Claude). 2026-cı il avqustun 14-də Anthropic elan etdi ki, yeni Claude modelləri su işarəsi ehtiva edən mətn yaradır, köhnə modellər isə gələn aylar ərzində yenilənəcək. Tənzimləyici orqanlar, hüquq mühafizə orqanları, medianın, fakt yoxlayıcılar, tədqiqatçılar və təhsil müəssisələri üçün artıq xüsusi ön baxış rejimində bir aşkarlama API mövcuddur.
- Google (Gemini). Gemini 2024-cü ildən bəri mətn çıxışına su işarəsi qoyur SynthID vasitəsilə, Google DeepMind tərəfindən Nature jurnalında dərc edilmiş və 2024-cü ildə açıq mənbə kimi təqdim edilmiş bir metodla. Claude-nın su işarəsi eyni yanaşma üzərində qurulub.
- OpenAI (ChatGPT). OpenAI artıq yaradılmış şəkilləri və səs yazılarını qeyd edir və məzmunun mənşəyini mətnə də genişləndirmək istədiyini bəyan edib. Bildirilir ki, o, daxili olaraq bir mətn su işarəsi qurub, lakin hələ tətbiq etməyib.
Resept soruşan adi istifadəçi üçün bunun heç biri önəmli deyil. Lakin AI ilə köməkçi mətnlər nəşr edən, onları satan və ya müştərilərə təqdim edən hər kəs üçün bu oyunun qaydalarını dəyişir: məzmununuz artıq sizin əlavə etmədiyiniz, görə bilmədiyiniz və söndürə bilmədiyiniz bir imza daşıyır.
İki növ AI Mətn Su Nişanı
"AI su nişanı" ifadəsi iki çox fərqli məna üçün işlənir. Hansı su nişanı ilə məşğul olduğunuzu bilmək, onu necə aradan qaldıracağınızı müəyyən edir.
Görünməz simvollar
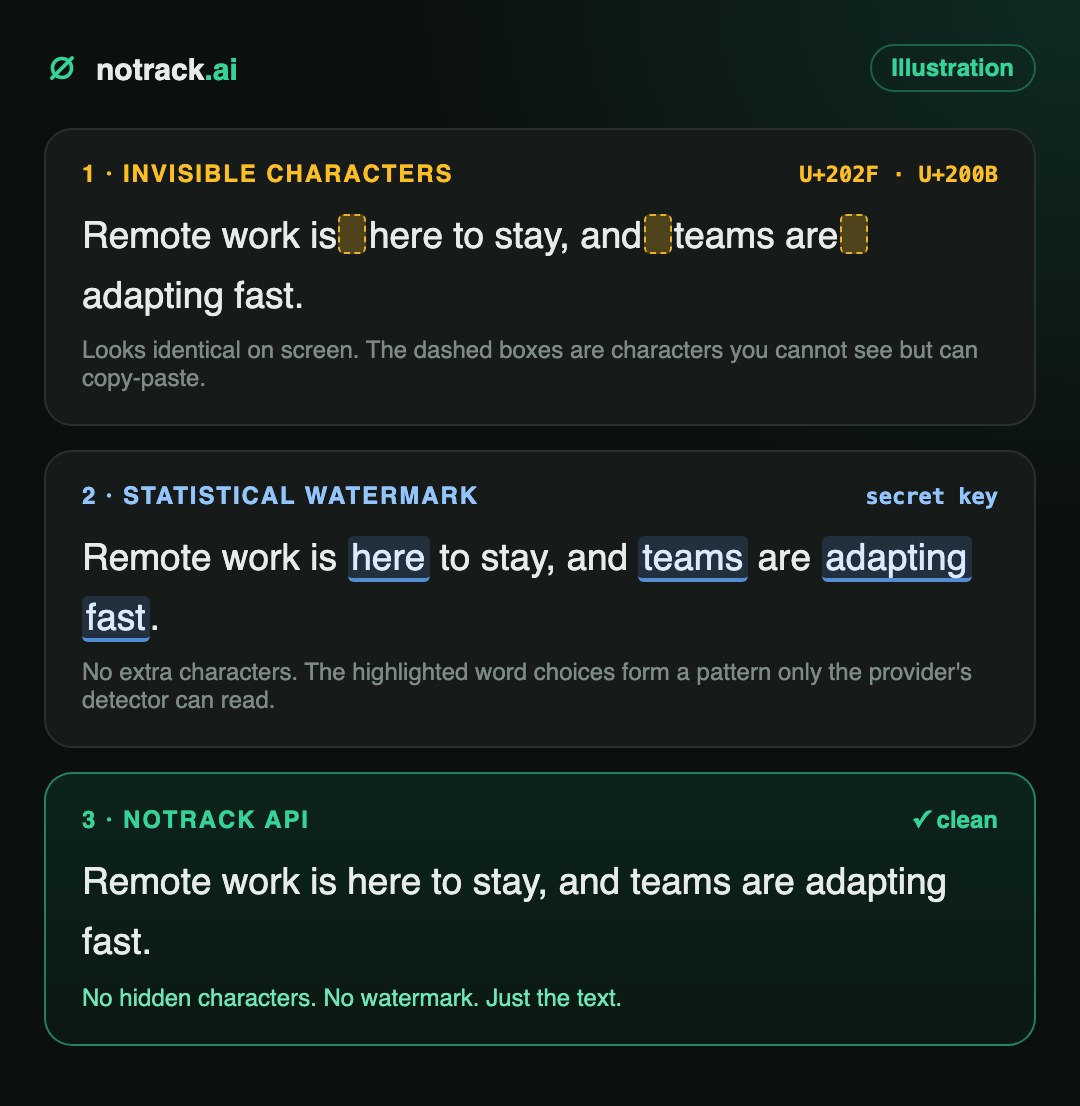
Unicode simvollar adi boşluğa və ya heç nəyə bənzəyir: sıfır enli boşluqlar, söz birləşdiricilər, dar qırılmaz boşluqlar.
- Sadə skript ilə asanlıqla aşkar edilir
- Asanlıqla silinə bilər: onları çıxarmaq və ya əvəz etmək kifayətdir
- Sistemə sükutla zərər verir: axtarış, söz sayları, açar söz uyğunluğu, kod
Statistik su nişanları
Ümumiyyətlə əlavə simvol yoxdur. Modelin söz seçimi gizli açarla idarə olunur və yalnız təminatçının detektoru tərəfindən oxuna bilən bir nümunə yaradır.
- Oxucular və hər hansı mətn redaktoru üçün görünməzdir
- Kopyala-yapışdır və yüngül redaktə zamanı qalır
- Ağır yenidən yazma zamanı zəifləyir; tam yenidən yazma onu aradan qaldırır
Görünməz simvollar: ChatGPT seriyası
2025-ci ilin aprel ayında tədqiqatçılar fərq etdilər ki, OpenAI-in o vaxt yeni olan o3 və o4-mini modellərindən olan mətnlərdə normal boşluq yerləşməli olan yerdə dar sınılmaz boşluqlar (U+202F) var. Formatlaşdırma nişanları aktiv edilmiş vəziyyətdə Word-də yapışdırıldıqda, onlar nöqtə əvəzinə kiçik dairələr kimi görünür. OpenAI bu simvolların böyük miqyaslı gücləndirici öyrənmənin xüsusiyyəti olduğunu, məqsədli suşun olmadığını bildirdi və daha sonra bu simvolların görünməsi dayandı. Dərs qaldı: AI mətni heç vaxt görmədiyiniz simvollar daşıya bilər və bu simvollar CMS-ə hər yapışdırma zamanı da daşınır.
Statistik suşunlar: SynthID və Claude
Dil modeli hər növbəti sözü çoxluqdan seçir, bir az təsadüfiliklə. Statistik suşun bu təsadüfilikləri gizli açarla toxumlanmış yalan-təsadüfi seçimlə əvəz edir. Oxucu üçün mətn tamamilə normal görünür. Açarı əlində tutan biri üçün uzun bir parça sözlərin seçilməsi nümunəsi göstərir ki, bu nümunə təsadüfən baş verməzdi.
Claude tərəfindən seçilən sözlər hələ də təsadüfidir, lakin indi sözlərin ardıcıllığını yoxlayıb, Claude-ın açardan istifadə etsəydi, bu seçimləri edə biləcəyini görə bilərsiniz.
Anthropic, Claude-ın mətn suşunlaşdırma necə işləyir (avqust 2026)
Nəşriyyatçılar üçün iki detal əhəmiyyətlidir. Suşun mətnin uzunluğu ilə güclənir və Anthropic-ə görə, yüngül redaktə onu aradan qaldırmır, hər sözün əvəz olunduğu tam yenidən yazma isə aradan qaldırır.
Kim AI mətnini suşunlayır (sentyabr 2026)
| Təminatçı | Mətn suşunu | Növ | Kim yoxlaya bilər |
|---|---|---|---|
| Google Gemini | Bəli, 2024-cü ildən bəri | Statistik (SynthID) | Google-in SynthID alətləri |
| Anthropic Claude | Bəli, avqust 2026-cı ildən sonra yeni modellər | Statistik (SynthID əsaslı) | Anthropic aşkarlama API, tənzimləyici orqanlar, media, təhsil işçiləri və tədqiqatçılar üçün xüsusi ilkin baxış |
| OpenAI ChatGPT | Hələ mətnlər üçün deyil; şəkillər və səs artıq nişanlanıb | Mətn mənşəyinin müəyyən edilməsi məqsəd kimi elan edilib | OpenAI alət (şəkillər və səs üçün bu gün) |
| NoTrack API | Xeyr | Su işarəsi yoxdur, gizli simvollar yoxdur | Heç kim |
Niyə Su İşarəli Məzmun Yaratmaçılara Zərər Vurur
Google illərdir deyir ki, o, məzmunu onun harada yaradılmasından çox keyfiyyətinə görə reytinqləşdirir. Problem isə zəncirin digər üzvlərindədir.
- Müştəriləriniz bunu yoxlaya bilər. Agentliklər və frilanserlər məzmunu ödənişdən əvvəl getdikcə daha çox süni intellekt yoxlamalarından keçirən insanlara təqdim edir. Su işarəsi "süni intellekt köməyi ilə hazırlanmış və diqqətlə redaktə olunmuş" məzmunu nüanslara yer qoymadan "şübhəli" kimi qeyd edir.
- Platformalar və bazar yerləri yoxlayır. Nəşr platformaları, frilanser bazar yerləri, reklam şəbəkələri və rəy saytları süni intellekt aşkarlamasını tətbiq edir. Aşkarlanabilən imza süzgəcdən keçirmək üçün ən asan məsələdir.
- Bu, iş axınınızı ortaya çıxarır. Su işarəsi istənilən detektora malik olana məzmunun hansı alət tərəfindən yazıldığını göstərir. Məzmun biznesi üçün bu, nəşr etməyə razılaşmadığınız rəqabət məlumatıdır.
- Bu, mətnin hər yerində onu izləyir. Yenidən nəşr olunan, yüngülcə tərcümə edilən və ya yenidən yerləşdirilən su işarəli mətn imzasını saxlayır. Görmədiyiniz şeyi audit edə bilməzsiniz.
- Gizli simvollar problemlər yaradır. Görünməz Unicode veb-sayt axtarışını, dəqiq uyğunluq açar sözlərini, söz sayını, yoxlayıcıları və yapıştırdığınız istənilən kodu sükutla pozur. O, eyni görünən iki səhifənin bayt-bayt fərqli olmasına səbəb də ola bilər.
Mətninizin süni intellekt su işarələri üçün necə yoxlanılması
1. Gizli simvollar: saniyələr içində yoxlayın
Sürətli əl testi: mətni Microsoft Word-ə yapışdırın və formatlaşdırma nişanlarını göstərmək üçün Ctrl+Shift+8 (Mac-də Cmd+8) düyməsini basın. Adi boşluqlar nöqtə kimi görünür; xüsusi boşluqlar isə kiçik dairələr və ya digər simvollar kimi görünür. Hər hansı miqyasda iş üçün skript istifadə edin:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
Bilməyə dəyər bir nüans: sıfır-enli birləşdirici (U+200D) həmçinin 🚴♂️ kimi bir çox emojinin qanuni tərkib hissəsidir. Əgər bir hit (tapıntı) emojinin daxilindədirsə, onu dəyişdirməyin.
2. Statistiki su nişanları: onları özünüz yoxlaya bilməzsiniz
Mətndə heç nə görmək olmaz. Yalnız sirr açarını saxlayan təminatçının detektoru mətnin su nişanı ilə işarələndiyini deyə bilər. Anthropic-in deteksiya APIi seçilmiş təşkilatlar üçün xüsusi önizləmə rejimindədir, ictimaiyyət üçün deyil. Praktiki olaraq bu o deməkdir ki: əgər su nişanı modeli onu yazdıbsa və siz tamamilə yenidən yazmamısınızsa, o, işarələnmiş sayılır.
Mətnin AI su nişanlarını necə aradan qaldırmaq olar
- Görünməz simvolları təmizləyin. Xüsusi boşluqları adi boşluqlarla əvəz edin və sıfır-enli simvolları silin. Təhlükəsiz, dərhal və itki olmadan həyata keçirilir.
- Müstəqil model ilə tamamilə yenidən yazın. Yüngül redaktələr statistik su nişanını saxlayır. Cümlə quruluşunu və söz seçimini bütövlükdə dəyişdirən tam yenidən yazma isə saxlamır. Öz çıxışını su nişanı ilə işarələməyən modeldən istifadə edin, əks halda siz sadəcə bir imzanı digəri ilə dəyişmiş olarsınız.
- Üslubu insaniləşdirin. Tam yenidən yazma və bizim AI mətnini insaniləşdirmə bələdçimizdəki humanizer (insaniləşdirici) promptu detektorların sevdiyi standart ifadələri və monoton ritmi aradan qaldırır.
- Yenidən skan edin. Nəşr etməzdən əvvəl simvol yoxlamasını bir daha işə salın. Bu, bir neçə saniyə vaxt aparır.
Koddakı 1-ci addım: simvolları təmizləyin
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Koddakı 2-ci addım: NoTrack API ilə tam yenidən yazma
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content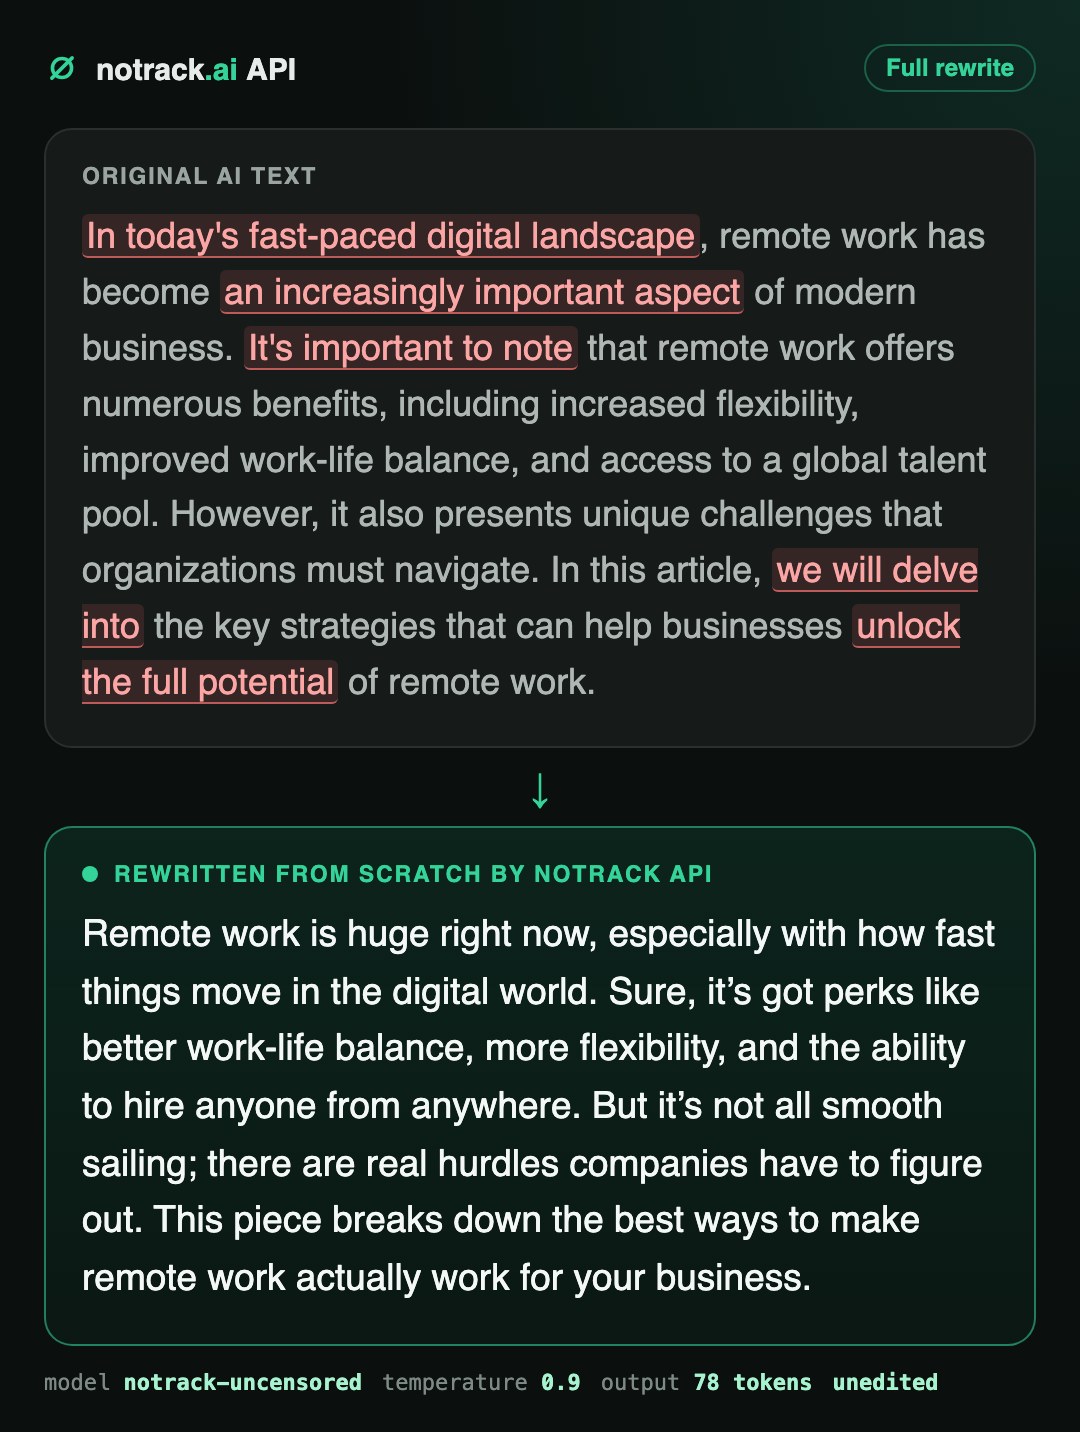
Uzun sənədləri bölmələr üzrə yenidən yazın. Bu, keyfiyyəti yüksək saxlayır və mətnin hər hissəsinin, sadəcə başlanğıcının deyil, yenidən yazıldığını təmin edir.
Və ya Su Nişanını Tamamilə Atlayın
Mətni sonradan təmizləmək işləyir. Təmizləmək üçün heç nənin olmaması daha yaxşı işləyir. NoTrack API öz qeyd-şərtsiz modelini öz GPU-larında işlədir. Bu, OpenAI, Anthropic və ya Google ətrafında qabıqdır, ona görə də yuxarı axın təminatçısı mətniniz keçərkən öz imzasını vurmur.
- Su nişanı yoxdur. NoTrack çıxışı statistik su nişanı da, mənşə imzası da daşımayıb. Mətn sizin üçündür, ona başqa heç nə yapışdırılmayıb.
- Gizli simvollar yoxdur, ölçülüb. 26 NoTrack API cavabı, təxminən 20.000 simvol həcmində, sıfır genişlikli və xüsusi boşluq simvolları üçün yoxlanıldı. Bir emojidən kənarda say sıfır idi.
- Gizli rejim. Sorğular və cavablar heç vaxt diskə yazılmır, nə qapı serveri tərəfindən, nə də model serverləri tərəfindən. Biz yalnız hesablaşma üçün sorğu ID-sini və token saylarını saxlayırıq. Heç kim məlumatlarınızı sonradan axtara bilməz.
- Mövzu filtri yoxdur. Gece həyatı, tanışlıq, yetkinlər, qumar, kriptovalyuta, qaranlıq ədəbiyyat: model əsasən digər köməkçilərin rədd etdiyi və ya yumşaltdığı məzmunu yazır və yenidən yazır.
- İki sətirlik keçid. OpenAI ilə uyğun. Əsas URL-i
https://api.notrack.ai/v1olaraq dəyişin və açarı yeniləyin, kodunuzun, alətlərinizlə və plaginlərinizin qalan hissəsini olduğu kimi saxlayın.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
800 söz uzunluğunda 1.000 məqalə yazmaq təxminən $1.10 dəyərində çıxış tokenləri tələb edir. İlk açarınızdakı pulsuz kredit, bir qəpik xərcləməzdən əvvəl bütün iş axınını sınaqdan keçirmək üçün kifayət edir. Açarınızı yaradın və ya API sənədlərinə baxın.
Tez-tez verilən suallar
ChatGPT mətnini vatermarklayır?
2026-cı il sentyabr ayına olan vəziyyətdə xeyr. OpenAI yaradılan şəkilləri və səs fayllarını vatermarklayır və vatermarkın mətnə də tətbiq edilməsini istədiyini bildirib. 2025-ci il aprelin bəzi ChatGPT modelləri görünməz dar boşluqlar (no-break spaces) yaratmışdı ki, OpenAI bunu vatermark deyil, təlim prosesinə aid xüsusiyyət kimi xarakterizə etdi.
Claude mətnini vatermarklayır?
Bəli. Anthropic 2026-cı il avqust ayında elan etdi ki, yeni Claude modelləri Google-in SynthID metoduna əsaslanan statistik üsulla vatermarklanmış mətn yaradır və köhnə modellər yenilənir. Vatermark heç bir simvol əlavə etmir; o, söz seçimlərində gizlənir.
Gemini mətnini vatermarklayır?
Bəli. Google 2024-cü ildən bəri Gemini mətn çıxışını SynthID ilə vatermarklayır.
Bir neçə söz redaktə edərək vatermarkı aradan qaldıra bilərəmmi?
Xeyr. Statistik vatermarklar yüngül redaktəyə tabe gəlmir. Anthropic öz növbəsində qeyd edir ki, hər bir sözün əvəz olunduğu tam yenidən yazma vatermarkı aradan qaldırır. Vatermark əlavə etməyən model ilə mətni tamamilə yenidən yazın.
ChatGPT və ya Claude vatermark siləni nədir?
Bu, iki mərhələli prosesdir: görünməz simvolları silmək və sonra mətni müstəqil model ilə tamamilə yenidən yazmaq. Yuxarıdakı Python nümunələrinin hər ikisini yerinə yetirir və yenidən yazma üçün NoTrack API-dan istifadə edir.
NoTrack API vatermark və ya gizli simvollar əlavə edir?
Xeyr. NoTrack öz modelini öz avadanlığında işlədir və vatermark, mənşaq imzası və ya gizli simvollar əlavə etmir. O, həmçinin sorğularınızı və çıxışlarınızı saxlamır.
Google AI ilə yaradılan məzmunu cərimələyirmi?
Google bildirib ki, məzmunun istehsal üsulundan asılı olmayaraq, faydalı və yüksək keyfiyyətli məzunu mükafatlandırır. Vatermarklar sıralamada daha az, məzmunu təqdim etdiyiniz insanlar və platformalar üçün daha çox əhəmiyyət kəsb edir.