
၂၀၂၆ ခုနှစ် ဩဂုတ်လမှစ၍ ကြီးမားသော AI အကူအညီများမှ ရရှိသော စာသားသည် စာသားသက်သက်သာ မဟုတေတော့ပါ။ Claude နှင့် Gemini တို့သည် ၎င်းတို့ ရွေးချယ်သော စကားလုံးများထဲတွင် စာရင်းအင်းဆိုင်ရာ watermark တစ်ခုကို လျှို့ဝှက်ထားပြီး OpenAI သည် စာသားသည် ChatGPT အတွက် နောက်ထပ် အဆင့်ဖြစ်ကြောင်း ပြောဆိုထားသည်။ ၎င်းကို မျက်စိဖြင့် မမြင်နိုင်သော်လည်း ပေးပို့သူက ၎င်းကို စစ်ဆေးနိုင်ပြီး၊ detector ကို ပေးလိုက်သူ မည်သူမဆို စစ်ဆေးနိုင်သည်။ သင်သည် website များ တည်ဆောက်သူ၊ ဖောက်သည်များအတွက် စာရေးသူ သို့မဟုတ် စကေးကြီးစွာဖြင့် ထုတ်ဝေသူ ဖြစ်ပါက AI စာသားထုတ်လုပ်မှုထဲတွင် ယနေ့ခေတ်တွင် ဘာများ ပါဝင်သည်၊ သင့် content ကိုယ်တိုင်ကို မည်သို့စစ်ဆေးသည်၊ AI watermark များကို မည်သို့ဖယ်ရှားသည်၊ နှင့် NoTrack API ကို အသုံးပြု၍ watermark မပါဝင်သော စာသားသန့်သန့်ကို မည်သို့ထုတ်လုပ်သည်။
သင့် content ပေါ်ရှိ မမြင်နိုင်သော လက္ခဏာ
၂၀၂၆ ခုနှစ် ဩဂုတ်လ ၂ ရက်နေ့တွင် EU AI Act (Article 50) ၏ transparency စည်းမျဉ်းများ အသုံးပြုလာခဲ့သည်။ ၎င်းတို့သည် generative AI ပေးပို့သူများကို ၎င်းတို့၏ စနစ်များ ထုတ်လုပ်သော အရာများကို မျက်နှာပြင်ပေါ်တွင် မမြင်နိုင်သော နည်းလမ်းဖြင့် သတ်မှတ်ရန် လိုအပ်ပြီး၊ ၎င်းကို AI ထုတ်လုပ်မှုဖြစ်ကြောင်း စစ်ဆေးနိုင်ရန် ဖြစ်သည်။ ကြီးမားသော လက်တွေ့လုပ်ငန်းများသည် မြန်မြန်ဆန်ဆန် ရွေ့လျားခဲ့သည်။
- Anthropic (Claude). ၂၀၂၆ ခုနှစ် ဩဂုတ်လ ၁၄ ရက်နေ့တွင် Anthropic ကြေညာခဲ့သည်။ Claude မော်ဒယ်အသစ်များသည် watermark ပါဝင်သော စာသားကို ထုတ်လုပ်ပြီး၊ ယခင်မော်ဒယ်များကို နောက်ပိုင်းလများအတွင်း အပ်ဒိတ်ပြုလုပ်ခဲ့သည်။ detection API သည် စည်းမျဉ်းထိန်းသိမ်းရေး၊ ဥပဒေအာဏာပိုင်များ၊ မီဒီယာ၊ အချက်အလက်စစ်ဆေးသူများ၊ သုတေသီများနှင့် ပညာရေးအဖွဲ့အစည်းများအတွက် ကန့်သတ်ချက်ဖြင့် စမ်းသုံးနေဆဲဖြစ်သည်။
- Google (Gemini). Gemini သည် ၂၀၂၄ ခုနှစ်မှစ၍ ၎င်း၏ စာသားထုတ်လုပ်မှုများကို SynthID ဖြင့် watermark ထည့်သွင်းထားပြီး၊ Google DeepMind သည် Nature တွင် ထုတ်ဝေခဲ့ပြီး ၂၀၂၄ ခုနှစ်တွင် open-source ပြုလုပ်ခဲ့သည်။ Claude ၏ watermark သည် အတူတူပင် ချဉ်းကပ်မှုပေါ်တွင် အဆောက်အအုံဆောက်ထားသည်။
- OpenAI (ChatGPT). OpenAI သည် ထုတ်လုပ်ထားသော ဓာတ်ပုံများနှင့် အသံများကို ယခင်က သတ်မှတ်ထားပြီး content provenance ကို စာသားအထိ ချဲ့ထွင်လိုကြောင်း ပြောဆိုထားသည်။ ၎င်းသည် စာသား watermark ကို အတွင်းပိုင်းတွင် တည်ဆောက်ထားသော်လည်း အသုံးပြုမှုအဆင့်သို့ မရောက်သေးပါ။
ချက်နည်းတစ်ခုခုကို မေးမြန်းလိုသော အသုံးပြုသူများအတွက် ဤအချက်များသည် အရေးမပါပါ။ သို့သော် AI ကူညီရေးဖြင့် ရေးသားထားသော စာသားများကို ဖြန့်ချိသူများ၊ ဝယ်ယူရောင်းချသူများ သို့မဟုတ် လုပ်ငန်းရှင်များထံ ပေးအပ်သူများအတွက်မူ ဤအချက်သည် ကစားပွဲကို ပြောင်းလဲစေသည် - သင့်၏ စာသားများသည် သင်ထည့်သွင်းထားခြင်း မဟုတ်၊ မြင်တွေ့ရခြင်း မရှိ၊ ပိတ်ပင်ရန် မရနိုင်သော လက်မှတ်တစ်ခုကို ပိုင်းခြားသတ်မှတ်ထားသည်။
AI စာသား ရေစိုင်းချက် နှစ်မျိုး
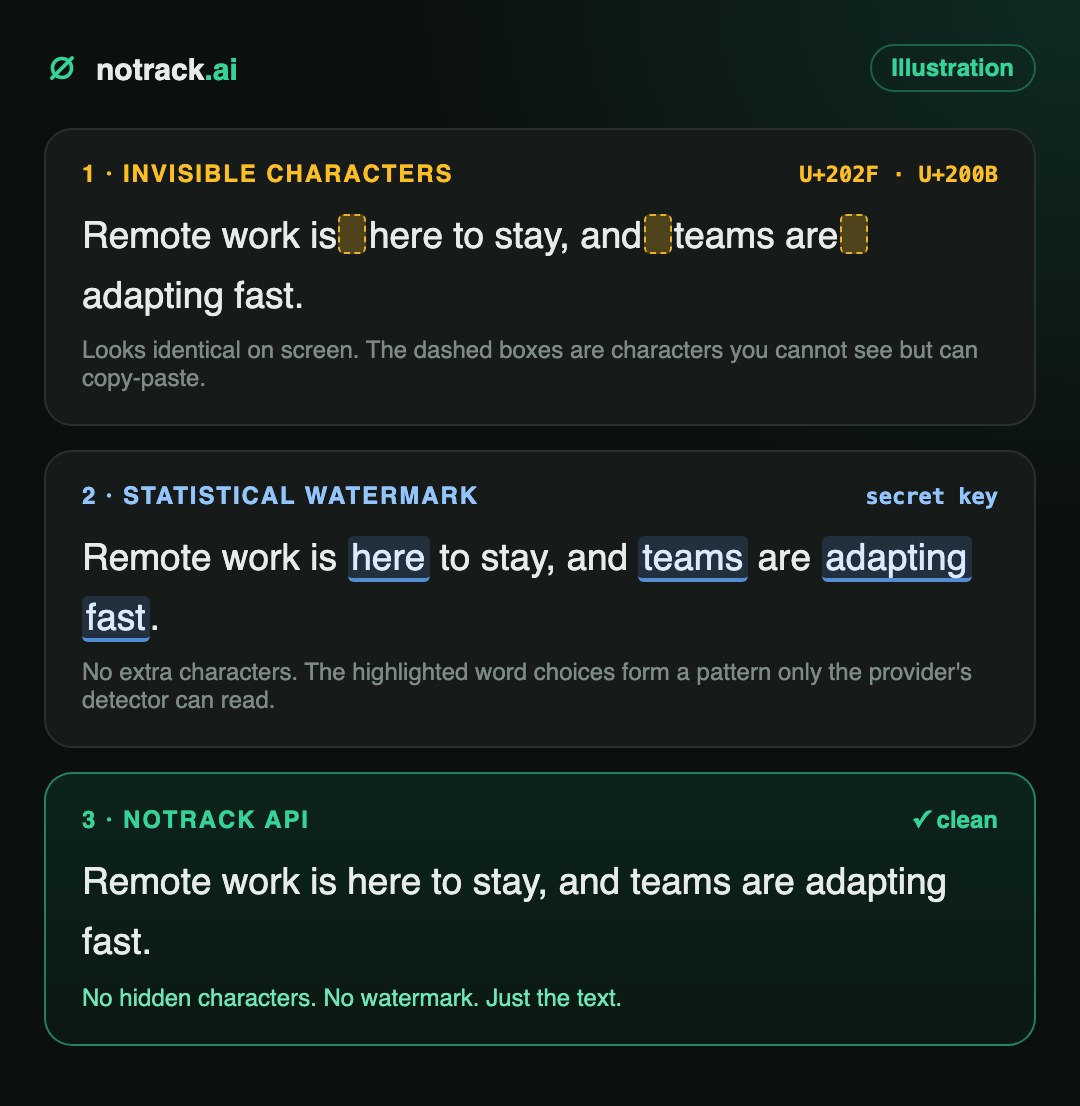
"AI ရေစိုင်းချက်" ဟူသော စကားလုံးသည် အလွန်ကွဲပြားသော အဓိပ္ပာယ်နှစ်မျိုးဖြင့် အသုံးပြုခံရသည်။ မည်သည့်အမျိုးအစားနှင့် သင်ဆက်ဆံနေသည်ကို သိရှိခြင်းသည် ၎င်းကို ဖယ်ရှားနည်းကို ဆုံးဖြတ်ပေးသည်။
မြင်သာသော စာလုံးများ
Unicode စာလုံးများသည် ပုံမှန်နေရာလွတ် သို့မဟုတ် လုံးဝမရှိသော အရာကဲ့သို့ ပြသသည် - သုညအနက်ရှိနေရာလွတ်များ၊ စာလုံးပေါင်းဆက်သွယ်သည့်နေရာလွတ်များ၊ ကျဉ်းမြောင်းသော ခွဲမရသောနေရာလွတ်များ။
- ရိုးရှင်းသော စကားလုံးရှာဖွေရေးဖြင့် လွယ်ကူစွာ ခွဲခြားနိုင်သည်
- ဖယ်ရှားရန် လွယ်ကူသည် - ဖယ်ရှားပါ သို့မဟုတ် အစားထိုးပါ
- အရာများကို တိတ်ဆိတ်စွာ ဖျက်ဆီးသည် - ရှာဖွေရေး၊ စာလုံးရေတွက်ခြင်း၊ စာလုံးအသုံးအများဆုံးရှာဖွေခြင်း၊ ကုဒ်
စာရင်းအင်း ရေစိုင်းချက်များ
အပိုစာလုံးများ လုံးဝမပါပါ။ မော်ဒယ်၏ စာလုံးရွေးချယ်မှုများသည် လျှို့ဝှက်သော အချက်အလက်ဖြင့် လမ်းညွှန်ထားပြီး၊ ပေးပို့သူ၏ ခွဲခြမ်းစိတ်ဖြာသူသာ ဖတ်ရှုနိုင်သော ပုံစံတစ်ခုကို ဖြစ်ပေါ်စေသည်။
- ဖတ်ရှုသူများနှင့် မည်သည့်စာသားတည်းဖြတ်သူမှ မမြင်နိုင်ပါ
- ကူးယူ-ထည့်သွင်းခြင်းနှင့် အလွယ်တကူ တည်းဖြတ်ခြင်းကို ခံနိုင်ရည်ရှိသည်
- ပြန်ရေးမှုများပြားလာလျှင် အားနည်းသွားသည်; အပြည့်အဝ ပြန်ရေးလိုက်ပါက ဖယ်ရှားသွားသည်
မြင်သာမည့် အက္ခရာများ: ChatGPT ပိုဒ်တစ်ခု
၂၀၂၅ ခုနှစ် ဧပြီလတွင် သုတေသီများသည် OpenAI ၏ ထိုခေတ်က o3 နှင့် o4-mini မော်ဒယ်များမှ စာသားများတွင် ပုံမှန် နေရာလွတ် ဖြစ်သင့်သော နေရာများတွင် ကျဉ်းမြောင်းသော ခွဲမထိခိုက်သည့် နေရာလွတ်များ (U+202F) ပါဝင်နေသည်ကို တွေ့ရှိခဲ့ကြသည်။ ပုံစံပြသချက်များကို ဖွင့်ထားသော Word တွင် ကူးယူထည့်သွင်းလိုက်သောအခါ ၎င်းတို့သည် အမှတ်စေ့များအစား သေးငယ်သော စက်ဝိုင်းများအဖြစ် ပေါ်လာခဲ့သည်။ OpenAI က ဤအက္ခရာများသည် ကြီးမားသော reinforcement learning ၏ သဘာဝအလျောက် ဖြစ်ပေါ်လာသော အမှားအယွင်းတစ်ခုသာဖြစ်ပြီး သတင်းပေးအက္ခရာ (watermark) ရည်ရွယ်ချက်ဖြင့် ထည့်သွင်းထားခြင်း မဟုတ်ကြောင်း၊ နောက်ပိုင်းတွင် ဤအက္ခရာများ ပျောက်ကွယ်သွားကြောင်း ပြောကြားခဲ့သည်။ သို့သော် သင်ခန်းစာကတော့ ကျန်ရှိနေခဲ့သည် - AI စာသားများသည် မိမိတို့ မမြင်တွေ့ရသော အက္ခရာများကို သယ်ဆောင်လာနိုင်ပြီး ၎င်းတို့သည် မိမိတို့၏ CMS ထဲသို့ ကူးယူထည့်သွင်းလိုက်သည့် နေရာတိုင်းတွင် ခရီးထွက်လာနိုင်သည်။
စာရင်းအင်းဆိုင်ရာ သတင်းပေးအက္ခရာများ: SynthID နှင့် Claude
စာသားပုံစံစနစ်တစ်ခုသည် ဖြစ်နိုင်ခြေရှိသော နောက်ထပ်စကားလုံးများစွာထဲမှ နောက်ဆုံးစကားလုံးတစ်လုံးကို ရွေးချယ်ရန် ကြိုးစားသည်၊ ဤနေရာတွင် အနည်းငယ်သော ကျပန်းသဘောတရား ပါဝင်သည်။ စာရင်းအင်းဆိုင်ရာ သတင်းပေးအက္ခရာသည် ဤကျပန်းသဘောတရားကို လျှို့ဝှက်သော ကီး (key) ဖြင့် seed ပေးထားသော pseudo-random ရွေးချယ်မှုဖြင့် အစားထိုးသည်။ ဖတ်ရှုသူတစ်ဦးအတွက် စာသားသည် အလွန်သာမာန်ဖြစ်နေသည်။ သို့သော် ကီးကို လက်ဆောင်ယူထားသူတစ်ဦးအတွက် ရှည်လျားသော စာသားတစ်ပိုဒ်သည် ကျပန်းဖြစ်နိုင်ခြေနည်းပါးသော စကားလုံးရွေးချယ်မှုများ၏ ပုံစံတစ်ခုကို ပြသလိမ့်မည်။
Claude ရွေးချယ်သော စကားလုံးများသည် ကျပန်းဖြစ်နေဆဲဖြစ်သော်လည်း၊ ယခုအခါ စကားလုံးများ၏ အစီအစဉ်ကို စစ်ဆေးနိုင်ပြီး ၎င်းသည် Claude က ကီးကို အသုံးပြုနေပါက ပြုလုပ်လိမ့်မည့် ရွေးချယ်မှုများနှင့် ကိုက်ညီမှုရှိမရှိ ကြည့်ရှုနိုင်သည်။
Anthropic, Claude ၏ စာသား သတင်းပေးအက္ခရာ လုပ်ဆောင်ပုံ (၂၀၂၆ ခုနှစ် ဩဂုတ်လ)
ထုတ်လုပ်သူများအတွက် အရေးကြီးသော အချက်နှစ်ချက်ရှိသည်။ စာသားရှည်လေလေ၊ သတင်းပေးအက္ခရာ ပိုမိုပြင်းထန်လေလေဖြစ်ပြီး၊ Anthropic အရ အလွယ်တကူ ပြင်ဆင်ခြင်းသည် ၎င်းကို ဖယ်ရှားမပေးနိုင်သော်လည်း၊ စကားလုံးတိုင်းကို အစားထိုးလိုက်သော အပြည့်အဝ ပြန်ရေးခြင်းသည် ဖယ်ရှားပေးနိုင်သည်။
AI စာသားများကို ဘယ်သူတွေ သတင်းပေးအက္ခရာ ထည့်ကြသလဲ (၂၀၂၆ ခုနှစ် စက်တင်ဘာလ)
| ပေးပို့သူ | စာသား သတင်းပေးအက္ခရာ | အမျိုးအစား | ဘယ်သူတွေ စစ်ဆေးနိုင်သလဲ |
|---|---|---|---|
| Google Gemini | ဟုတ်ကဲ့၊ ၂၀၂၄ ခုနှစ်မှစပြီး | စာရင်းအင်း (SynthID) | Google ၏ SynthID ကိရိယာများ |
| Anthropic Claude | ဟုတ်ကဲ့၊ ၂၀၂၆ ခုနှစ် ဩဂုတ်လမှစ၍ မော်ဒယ်အသစ်များ | စာရင်းအင်းဆိုင်ရာ (SynthID-ပေါ် မူတည်သော) | Anthropic ခွဲခြားသတ်မှတ်ခြင်း API၊ စည်းကမ်းထိန်းသိမ်းရေးအဖွဲ့များ၊ သတင်းမီဒီယာ၊ ပညာရေးနှင့် သုတေသီများအတွက် ပုဂ္ဂိုလ်ရေး စမ်းသုံးပြသခြင်း |
| OpenAI ChatGPT | စာသားများအတွက် ယခုအချိန်အထိ မရှိသေးပါ; ဓာတ်ပုံများနှင့် အသံများကို အမှတ်အသားပြုပြီးသားဖြစ်သည် | စာသား မူလအရင်းအမြစ် သတ်မှတ်ခြင်းကို ရည်မှန်းချာအဖြစ် ကြေညာခဲ့သည် | OpenAI ကိရိယာများ (ဓာတ်ပုံများနှင့် အသံများ ယနေ့အချိန်တွင်) |
| NoTrack API | မဟုတ်ပါ | အမှတ်အသားမပါ၊ ချုပ်ထားသော စာလုံးများ မပါ | ဘယ်သူမှမဟုတ် |
အမှတ်အသားပါ စာသားများသည် မာလ်တီမီဒီယာ ထုတ်လုပ်သူများကို ဘယ်လို နစ်နာစေသနည်း
Google သည် အကြောင်းအရာများကို မည်သို့ဖန်တီးထားသည်ဆိုသည့်အပေါ်မူတည်ပြီးမဟုတ်ဘဲ အရည်အသွေးအပေါ်အခြေခံ၍ တန်ဖိုးထားကြောင်း နှစ်ပေါင်းများစွာ ပြောဆိုလာခဲ့သည်။ ပြဿနာမှာ အခြားသူများဖြစ်သည်။
- သင့်ဖောက်သည်များ စစ်ဆေးနိုင်သည်။ ေအဂျင်စီများနှင့် လွတ်လပ်အလုပ်သမားများသည် AI စစ်ဆေးမှုများ ပိုမိုပြုလုပ်လာသည့် လူများထံ စာသားများ ပေးပို့ကြသည်။ Watermark တစ်ခုက "AI ကူညီရေးသားပြီး သတင်းအချက်အလက်များဖြင့် တည်းဖြတ်ထားသည်" ဆိုသည့်အရာကို "အရေးယူမိ" ဟု ပြောင်းလဲစေပြီး ရှင်းလင်းချက်များကို ခွင့်မပြုပါ။
- ပလက်ဖောင်းများနှင့် ဈေးကွက်များ စစ်ဆေးကြသည်။ ထုတ်ဝေရေးပလက်ဖောင်းများ၊ လွတ်လပ်အလုပ်သမား ဈေးကွက်များ၊ ကြော်ငြာကွန်ရက်များနှင့် သုံးသပ်ရေးစာမျက်နှာများသည် AI စစ်ဆေးမှုများကို ထည့်သွင်းလာကြသည်။ ခံစားနိုင်သော လက္ခဏာသည် စစ်ထုတ်ရန် အလွယ်ကူဆုံးအရာဖြစ်သည်။
- သင့်လုပ်ငန်းစဉ်ကို ဖော်ပြပေးသည်။ Watermark တစ်ခုသည် စစ်ဆေးသူတိုင်းကို သင့်အကြောင်းအရာကို မည်သောကိရိယာဖြင့် ရေးသားခဲ့သည်ကို ပြသသည်။ အကြောင်းအရာလုပ်ငန်းတစ်ခုအတွက် ၎င်းသည် သင် ခွင့်ပြုခဲ့ခြင်းမရှိသော ပြိုင်ဖက်အချက်အလက်ဖြစ်သည်။
- စာသားတိုင်းတွင် လိုက်ပါသည်။ ပြန်လည်ထုတ်ဝေခြင်း၊ ဘာသာပြန်ခြင်း သို့မဟုတ် ပြန်လည်ထည့်သွင်းခြင်းများတွင် watermark ပါသော စာသားသည် ၎င်း၏ လက္ခဏာကို ထိန်းထားသည်။ မြင်နိုင်သောအရာကိုသာ စစ်ဆေးနိုင်သည်။
- ဝှက်ထားသော အက္ခရာများသည် ပြဿနာများကို ဖြစ်စေသည်။ မမြင်နိုင်သော Unicode သည် ဝက်ဘ်ဆိုက်အတွင်း ရှာဖွေခြင်း၊ တိကျသော စကားလုံးများ၊ စာလုံးရေများ၊ စာလုံးပေါင်းစစ်ဆေးခြင်းနှင့် သင် ထည့်သွင်းသော ကုဒ်အားလုံးကို တိတ်တဆိတ် ဖျက်ဆီးပေးသည်။ ၎င်းသည် အတူတူပင်ဖြစ်သော စာမျက်နှာနှစ်ခုကို byte တစ်ခုချင်းစီဖြင့် ကွဲပြားစေနိုင်သည်။
သင့်စာသားများတွင် AI Watermark များ ရှိ/မရှိ စစ်ဆေးနည်း
၁။ မမြင်နိုင်သော အက္ခရာများ: စက္ကန့်အနည်းငယ်အတွင်း စစ်ဆေးပါ
လက်တွေ့စမ်းသပ်နည်း: စာသားကို Microsoft Word ထဲသို့ ကူးယူထည့်ပြီး Ctrl+Shift+8 (Mac တွင် Cmd+8) ကို နှိပ်ကာ ပုံစံဖွဲ့စည်းမှုလက္ခဏာများကို ပြသပါ။ သာမန် ခြားနားချက်များသည် အမှတ်အသားများအဖြစ် ပေါ်လာပြီး၊ သီးသန့် ခြားနားချက်များသည် အနည်းငယ်သာ ပေါ်လာသည် သို့မဟုတ် အခြားသော သင်္ကေတများအဖြစ် ပေါ်လာသည်။ စကေးကြီးသည့်အတွက် စကရစ်ပ်တစ်ခုကို အသုံးပြုပါ:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
သိထားသင့်သော အချက်တစ်ခုမှာ - ဝှက်ထားသော ဆက်သွယ်ရေးလက္ခဏာ (U+200D) သည် 🚴♂️ ကဲ့သို့သော emoji အများစု၏ ပုံမှန်အစိတ်အပိုင်းတစ်ခုလည်း ဖြစ်သည်။ Hit တစ်ခုသည် emoji အတွင်းတွင် ရှိနေပါက ထိုအချက်ကို မပြောင်းလဲပါနှင့်။
၂။ စာရင်းအင်းဆိုင်ရာ ရေလှိုင်းလက္ခဏာများ - သင်ကိုယ်တိုင် စစ်ဆေး၍ မရနိုင်ပါ
စာသားထဲတွင် မြင်သာသော အရာမရှိပါ။ ဂုဏ်သော့ကို ပိုင်ဆိုင်ထားသော ပေးပို့သူ၏ detector သာလျှင် စာပိုဒ်တစ်ခု ရေလှိုင်းလက္ခဏာပါဝင်သည်မပါသည်ကို ပြောပြနိုင်သည်။ Anthropic ၏ detection API သည် ရွေးချယ်ထားသော ကုမ္ပဏီများအတွက် ပုဂ္ဂိုလ်ရေးဆိုင်ရာ စမ်းသပ်ပြသမှုအဖြစ်သာ ရှိပြီး လူထုအသုံးပြုနိုင်ရန် မဟုတ်ပါ။ လက်တွေ့တွင် ဤကဲ့သို့ ယူဆရပါမည် - watermarking model တစ်ခုက ရေးသားခဲ့ပြီး သင် လုံးဝ ပြန်လည်ရေးသားပြောင်းလဲမှု မလုပ်ခဲ့ပါက၊ ၎င်းသည် လက္ခဏာပါဝင်သည်ဟု ယူဆရပါမည်။
စာသားမှ AI ရေလှိုင်းလက္ခဏာများ ဖယ်ရှားနည်း
- မြင်သာသော လက္ခဏာများကို ဖယ်ရှားပါ။ အထူးအာကာသများကို ပုံမှန်အာကာသများဖြင့် အစားထိုးပြီး ဝှက်ထားသော လက္ခဏာများကို ဖျက်ပါ။ လုံခြုံပြီး၊ ချက်ချင်းဖြစ်ပြီး၊ အချက်အလက်ဆုံးရှုံးမှုမရှိသော နည်းလမ်းဖြစ်သည်။
- လွတ်လပ်သော model တစ်ခုဖြင့် လုံးဝ ပြန်လည်ရေးသားပါ။ အလွယ်တကူ ပြင်ဆင်မှုများသည် စာရင်းအင်းဆိုင်ရာ ရေလှိုင်းလက္ခဏာကို မပျက်စေပါ။ ဝါကျဖွဲ့စည်းပုံနှင့် စကားလုံးရွေးချယ်မှုများ တစ်ပိုင်းတစ်စ ပြောင်းလဲသွားသော လုံးဝ ပြန်လည်ရေးသားမှုသည် မပျက်စေပါ။ သူ၏ output ကိုယ်တိုင် watermark မပါစေသော model တစ်ခုကို အသုံးပြုပါ။ သို့မဟုတ်ပါက သင်သည် လက္ခဏာတစ်ခုကို အခြားတစ်ခုဖြင့် အစားထိုးလိုက်သကဲ့သို့ ဖြစ်သွားမည်။
- လူသားစရိုက်ကို ဖြစ်အောင် ပြုလုပ်ပါ။ လုံးဝ ပြန်လည်ရေးသားခြင်းနှင့် ကျွန်ုပ်တို့၏ AI စာသားကို လူသားစရိုက်ဖြစ်အောင် ပြုလုပ်ခြင်း လမ်းညွှန် မှ humanizer prompt တို့သည် detector များ ကြိုက်နှစ်သက်သော စာလုံးပေါင်းများနှင့် ပုံသေလှုပ်ရှားမှုများကို ဖယ်ရှားပေးသည်။
- ထပ်မံ စစ်ဆေးပါ။ ဖြန့်ချိမည့်အချိန်မတိုင်မီ လက္ခဏာ စစ်ဆေးမှုကို ထပ်မံပြန်လည်လုပ်ဆောင်ပါ။ အချိန်အနည်းငယ်သာ ကြာမြင့်သည်။
ကုဒ်အဆင့် ၁ - လက္ခဏာများကို သန့်ရှင်းပါ
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
ကုဒ်အဆင့် ၂ - NoTrack API ဖြင့် လုံးဝ ပြန်လည်ရေးသားခြင်း
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content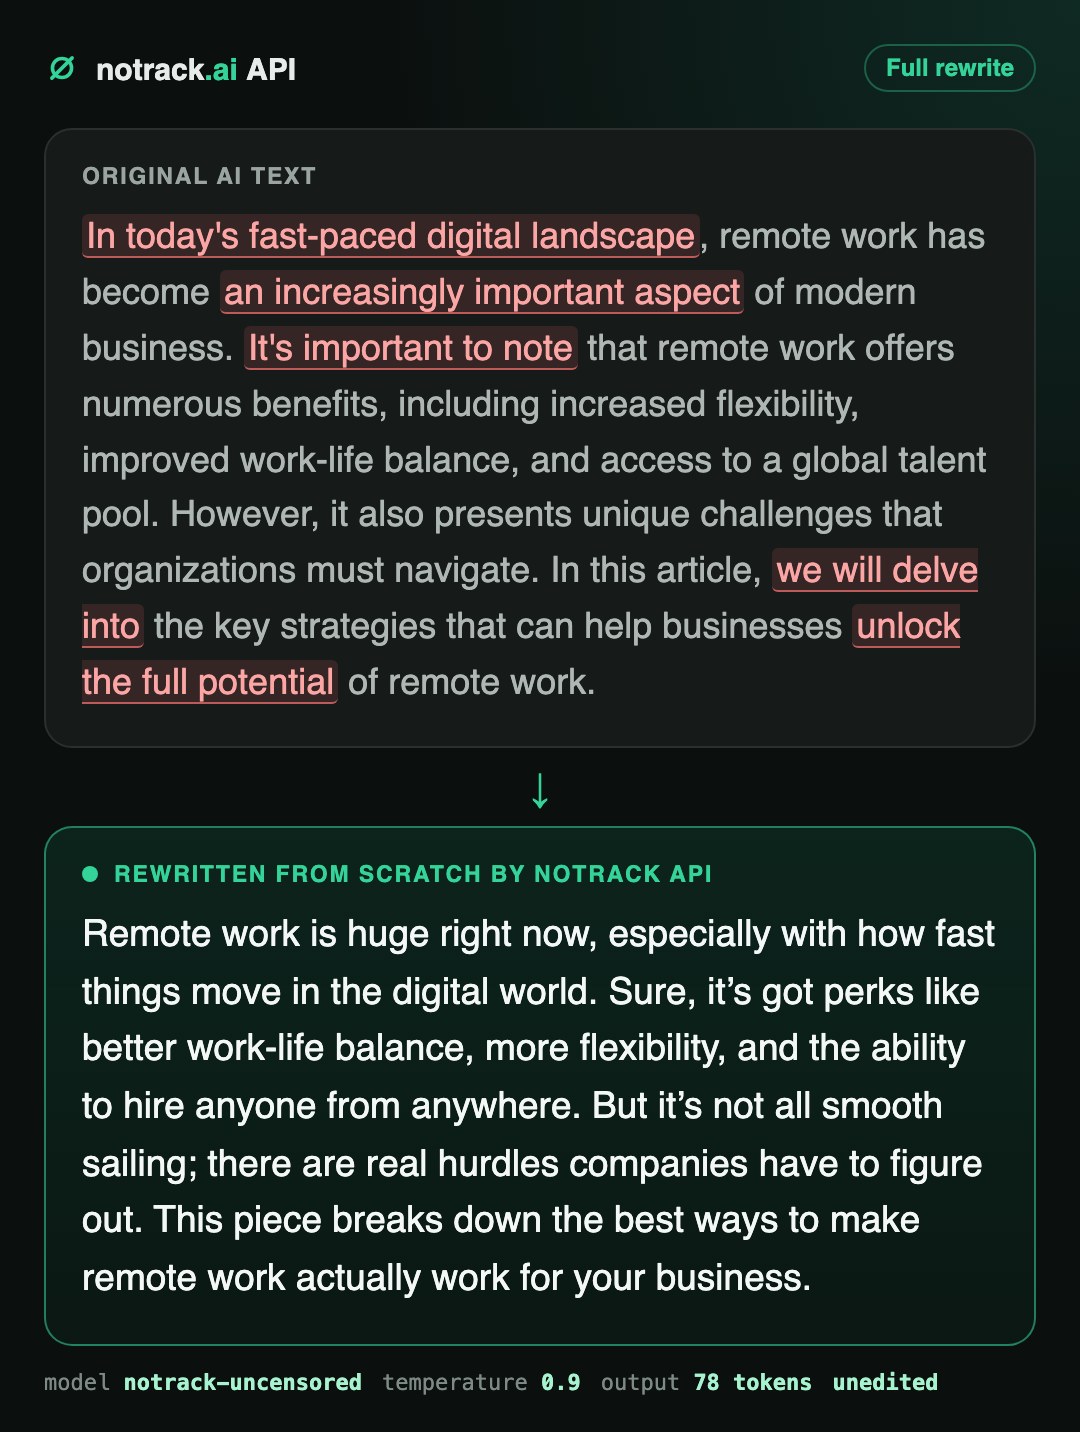
စာအုပ်ကြီးများကို အပိုင်းလိုက် ပြန်လည်ရေးသားပါ။ ၎င်းသည် အရည်အသွေးမြင့်မားစေပြီး စာသား၏ အပိုင်းအားလုံးကို ပြန်လည်ရေးသားထားကြောင်း သေချာစေသည်၊ စာစပိုဒ်တစ်ခုတည်းကိုသာ မဟုတ်ပါ။
သို့မဟုတ် ရေလှိုင်းလက္ခဏာကို လုံးဝ လျှော့ချပါ
အချိန်ကုန်ပြီးနောက် စာသားကို သန့်ရှင်းခြင်းသည် အလုပ်ဖြစ်သည်။ သန့်ရှင်းရန် အရာမရှိခြင်းသည် ပိုကောင်းသည်။ NoTrack API သည် ကျွန်ုပ်တို့၏ ကိုယ်ပိုင် uncensored model ကို ကျွန်ုပ်တို့၏ GPU များပေါ်တွင် အသုံးပြုသည်။ ၎င်းသည် OpenAI၊ Anthropic သို့မဟုတ် Google တို့၏ wrapper မဟုတ်သဖြင့်၊ အထက်ပိုင်း provider များသည် သင့်စာသားကို ဖြတ်သန်းသွားသည့်အခါ ၎င်းတို့၏ လက္ခဏာကို မကပ်မိစေပါ။
- ရေလှိုင်းလက္ခဏာ မရှိပါ။ NoTrack output တွင် စာရင်းအင်းဆိုင်ရာ ရေတွက်လက်မှတ် (statistical watermark) မပါဝင်ဘဲ မူလအရင်းအမြစ် လက်မှတ် (provenance signature) လည်း မပါရှိပါ။ စာသားသည် သင့်အပိုင်ဖြစ်ပြီး ၎င်းနှင့်အတူ အခြားအရာများ မပါရှိပါ။
- လျှို့ဝှက် အက္ခရာများ မပါဝင်ပါ၊ တိုင်းတာပြီးဖြစ်သည်။ ကျွန်ုပ်တို့သည် NoTrack API response များစွာကို စစ်ဆေးခဲ့ပြီး၊ စာလုံးပေါင်း ၂၀,၀၀၀ ခန့်ကို အလွှာလွှာ ခြေရာခံထားသော အက္ခရာများနှင့် အထူး နေရာလွတ် အက္ခရာများအတွက် စစ်ဆေးခဲ့သည်။ အီမိုဂျီတစ်ခုအပေါ်မှလွဲ၍ အရေအတွက်သည် သုညဖြစ်ခဲ့သည်။
- စာရင်းသွင်းမှု မရှိပါ။ Prompt များနှင့် တုံ့ပြန်ချက်များကို disk တွင် မည်သည့်အခါမျှ မရေးသွင်းပါ၊ gateway မှလည်း မဟုတ်၊ model server မှလည်း မဟုတ်ပါ။ ကျွန်ုပ်တို့သည် request ID နှင့် token အရေအတွက်များကို ငွေပေးချေမှုအတွက်သာ ထိန်းသိမ်းထားသည်။ သင့်အကြောင်းအရာကို နောင်တွင် မည်သူမျှ ရှာဖွေတွေ့ရှိနိုင်မည် မဟုတ်ပါ။
- အကြောင်းအရာ စစ်ထုတ်မှု မရှိပါ။ ညနေခင်း ဖျော်ဖြေရေး၊ ချစ်ရေးချစ်ဆရေး၊ အသက်အရွယ်ကြီးသူများအတွက်၊ ဆုကစားခြင်း၊ crypto၊ အမှောင်ဆန်သော ဝတ္ထုများ - ဤ model သည် အဓိက assistant များ ငြင်းဆန်သည် သို့မဟုတ် ရိုးရှင်းစေသည်များကို ရေးသားပြန်ရေးပေးသည်။
- လိုင်းနှစ်လိုင်းဖြင့် ပြောင်းလဲခြင်း။ OpenAI နှင့် လိုက်လျောညီထွေရှိသည်။ base URL ကို
https://api.notrack.ai/v1သို့ ပြောင်းလဲပြီး key ကို ပြောင်းလဲပါ၊ သင့် code၊ tools နှင့် plugins အကြွင်းအကျန်ကို ထိန်းပါ။
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
စာစောင် ၁,၀၀၀ ကို စာလုံးပေါင်း ၈၀၀ ဖြင့် ရေးသားခြင်းသည် output token များအတွက် ခန့်မှန်းခြေ $၁.၁၀ ကုန်ကျသည်။ သင့်အပိုင်းအခြား key ပထမဆုံးအတွက် အခမဲ့ credit သည် သင် ဒေါ်လာတစ်စင်မှ မကုန်ဆုံးမီ စနစ်တစ်ခုလုံးကို စမ်းသပ်ရန် လုံလောက်သည်။ သင့် key ကို ဖန်တီးပါ သို့မဟုတ် API docs ကို ဖတ်ပါ။
FAQ
ChatGPT ၏ စာသားများတွင် ရေခဲသေတ္တာ (watermark) ထည့်ထားပါသလား။
၂၀၂၆ ခုနှစ် စက်တင်ဘာလအထိ မထည့်ထားပါ။ OpenAI သည် ဖန်တီးထားသော ပုံများနှင့် အသံများကို အမှတ်အသားပြုထားပြီး စာသားများအတွက်လည်း မူလအရင်းအမြစ် (provenance) ထည့်သွင်းလိုကြောင်း ပြောဆိုထားသည်။ ၂၀၂၅ ခုနှစ် ဧပြီလတွင် ChatGPT ၏ မော်ဒယ်အချို့သည် မမြင်နိုင်သော ကြားခံနေရာ (narrow no-break space) များကို ထုတ်ပေးခဲ့ပြီး OpenAI က ၎င်းသည် ရေခဲသေတ္တာတစ်ခုထက် သင်ယူမှုဆိုင်ရာ သဘာဝဝိသေသလက္ခဏာတစ်ခုဖြစ်ကြောင်း ဖော်ပြခဲ့သည်။
Claude ၏ စာသားများတွင် ရေခဲသေတ္တာ (watermark) ထည့်ထားပါသလား။
ဟုတ်ကဲ့။ Anthropic သည် ၂၀၂၆ ခုနှစ် ဩဂုတ်လတွင် အသစ်တည်ဆောက်ထားသော Claude မော်ဒယ်များသည် Google ၏ SynthID ပေါ် မူတည်ထားသော စာရင်းအင်းနည်းလမ်း (statistical method) ကို အသုံးပြု၍ ရေခဲသေတ္တာ (watermark) ပါသော စာသားများကို ထုတ်ပေးကြောင်းနှင့် ယခင်မော်ဒယ်များကိုလည်း ခေတ်မီအောင် ပြင်ဆင်နေကြောင်း ကြေညာခဲ့သည်။ ရေခဲသေတ္တာသည် အက္ခရာသစ်များကို မထည့်ပါ။ ၎င်းသည် စကားလုံးရွေးချယ်မှုများအတွင်း တည်ရှိသည်။
Gemini ၏ စာသားများတွင် ရေခဲသေတ္တာ (watermark) ထည့်ထားပါသလား။
ဟုတ်ကဲ့။ Google သည် ၂၀၂၄ ခုနှစ်မှ စတင်၍ Gemini ၏ စာသားထုတ်လွှင့်မှုများကို SynthID ဖြင့် ရေခဲသေတ္တာ (watermark) ပြုလုပ်ထားသည်။
စကားလုံးအနည်းငယ်ကို ပြင်ဆင်ခြင်းဖြင့် ရေခဲသေတ္တာ (watermark) ကို ဖယ်ရှားနိုင်ပါသလား။
မဖြစ်နိုင်ပါ။ စာရင်းအင်းဆိုင်ရာ ရေခဲသေတ္တာ (statistical watermarks) များသည် အလွယ်တကူ ပြင်ဆင်ခြင်းကို ခံနိုင်ရည်ရှိသည်။ Anthropic ၏ ကိုယ်ပိုင်အချက်အလက်များအရ စကားလုံးတိုင်းကို အစားထိုးပြီး အပြည့်အဝ ပြန်လည်ရေးသားခြင်းသည် ရေခဲသေတ္တာကို ဖယ်ရှားပေးနိုင်သည်။ ရေခဲသေတ္တာကိုယ်တိုင် ထည့်သွင်းမည့် မော်ဒယ်ဖြင့် အပြည့်အဝ ပြန်လည်ရေးသားပါ။
ChatGPT သို့မဟုတ် Claude ရေခဲသေတ္တာ (watermark) ဖယ်ရှင်းကိရိယာဆိုသည်မှာ အဘယ်နည်း။
အဆင့်နှစ်ဆင့် ပြုလုပ်ရသည် - မမြင်နိုင်သော အက္ခရာများကို ဖယ်ရှားပြီးနောက် အခြားမော်ဒယ်တစ်ခုဖြင့် စာသားကို အပြည့်အဝ ပြန်လည်ရေးသားရသည်။ အထက်ပါ Python snippet များသည် နှစ်ခုလုံးကို ပြုလုပ်ပေးပြီး ပြန်လည်ရေးသားရန် NoTrack API ကို အသုံးပြုထားသည်။
NoTrack API သည် ရေခဲသေတ္တာ (watermark) သို့မဟုတ် လျှို့ဝှက်အက္ခရာများကို ထည့်သွင်းပေးပါသလား။
မထည့်ပါ။ NoTrack သည် ၎င်း၏ ကိုယ်ပိုင်မော်ဒယ်ကို ၎င်း၏ ကိုယ်ပိုင် hardware များပေါ်တွင် ချော့ထားပြီး ရေခဲသေတ္တာ (watermark)၊ မူလအရင်းအမြစ် လက်ရာလက္ခဏာ (provenance signature) နှင့် လျှို့ဝှက်အက္ခရာများကို မထည့်ပါ။ ၎င်းသည် သင့်၏ prompt များနှင့် output များကိုလည်း သိမ်းဆည်းထားခြင်း မရှိပါ။
Google သည် AI ဖြင့် ဖန်တီးထားသော content များအတွက် ပြစ်ဆောင်ချက် (penalty) ပေးပါသလား။
Google သည် မည်သို့ဖန်တီးထားသည်ဖြစ်စေ အကျိုးရှိပြီး အရည်အသွေးမြင့်မားသော content များကို ဆုချီးမြှင့်ကြောင်း ပြောဆိုထားသည်။ ရေခဲသေတ္တာ (watermark) များသည် ranking အတွက်ထက် သင် content ကို ဖြန့်ဝေသော လူများနှင့် platform များအတွက် ပိုမိုအရေးပါသည်။