
С августа 2026 года текст, который вы получаете от крупнейших ИИ-ассистентов, — это уже не просто текст. Claude и Gemini теперь скрывают статистический водяной знак в выбираемых ими словах, а OpenAI заявила, что следующим шагом станет внедрение водяных знаков в текст для ChatGPT. Вы не можете увидеть его своими глазами, но поставщик может проверить его наличие, так же как и любой другой человек, которому передали детектор. Если вы создаете веб-сайты, пишете тексты для клиентов или публикуете материалы в больших объемах, вот что скрывается внутри текста, сгенерированного ИИ, как проверить свои собственные материалы, как удалить водяные знаки ИИ и как с самого начала генерировать чистый текст с помощью NoTrack API.
Невидимая метка на ваших материалах
2 августа 2026 года вступили в силу правила маркировки согласно Закону ЕС об ИИ (статья 50). Они требуют от поставщиков генеративного ИИ маркировать то, что производят их системы, в машиночитаемом формате, чтобы его можно было обнаружить как сгенерированное ИИ. Крупные лаборатории действовали быстро.
- Anthropic (Claude). 14 августа 2026 года Anthropic сообщила, что новые модели Claude генерируют текст, содержащий водяной знак, а более ранние модели будут обновлены в течение последующих месяцев. Детектор API уже находится в закрытом предварительном просмотре для регулирующих органов, правоохранительных органов, СМИ, экспертов по проверке фактов, исследователей и образовательных организаций.
- Google (Gemini). Gemini маркирует выходные текстовые данные с 2024 года с помощью SynthID, метода, опубликованного Google DeepMind в журнале Nature и открытого в 2024 году. Водяной знак Claude построен на том же подходе.
- OpenAI (ChatGPT). OpenAI уже маркирует сгенерированные изображения и аудио и заявила о намерении расширить происхождение контента на текст. По сообщениям, компания уже создала внутренний водяной знак для текста, но еще не выпустила его.
Для обычного пользователя, который просто ищет рецепт, это не имеет значения. Но для тех, кто публикует тексты, созданные с помощью ИИ, продаёт их или передаёт клиентам, всё меняется: ваш контент теперь несёт подпись, которую вы не добавляли, не видите и не можете отключить.
Два вида водяных знаков в тексте, созданном ИИ
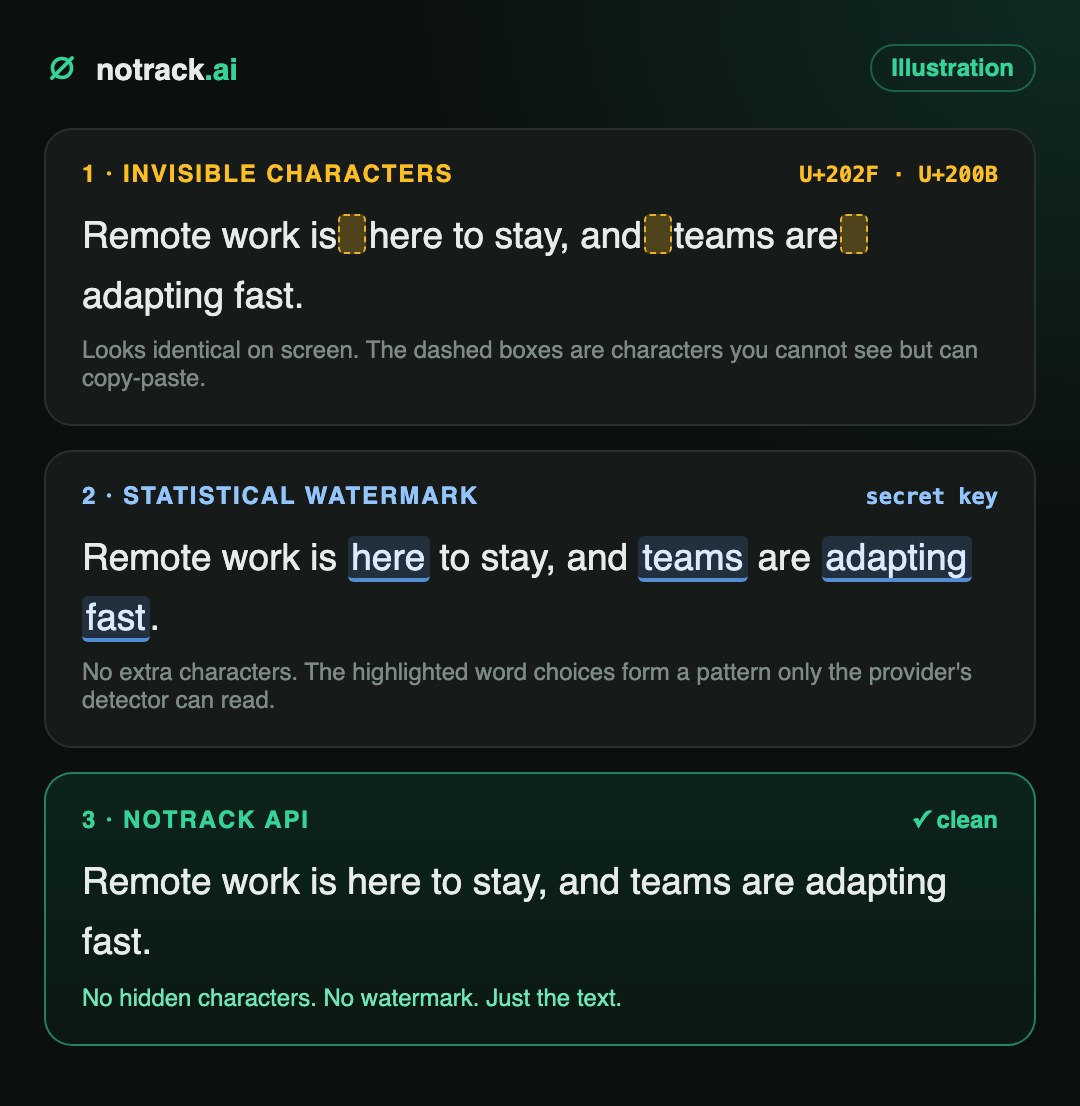
Термин «водяной знак ИИ» используется для обозначения двух совершенно разных вещей. Понимание того, с каким именно типом вы имеете дело, определяет стратегию его удаления.
Невидимые символы
Символы Unicode, которые выглядят как обычный пробел или вообще невидимы: нулевые пробелы, неразрывные пробелы, пробелы без переноса строки.
- Легко обнаруживаются с помощью простого скрипта
- Легко удаляются: достаточно удалить или заменить их
- Нарушают работу незаметно: поиск, подсчёт слов, поиск ключевых слов, код
Статистические водяные знаки
Дополнительные символы отсутствуют. Выбор слов моделью управляется секретным ключом, оставляя паттерн, который может прочитать только детектор провайдера.
- Невидимы для читателей и для любых текстовых редакторов
- Сохраняются при копировании-вставке и лёгком редактировании
- Ослабевает при сильной переработке; полный пересказ устраняет его
Невидимые символы: эпизод ChatGPT
В апреле 2025 года исследователи заметили, что текст в моделях OpenAI — тогда ещё новых o3 и o4-mini — содержал узкие неразрывные пробелы (U+202F) в тех местах, где должен был стоять обычный пробел. При вставке в Word с включённым отображением знаков форматирования они отображались в виде крошечных кружков, а не точек. Представители OpenAI заявили, что эти символы являются побочным эффектом крупномасштабного обучения с подкреплением, а не преднамеренным водяным знаком, и впоследствии перестали появляться. Урок остался: текст, сгенерированный ИИ, может содержать невидимые символы, которые сохраняются при каждом копировании и вставке в ваши CMS.
Статистические водяные знаки: SynthID и Claude
Языковая модель выбирает каждое следующее слово из списка вероятных кандидатов, добавляя немного случайности. Статистический водяной знак заменяет эту случайность псевдослучайным выбором, заданным секретным ключом. Для читателя текст выглядит совершенно обычным. Для человека, обладающего ключом, достаточно длинный фрагмент выявляет закономерность в выборе слов, которая практически никогда не возникла бы случайно.
Слова, которые выбирает Claude, всё ещё случайны, но теперь можно проверить последовательность слов и убедиться, соответствует ли она выборам, которые Claude сделала бы при использовании ключа.
Anthropic, Как работает текстовый водяной знак Claude (август 2026 г.)
Для издателей важны две детали. Водяной знак становится сильнее по мере увеличения объёма текста, и, согласно Anthropic, лёгкая редакция не удалит его, тогда как полный пересказ, при котором каждое слово будет заменено, — удалит.
Кто водяит текст ИИ (сентябрь 2026 г.)
| Поставщик | Текстовый водяной знак | Тип | Кто может проверить |
|---|---|---|---|
| Google Gemini | Да, начиная с 2024 года | Статистический (SynthID) | Инструменты SynthID от Google |
| Claude Anthropic | Да, новые модели с августа 2026 года | Статистические (на основе SynthID) | Обнаружение API от Anthropic, закрытое предварительное тестирование для регуляторов, СМИ, преподавателей и исследователей |
| ChatGPT OpenAI | Пока только для изображений и аудио; текст еще не помечен | Происхождение текста объявлено как цель | Инструменты OpenAI (изображения и аудио уже доступны) |
| NoTrack API | Нет | Без водяного знака, без скрытых символов | Никто |
Почему текст с водяными знаками вредит создателям контента
Google уже много лет утверждает, что ранжирует контент по качеству, а не по способу его создания. Проблема в остальных участниках цепочки.
- Ваши клиенты могут это проверить. Агентства и фрилансеры передают тексты людям, которые всё чаще проверяют их с помощью ИИ перед оплатой. Водяной знак превращает «создано с помощью ИИ и тщательно отредактировано» в «помечено как ИИ» без возможности для нюансов.
- Платформы и маркетплейсы проводят фильтрацию. Платформы для публикации, фриланс-биржи, рекламные сети и сайты с отзывами внедряют детекторы ИИ. Обнаружимая сигнатура — это самое простое, что можно использовать для фильтрации.
- Это раскрывает ваш рабочий процесс. Водяной знак сообщает любому, у кого есть детектор, какой инструмент создал ваш контент. Для контентного бизнеса это конкурентная информация, которую вы никогда не соглашались публиковать.
- Она следует за текстом повсюду. Текст с водяным знаком сохраняет свою сигнатуру при синдикации, легком переводе или повторной публикации. Вы не можете провести аудит того, что не видите.
- Скрытые символы всё ломают. Невидимые Unicode quietly ломают поиск по сайту, точные ключевые слова, подсчет слов, проверки орфографии и любой код, который вы вставляете. Они также могут заставить две внешне идентичные страницы отличаться байт за байтом.
Как проверить текст на ИИ-водяные знаки
1. Невидимые символы: проверка за секунды
Быстрый ручной тест: вставьте текст в Microsoft Word и нажмите Ctrl+Shift+8 (Cmd+8 на Mac), чтобы показать знаки форматирования. Обычные пробелы отображаются как точки; специальные пробелы — как маленькие кружки или другие символы. Для работы в больших объемах используйте скрипт:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
Одно важное замечание: нулевой соединитель (U+200D) также является законной частью многих эмодзи, например 🚴♂️. Если такой символ находится внутри эмодзи, оставьте его без изменений.
2. Статистические водяные знаки: их нельзя проверить самостоятельно
В тексте нет ничего, что можно было бы увидеть невооружённым глазом. Только детектор провайдера, обладающий секретным ключом, может определить, содержит ли фрагмент водяной знак. Детекция Anthropic API находится в закрытом предварительном просмотре для выбранных организаций и не доступна для широкой публики. На практике это означает: если текст написан моделью с водяными знаками и вы не переработали его полностью, он будет помечен.
Как удалить ИИ-водяные знаки из текста
- Удалите невидимые символы. Замените специальные пробелы на обычные и удалите нуль-ширинные символы. Безопасно, мгновенно и без потери данных.
- Полностью перепишите текст с помощью независимой модели. Лёгкие правки оставляют статистический водяной знак нетронутым. Полная переработка, при которой меняется структура предложений и выбор слов, — нет. Используйте модель, которая не добавляет водяные знаки в собственный вывод, иначе вы просто замените одну подпись на другую.
- Сделайте стиль более «человеческим». Полная переработка текста в сочетании с промптом для «очеловечивания» из нашего руководства по адаптации ИИ-текстов устраняет шаблонные фразы и монотонный ритм, которые так любят детекторы.
- Проведите повторную проверку. Снова запустите проверку символов перед публикацией. Это займёт всего пару секунд.
Шаг 1 в коде: очистка символов
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Шаг 2 в коде: полная переработка через NoTrack API
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content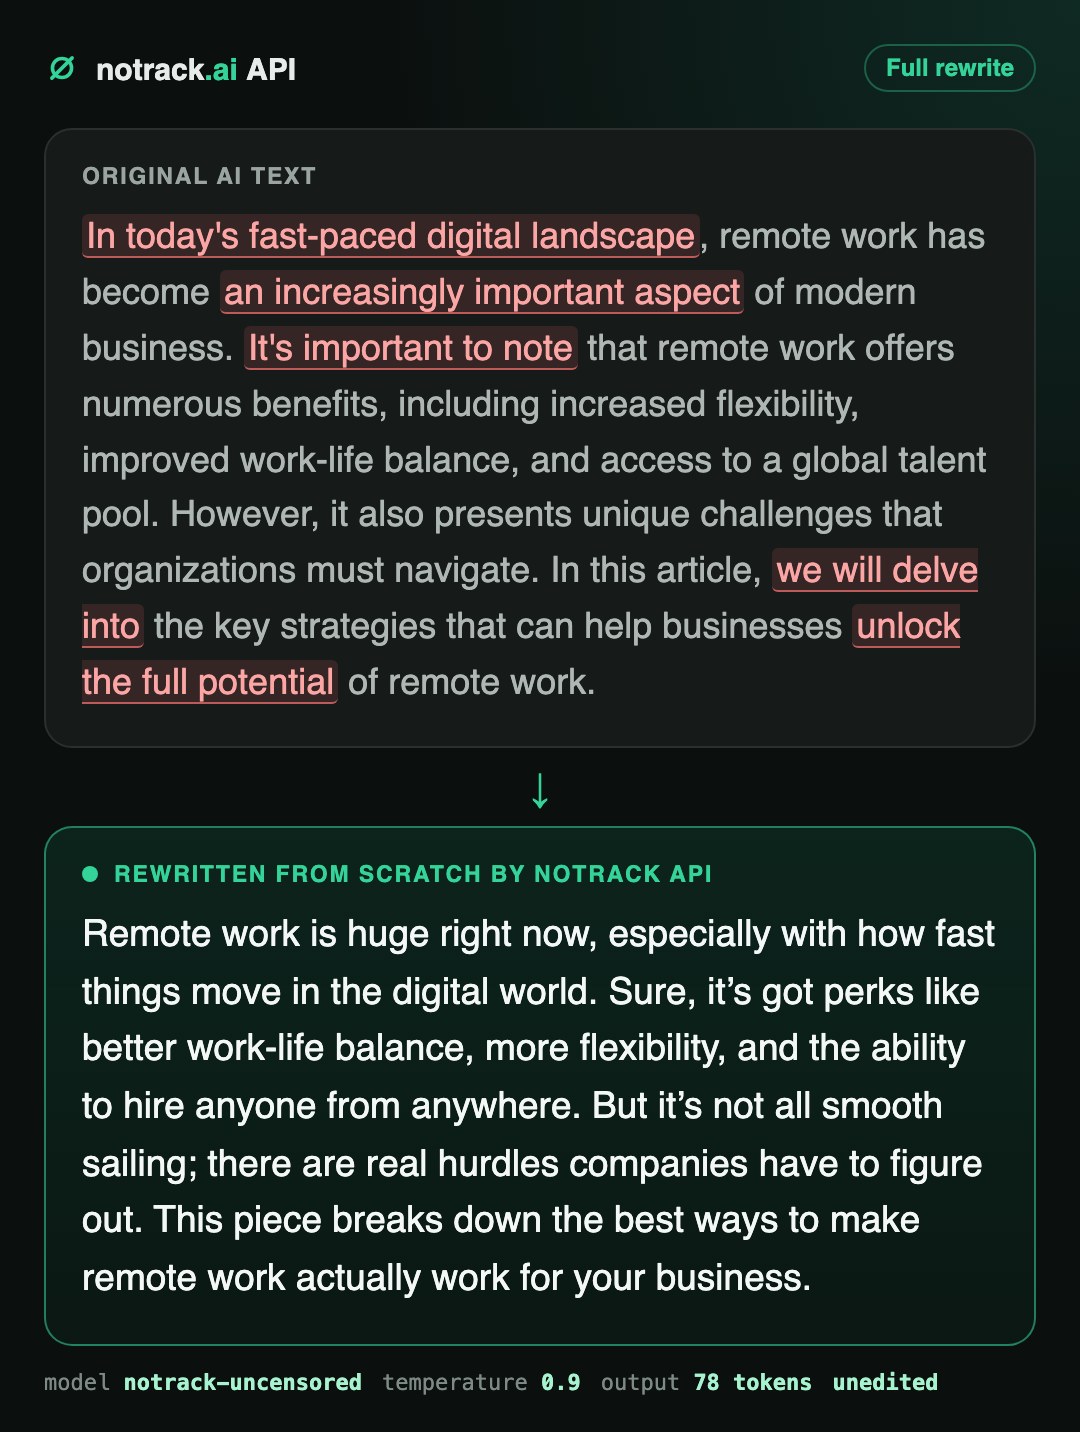
Перерабатывайте длинные документы по разделам. Это сохраняет высокое качество и гарантирует, что будет переработан весь текст, а не только его начало.
Или полностью избегайте водяных знаков
Очистка текста постфактум работает. Но ещё лучше, когда нечего чистить. NoTrack API использует собственную нецензурируемую модель на собственных GPU. Это не обёртка над OpenAI, Anthropic или Google, поэтому ни один вышестоящий провайдер не накладывает свою подпись на ваш текст в процессе обработки.
- Без водяных знаков. Вывод NoTrack не содержит статистического водяного знака и сигнатуры происхождения. Текст принадлежит вам, к нему не прикреплено ничего лишнего.
- Скрытых символов нет, что подтверждено измерениями. Мы просканировали 26 ответов NoTrack API общим объёмом около 20 000 знаков на наличие нуль-ширинных и специальных пробельных символов. За исключением одного эмодзи, их количество оказалось нулевым.
- Без логов. Промпты и ответы никогда не записываются на диск — ни шлюзом, ни серверами моделей. Мы сохраняем только идентификатор запроса и количество токенов для биллинга. Никто не сможет позже найти ваш контент.
- Без тематических фильтров. Ночная жизнь, дейтинг, контент 18+, азартные игры, крипто, тёмная фантастика: модель пишет и переписывает то, что основные ассистенты отказываются генерировать или смягчают.
- Переключение в две строки. Совместимо с OpenAI. Измените базовый URL на
https://api.notrack.ai/v1и ключ, остальной код, инструменты и плагины оставьте без изменений.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
Написание 1000 статей по 800 слов стоит примерно $1,10 за выходные токены. Бесплатного кредита на вашем первом ключе достаточно, чтобы протестировать весь рабочий процесс, прежде чем потратить хотя бы цент. Создайте свой ключ или прочитайте документацию API.
Часто задаваемые вопросы
Водит ли ChatGPT текст водяными знаками?
По состоянию на сентябрь 2026 года — нет. OpenAI маркирует сгенерированные изображения и аудио и заявляла о намерении распространить проверку происхождения на текст. В апреле 2025 года некоторые модели ChatGPT генерировали невидимые узкие неразрывные пробелы, которые OpenAI описали как особенность обучения, а не как водяной знак.
Водит ли Claude текст водяными знаками?
Да. Anthropic объявила в августе 2026 года, что новые модели Claude генерируют текст с водяными знаками, используя статистический метод на основе SynthID от Google, а также что старые модели обновляются. Водяной знак не добавляет символов; он присутствует в выборе слов.
Водит ли Gemini текст водяными знаками?
Да. Google с 2024 года наносит водяные знаки на выходные данные Gemini, используя SynthID.
Можно ли удалить водяной знак, отредактировав несколько слов?
Нет. Статистические водяные знаки выживают при лёгком редактировании. Сама Anthropic отмечает, что полный пересказ, в котором каждое слово заменяется, удаляет водяной знак. Перепишите текст полностью с помощью модели, которая не добавляет собственные водяные знаки.
Что такое удалитель водяных знаков ChatGPT или Claude?
Это двухэтапный процесс: удаление невидимых символов, затем полный пересказ текста с помощью независимой модели. Приведённые выше сниппеты Python делают и то, и другое, используя NoTrack API для пересказа.
Добавляет ли NoTrack API водяные знаки или скрытые символы?
Нет. NoTrack запускает свою собственную модель на собственном оборудовании и не добавляет ни водяных знаков, ни меток происхождения, ни скрытых символов. Она также не сохраняет ваши запросы или выходные данные.
Штрафует ли Google за контент, сгенерированный ИИ?
Google заявляла, что поощряет полезный контент высокого качества независимо от способа его создания. Водяные знаки имеют меньшее значение для ранжирования и большее — для людей и платформ, которым вы предоставляете контент.