
Depuis août 2026, le texte que vous obtenez des plus grands assistants IA n'est plus du texte ordinaire. Claude et Gemini intègrent désormais un filigrane statistique dans les mots qu'ils choisissent, et OpenAI a annoncé que le texte serait la prochaine cible pour ChatGPT. Vous ne pouvez pas le voir, mais le fournisseur peut le détecter, tout comme quiconque à qui il remet un détecteur. Si vous créez des sites web, rédigez pour des clients ou publiez à grande échelle, voici ce qui se cache dans le texte généré par l'IA aujourd'hui, comment vérifier vos propres contenus, comment supprimer les filigranes IA et comment générer un texte propre dès le départ avec l'NoTrack API.
L'étiquette invisible apposée sur vos contenus
Le 2 août 2026, les règles de marquage prévues par le règlement européen sur l'IA (article 50) sont entrées en vigueur. Elles imposent aux fournisseurs d'IA générative de marquer de manière lisible par une machine ce que leurs systèmes produisent, afin que celui-ci puisse être détecté comme étant généré par une IA. Les grands laboratoires ont fait preuve de rapidité.
- Anthropic (Claude). Le 14 août 2026, Anthropic a annoncé que les nouveaux modèles Claude génèrent du texte contenant un filigrane, les modèles plus anciens ayant été mis à jour au cours des mois suivants. Un API de détection est déjà en aperçu privé à l'intention des régulateurs, des forces de l'ordre, des médias, des vérificateurs de faits, des chercheurs et des établissements d'enseignement.
- Google (Gemini). Depuis 2024, Gemini a filigrané ses sorties textuelles avec SynthID, une méthode publiée par Google DeepMind dans la revue Nature et open source depuis 2024. Le filigrane de Claude repose sur la même approche.
- OpenAI (ChatGPT). OpenAI marque déjà les images et les audio générés et a indiqué vouloir étendre la preuve de l'origine du contenu au texte. Il a été rapporté qu'il a développé en interne un filigrane textuel, mais qu'il ne l'a pas encore déployé.
Pour un utilisateur lambda qui demande une recette, cela n’a guère d’importance. Mais pour quiconque publie du texte assisté par l’IA, le vend ou le remet à des clients, cela change la donne : votre contenu porte désormais une signature que vous n’avez pas ajoutée, que vous ne voyez pas et que vous ne pouvez pas désactiver.
Deux types de filigrane dans le texte généré par l’IA
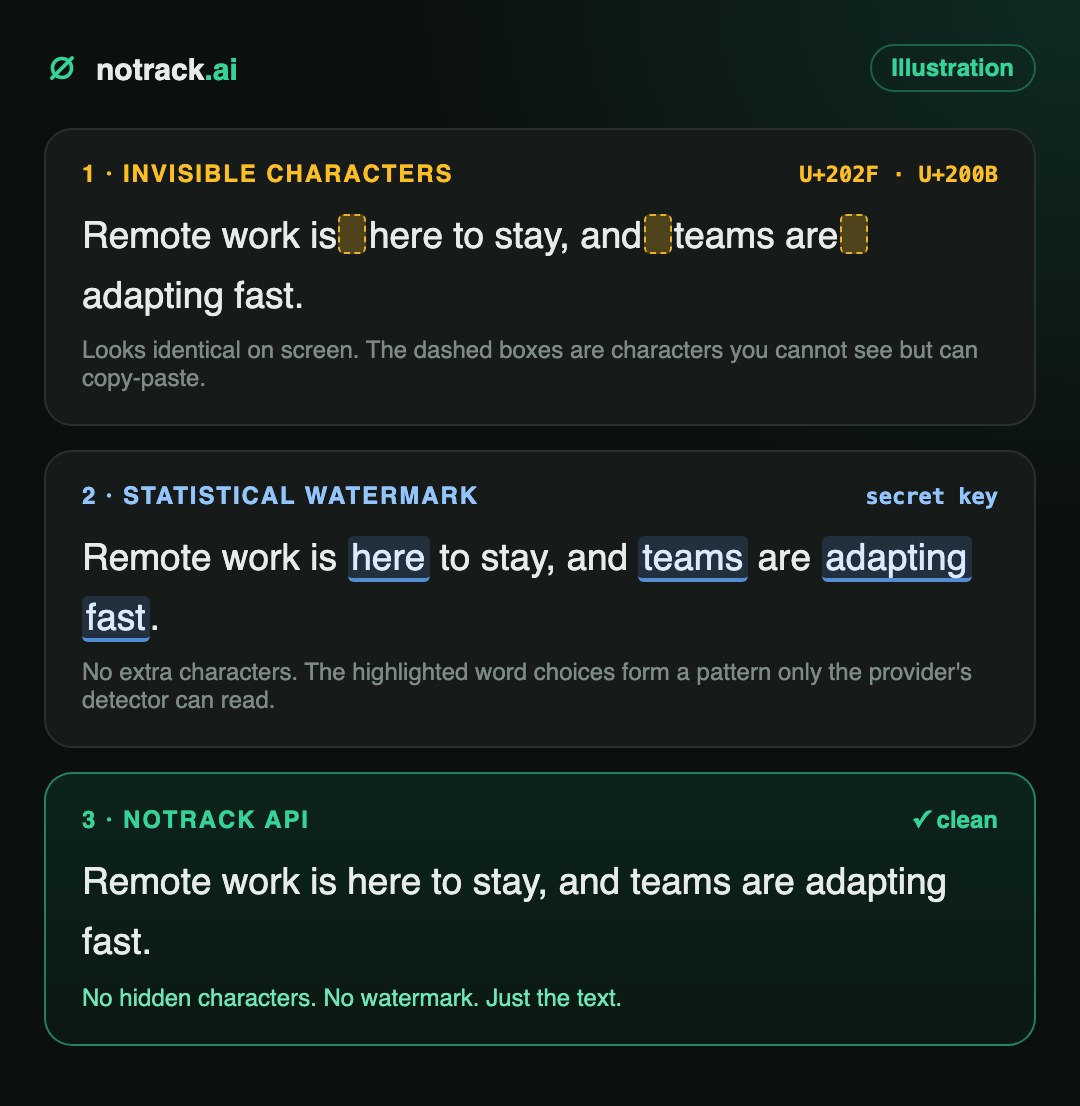
L’expression « filigrane IA » désigne deux choses très différentes. Savoir à laquelle vous avez affaire détermine la façon de le retirer.
Caractères invisibles
Des caractères Unicode qui ressemblent exactement à une espace normale ou à rien du tout : espaces insécables, césures invisibles, espaces fines insécables.
- Faciles à détecter avec un script simple
- Faciles à retirer : il suffit de les supprimer ou de les remplacer
- Perturbent silencieusement la recherche, le compte de mots, la correspondance de mots-clés et le code
Filigranes statistiques
Aucun caractère supplémentaire. Les choix lexicaux du modèle sont guidés par une clé secrète, laissant une empreinte que seul le détecteur du fournisseur peut lire.
- Invisibles aux lecteurs et à tout éditeur de texte
- Survivent au copier-coller et aux modifications légères
- S’affaiblit lors d’une réécriture importante ; une réécriture complète le supprime
Caractères invisibles : l’épisode ChatGPT
En avril 2025, des chercheurs ont remarqué que le texte des modèles o3 et o4-mini de OpenAI, alors récents, contenait des espaces insécables fins (U+202F) là où un espace normal était attendu. Collés dans Word avec l’affichage des marques de paragraphe activé, ils apparaissaient sous forme de petits cercles au lieu de points. OpenAI a indiqué que ces caractères étaient une particularité de l’apprentissage par renforcement à grande échelle, et non un filigrane délibéré, et ils ont cessé d’apparaître par la suite. La leçon reste pertinente : le texte généré par l’IA peut transporter des caractères que vous ne voyez pas, et ceux-ci voyagent avec chaque copie-colle dans votre CMS.
Filigranes statistiques : SynthID et Claude
Un modèle de langage choisit chaque mot suivant parmi une liste de candidats probables, avec une part d’aléatoire. Un filigrane statistique remplace cette part d’aléatoire par un choix pseudo-aléatoire issu d’une graine définie par une clé secrète. Pour un lecteur, le texte paraît tout à fait normal. Pour quelqu’un détenant la clé, un passage suffisamment long révèle une série de choix de mots qui se produirait presque jamais par hasard.
Les mots choisis par Claude restent aléatoires, mais on peut désormais vérifier la séquence des mots et voir si elle est cohérente avec les choix que Claude aurait faits s’il avait utilisé la clé.
Anthropic, Comment fonctionne le filigrane textuel de Claude (août 2026)
Deux détails sont importants pour les éditeurs. Le filigrane devient plus marqué à mesure que le texte s’allonge, et selon Anthropic, une légère retouche ne le supprime pas, tandis qu’une réécriture complète où chaque mot est remplacé le fait.
Qui applique un filigrane au texte IA (septembre 2026)
| Fournisseur | Filigrane textuel | Type | Qui peut le vérifier |
|---|---|---|---|
| Google Gemini | Oui, depuis 2024 | Statistique (SynthID) | Outils SynthID de Google |
| Claude de Anthropic | Oui, de nouveaux modèles depuis août 2026 | Statistique (basée sur SynthID) | Détection API par Anthropic, aperçu privé pour les régulateurs, les médias, les enseignants et les chercheurs |
| ChatGPT de OpenAI | Pas encore pour le texte ; les images et l'audio sont déjà marqués | La provenance du texte annoncée comme un objectif | Outils OpenAI (images et audio disponibles aujourd'hui) |
| NoTrack API | Non | Pas de filigrane, pas de caractères cachés | Personne |
Pourquoi le texte filigrané nuit aux créateurs de contenu
Google affirme depuis des années qu’il classe le contenu en fonction de sa qualité, et non de sa méthode de production. Le problème, c’est tout le reste de la chaîne.
- Vos clients peuvent vérifier. Les agences et les freelances remettent du texte à des destinataires qui, de plus en plus, lancent des vérifications IA avant de payer. Un filigrane transforme « assisté par l’IA et soigneusement relu » en « signalé », sans laisser place à la nuance.
- Les plateformes et les places de marché filtrent. Les plateformes d’édition, les places de marché freelances, les réseaux publicitaires et les sites d’avis ajoutent la détection IA. Une signature détectable est la chose la plus simple au monde à filtrer.
- Cela révèle votre flux de travail. Un filigrane indique à quiconque dispose d’un détecteur quel outil a rédigé votre contenu. Pour une entreprise de contenu, il s’agit d’une information concurrentielle que vous n’avez jamais acceptée de publier.
- Il suit le texte partout. S’il est syndiqué, légèrement traduit ou republié, le texte filigrané conserve sa signature. Vous ne pouvez pas auditer ce que vous ne voyez pas.
- Les caractères invisibles créent des dysfonctionnements. Un Unicode invisible casse silencieusement la recherche sur site, les mots-clés en correspondance exacte, les compteurs de mots, les correcteurs orthographiques et tout code que vous collez. Il peut également faire en sorte que deux pages aux apparences identiques diffèrent octet par octet.
Comment vérifier la présence de filigranes IA dans votre texte
1. Caractères invisibles : vérification en quelques secondes
Test manuel rapide : collez le texte dans Microsoft Word et appuyez sur Ctrl+Shift+8 (Cmd+8 sur Mac) pour afficher les marques de mise en forme. Les espaces normaux apparaissent sous forme de points ; les espaces spéciaux apparaissent sous forme de petits cercles ou d’autres symboles. Pour traiter un volume important, utilisez un script :
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
Une mise en garde à connaître : le caractère de jonction de largeur nulle (U+200D) fait également partie intégrante de nombreux emojis, comme 🚴♂️. Si un caractère se trouve à l'intérieur d'un emoji, laissez-le tel quel.
2. Les filigranes statistiques : vous ne pouvez pas les vérifier vous-même
Rien à voir dans le texte. Seul le détecteur du fournisseur, qui détient la clé secrète, peut déterminer si un passage est filigrané. La détection API de Anthropic est en aperçu privé pour les organisations sélectionnées, et non pour le grand public. En pratique, cela signifie que vous devez supposer : si un modèle de filigranage l'a écrit et que vous ne l'avez pas entièrement réécrit, il est marqué.
Comment supprimer les filigranes IA du texte
- Supprimez les caractères invisibles. Remplacez les espaces spéciaux par des espaces normaux et supprimez les caractères de largeur nulle. Sûr, instantané et sans perte.
- Réécrivez complètement avec un modèle indépendant. Les modifications légères laissent intact un filigrane statistique. Une réécriture complète, où la structure des phrases et le choix des mots changent tout au long du texte, non. Utilisez un modèle qui ne filigrane pas ses propres sorties, sinon vous ne faites qu'échanger une signature contre une autre.
- Humanisez le style. Une réécriture complète plus l'invite de style « humaniser » de notre guide sur l'humanisation du texte IA supprime les phrases toutes faites et le rythme plat que les détecteurs apprécient.
- Scannez une nouvelle fois. Exécutez à nouveau la vérification des caractères avant la publication. Cela prend une seconde.
Étape 1 dans le code : nettoyer les caractères
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Étape 2 dans le code : une réécriture complète via NoTrack API
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content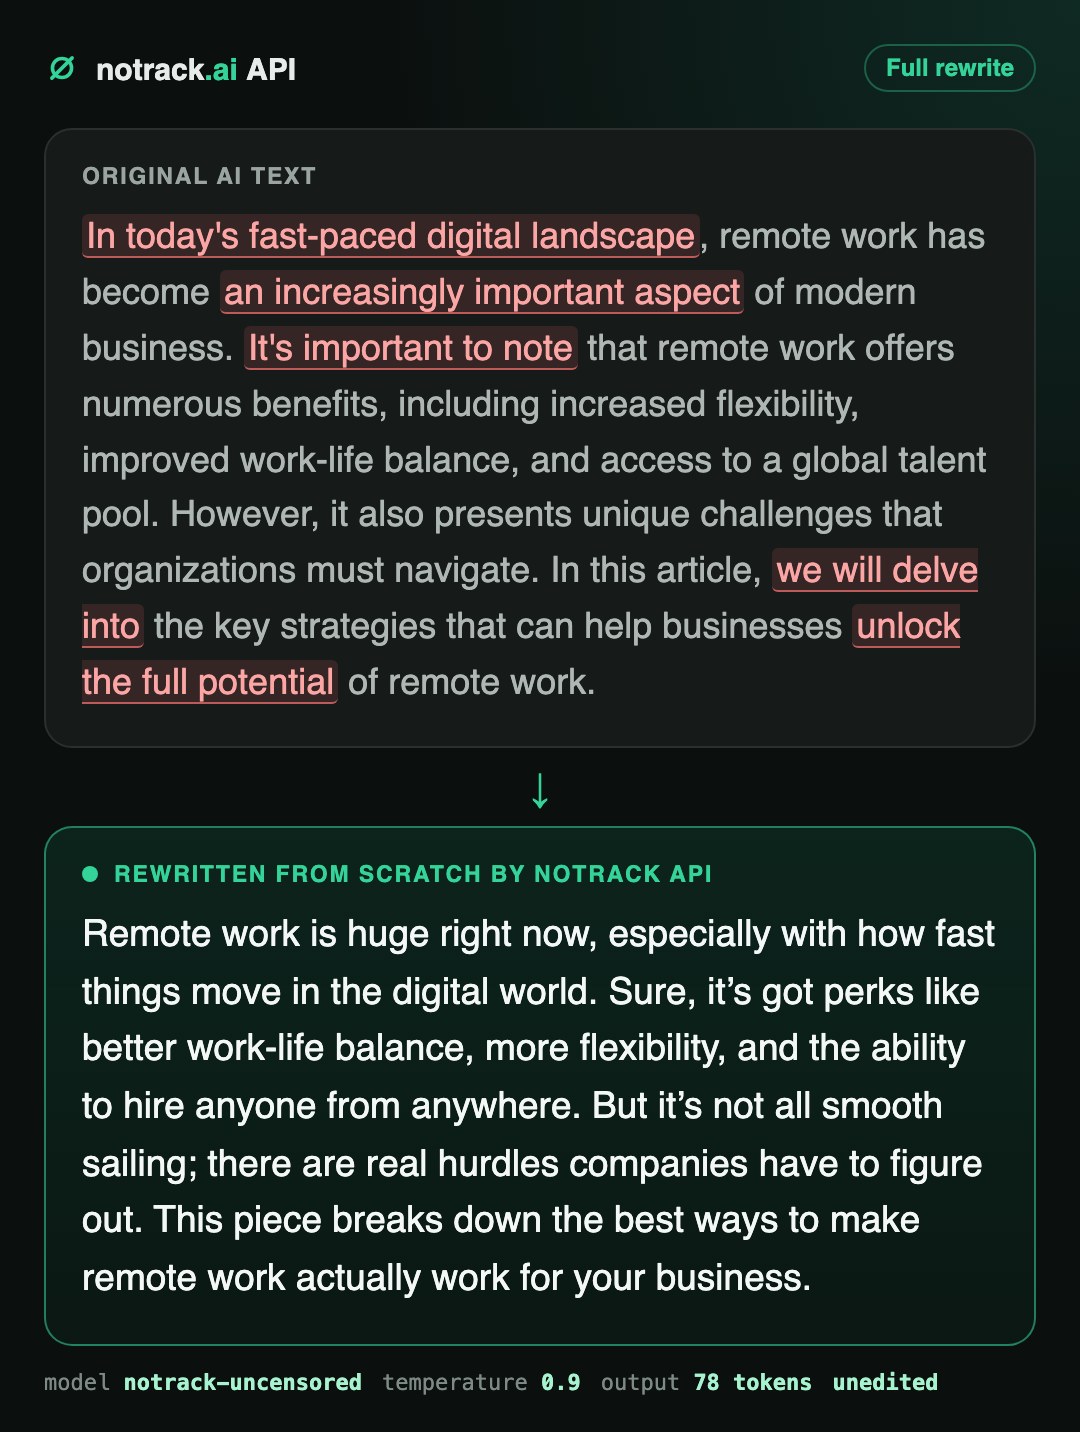
Réécrivez les longs documents section par section. Cela maintient une qualité élevée et garantit que chaque partie du texte est réécrite, et pas seulement l'introduction.
Ou ignorez complètement le filigrane
Nettoyer le texte a posteriori fonctionne. Ne rien avoir à nettoyer fonctionne encore mieux. NoTrack API exécute son propre modèle non filtré sur ses propres GPU. Ce n'est pas un wrapper autour de OpenAI, Anthropic ou Google, donc aucun fournisseur en amont n'imprime sa signature sur votre texte lors du passage.
- Pas de filigrane. Les sorties de NoTrack ne comportent ni filigrane statistique ni signature de provenance. Le texte est le vôtre, rien d’autre n’y est attaché.
- Aucun caractère caché, mesuré. Nous avons analysé 26 réponses de NoTrack API, soit environ 20 000 caractères, à la recherche de caractères invisibles et d’espaces spéciaux. En dehors d’un emoji, le décompte était nul.
- Aucun journal. Les invites et les réponses ne sont jamais écrites sur le disque, ni par la passerelle ni par les serveurs du modèle. Nous conservons un identifiant de requête et des compteurs de jetons à des fins de facturation. Personne ne peut retrouver votre contenu plus tard.
- Aucun filtre de sujet. Vie nocturne, rencontres, contenu adulte, paris, cryptomonnaies, fiction sombre : le modèle rédige et retravaille ce que les assistants grand public refusent ou atténuent.
- Basculement en deux lignes. Compatible avec OpenAI. Modifiez l’URL de base vers
https://api.notrack.ai/v1et la clé, conservez le reste de votre code, outils et plugins.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
La rédaction de 1 000 articles de 800 mots coûte environ 1,10 $ en jetons de sortie. Le crédit gratuit sur votre première clé suffit pour tester l’intégralité du flux de travail avant de dépenser le moindre centime. Créez votre clé ou consultez la documentation de API.
FAQ
ChatGPT marque-t-il ses textes ?
Pas à ce jour en septembre 2026. OpenAI marque les images et les fichiers audio générés et a indiqué vouloir étendre la traçabilité aux textes. En avril 2025, certains modèles ChatGPT ont produit des espaces insécables fins invisibles, que OpenAI a décrits comme un caprice d'entraînement plutôt que comme un filigrane.
Claude marque-t-il ses textes ?
Oui. Anthropic a annoncé en août 2026 que les nouveaux modèles Claude génèrent des textes filigranés, en utilisant une méthode statistique basée sur SynthID de Google, et que les modèles plus anciens sont mis à jour. Le filigrane n'ajoute aucun caractère ; il réside dans les choix de mots.
Gemini marque-t-il ses textes ?
Oui. Google applique un filigrane aux sorties textuelles de Gemini via SynthID depuis 2024.
Puis-je supprimer un filigrane en modifiant quelques mots ?
Non. Les filigranes statistiques survivent à des modifications légères. Anthropic lui-même note qu'une réécriture complète où chaque mot est remplacé supprime le filigrane. Réécrivez entièrement le texte avec un modèle qui n'ajoute pas son propre filigrane.
Qu'est-ce qu'un défiligraneur ChatGPT ou Claude ?
Il s'agit d'un processus en deux étapes : supprimer les caractères invisibles, puis réécrire entièrement le texte avec un modèle indépendant. Les extraits Python ci-dessus effectuent les deux opérations, en utilisant NoTrack API pour la réécriture.
NoTrack API ajoute-t-il un filigrane ou des caractères cachés ?
Non. NoTrack exécute son propre modèle sur son propre matériel et n'ajoute aucun filigrane, aucune signature de provenance ni aucun caractère caché. Il ne stocke pas non plus vos invites ni vos sorties.
Google pénalise-t-il le contenu généré par l'IA ?
Google a indiqué qu'il récompense le contenu utile et de haute qualité, quelle que soit sa méthode de production. Les filigranes importent moins pour le classement et davantage pour les personnes et les plateformes auprès desquelles vous diffusez du contenu.