
Elokuusta 2026 lähtien teksti, jonka saat suurimmilta tekoälyavustajilta, ei ole enää pelkkää tekstiä. Claude ja Gemini piilottavat nyt tilastollisen vesileiman valitsemiinsa sanoihin, ja OpenAI on ilmoittanut, että teksti on seuraava kohde ChatGPT:lle. Et näe sitä, mutta tarjoaja voi tarkistaa sen, ja samaan tarkistukseen pystyy myös kuka tahansa, jolle tarjoaja antaa käyttöön detektorin. Jos rakennat verkkosivustoja, kirjoitat asiakkaille tai julkaiset massasti, tässä on tietoa siitä, mitä tekoälyn luomaan tekstiin kuuluu tänään, miten voit tarkistaa oman sisältösi, miten poistaa tekoälyn vesileimat ja miten tuottaa puhdasta tekstiä suoraan käyttämällä NoTrack API.
Näkyämätön merkki sisältöösi
2. elokuuta 2026 alkaen EU:n tekoälyasetuksen (artikla 50) läpinäkyvyysvaatimukset ovat tulleet voimaan. Ne vaativat generatiivisen tekoälyn tarjoajia merkitsemään järjestelmiensä tuotokset koneellisesti luettavassa muodossa, jotta ne voidaan tunnistaa tekoälyn tuottamiksi. Suuret laboratoriot toimivat nopeasti.
- Anthropic (Claude). 14. elokuuta 2026 Anthropic ilmoitti, että uudet Claude-mallit tuottavat tekstiä, joka sisältää vesileiman, ja vanhemmat mallit päivitettiin vesileiman suhteen seuraavien kuukausien aikana. Detektointiin tarkoitettu API on jo yksityisessä esikatselussa sääntelijöille, poliisille, medialle, faktantarkistajille, tutkijoille ja koulutusorganisaatioille.
- Google (Gemini). Gemini on vesileimannut tekstituotantonsa vuodesta 2024 lähtien SynthID-menetelmällä, jonka Google DeepMind julkaisi Nature-lehdessä ja avoimeksi lähdekoodiksi vuonna 2024. Claude:n vesileima perustuu samaan lähestymistapaan.
- OpenAI (ChatGPT). OpenAI merkitsee jo tuotettuja kuvia ja ääntä, ja sen on kerrottu haluavan laajentaa sisällön alkuperän varmistamista myös tekstiin. Sen on kerrottu rakentaneen tekstivesileiman sisäisesti, mutta sitä ei ole vielä julkaistu.
Satunnaiselle käyttäjälle, joka kysyy reseptiä, mikään näistä ei ole merkityksellinen. Kenelle tahansa, joka julkaisee tekoälyn avulla tuotettua tekstiä, myy sitä tai toimittaa sen asiakkaille, se muuttaa pelin sääntöjä: sisällöstäsi tulee nyt tunnistettava, jota et ole lisännyt itse, etkä näe etkä voi poistaa.
Kaksi tekoälyn tekstivesileiman tyyppiä
Termiä "tekoälyn vesileima" käytetään kahdesta hyvin erilaisesta asiasta. Sen ymmärtäminen, mistä kyseessä on, ratkaisee sen, miten vesileima poistetaan.
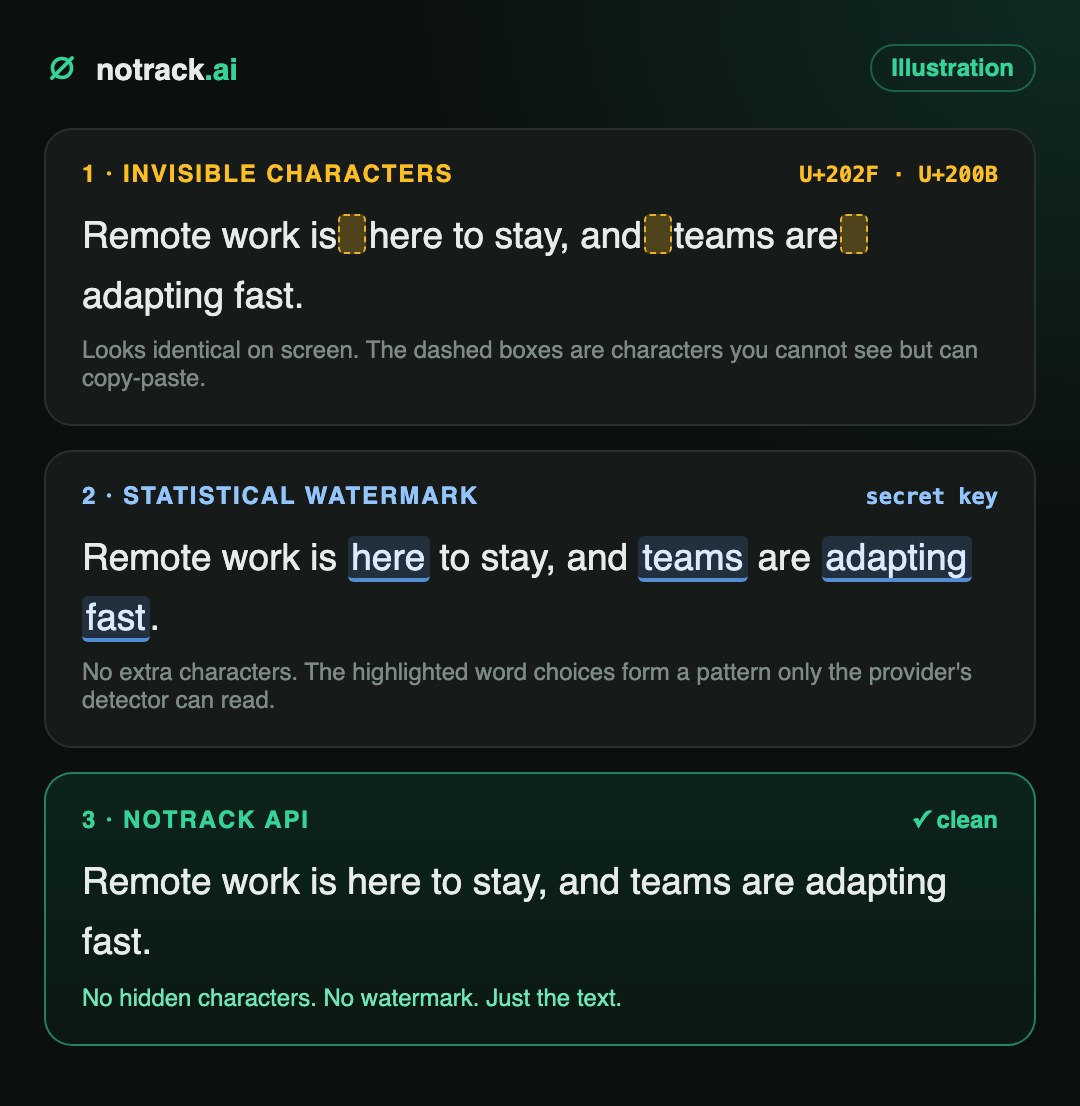
Näkymättömät merkit
Unicode-merkit, jotka näyttävät täsmälleen samalta kuin tavallinen välilyönti tai eivät edes näy lainkaan: nollaleveysvälit, sanaliitokset ja kapeat välilyönnit.
- Helppo havaita yksinkertaisella skriptillä
- Helppo poistaa: poista tai korvaa ne
- Haittaa hiljaa: haku, sanalaskenta, avainsanatunnistus, koodi
Tilastolliset vesileimat
Ei ylimääräisiä merkkejä lainkaan. Mallin sanavalintoja ohjataan salaisella avaimella, jättäen jälkeensä kuvion, jonka vain tarjoajan tunnistin osaa lukea.
- Näkymätön lukijoille ja mille tahansa tekstieditorille
- Kestää liittämis- ja kopioimistoiminnon sekä kevyen muokkauksen
- Heikkenee voimakkaan uudelleenkirjoituksen myötä; täydellinen uudelleenkirjoitus poistaa sen
Näkymättömät merkit: ChatGPT-jakso
Huhtikuussa 2025 tutkijat huomasivat, että OpenAI:n tuolloin juuri lanseeratun o3- ja o4-mini-mallin tekstissä oli kapeita katkeamattomia välilyöntejä (U+202F) kohtien kohdalla, joissa olisi pitänyt olla tavallinen välilyönti. Wordiin liitettynä muotoilumerkit päällä -toiminnolla ne näkyivät pikku pyöreinä pisteiden sijaan. OpenAI totesi, että merkit olivat suuren mittakaavan vahvistusoppimisen erikoisuus, ei tahallinen vesileima, ja myöhemmin merkit lakkasivat esiintymästä. Oppitunti pysyi mielessä: tekoälyteksti voi sisältää näkymättömiä merkkejä, jotka kulkevat mukana jokaisessa leikkaus- ja liitos-toiminnossa CMS:aan.
Tilastolliset vesileimat: SynthID ja Claude
Kielimalli valitsee jokaisen seuraavan sanan todennäköisten ehdokkaiden listalta hieman satunnaisuuden kera. Tilastollinen vesileima korvaa tämän satunnaisuuden pseudo-satunnaisella valinnalla, joka on alustettu salaisella avaimella. Lukijalle teksti näyttää täysin normaalilta. Avaimen hallussa olevalle pitkä riittävä tekstinpätkä paljastaa sanavalintojen kuvion, joka ei käytännössä koskaan syntyisi sattumalta.
Claude:n valitsemat sanat ovat edelleen satunnaisia, mutta nyt sanajonoa voi tarkistaa ja nähdä, onko se yhteensopiva niiden valintojen kanssa, jotka Claude tekisi, jos se käyttäisi avainta.
Anthropic, Miten Claude:n tekstin vesileimaus toimii (elokuu 2026)
Kaksi yksityiskohtaa ovat julkaisijoille tärkeitä. Vesileima vahvistuu sitä mukaa kuin teksti on pidempää, ja Anthropic:n mukaan kevyt muokkaus ei poista sitä, kun taas täydellinen uudelleenkirjoitus, jossa jokainen sana korvataan, poistaa sen.
Kuka vesileimaa tekoälytekstin (syyskuu 2026)
| Palveluntarjoaja | Tekstin vesileima | Tyyppi | Kuka voi tarkistaa sen |
|---|---|---|---|
| Google Gemini | Kyllä, vuodesta 2024 lähtien | Tilastollinen (SynthID) | Google:n SynthID-työkalut |
| Anthropic Claude | Kyllä, uudet mallit elokuusta 2026 lähtien | Tilastollinen (SynthID-pohjainen) | Anthropic:n havaitsemisAPI, yksityinen esikatselu sääntelyviranomaisille, medialle, kouluttajille ja tutkijoille |
| OpenAI ChatGPT | Tekstissä ei vielä; kuvat ja ääni on jo merkitty | Tekstin alkuperä ilmoitettu tavoitteeksi | OpenAI työkalua (kuvat ja ääni käytössä tänään) |
| NoTrack API | Ei | Ei vesileimaa, ei piilotettuja merkkejä | Kukaan |
Miksi vesileimattu teksti haittaa sisällöntuottajia
Google on sanonut vuosien ajan arvioivansa sisältöä laadun perusteella, ei sen tuotantotavan perusteella. Ongelma on ketjun muissa osissa.
- Asiakkaasi voivat tarkistaa sen. Agenssit ja freelancere-toimittajat toimittavat tekstiä asiakkaille, jotka yhä useammin teettävät tekoälytarkistuksen ennen maksua. Vesileima muuttaa tekstin "tekoälyn avustamana ja huolellisesti muokattu" tilaan "merkitty" ilman sävyttelymahdollisuutta.
- Alustat ja markkinapaikat seulovat sisältöä. Julkaisualustat, freelancemarkkinapaikat, mainosverkostot ja arvostelusivustot lisäävät tekoälytunnistusta. Havaittava tunnus on helpoin suodattaa.
- Se paljastaa työskentelytapasi. Vesileima kertoo kenelle tahansa tunnistusohjelmalla varustetulle, mikä työkalu loi sisällön. Sisältöliiketoiminnalle tämä on kilpailuetua, jota et ole hyväksynyt julkaistavaksi.
- Se seuraa tekstiä kaikkialle. Syndikoitu, kevyesti käännetty tai uudelleen julkaistu vesileimallinen teksti säilyttää tunnuksensa. Et voi tarkistaa sitä, mitä et näe.
- Piilotetut merkit rikkovat asioita. Näkymättömät Unicode rikkovat hiljaa sivuston sisäisen haun, täsmäavainsanat, sanamäärät, oikolukutarkistukset ja minkä tahansa koodin, jonka liität. Se voi myös saada kaksi saman näköistä sivua poikkeamaan toisistaan tavu tavulta.
Miten tarkistaa tekstisi tekoälyvesileimoista
1. Näkymättömät merkit: tarkistus sekunneissa
Nopea manuaalinen testi: liitä teksti Microsoft Word:ään ja paina Ctrl+Shift+8 (Cmd+8 Macissa) näyttääksesi muotoilumerkit. Tavalliset välilyönnit näkyvät pisteinä; erikoisvälilyönnit näkyvät pieninä ympyröinä tai muina symboleina. Laajamittaiseen käyttöön käytä skriptiä:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
Yksi huomio, joka kannattaa tietää: nollaleveysinen yhdistäjä (U+200D) on myös osa monia emoji-kuvakkeita, kuten 🚴♂️. Jos osuma osuu emojin sisään, jätä se rauhaan.
2. Tilastolliset vesileimat: et voi tarkistaa niitä itse
Tekstissä ei ole mitään näkyvää. Vain tarjoajan tunnistin, jolla on salainen avain, voi kertoa, onko teksti osio vesileimattu. Anthropic:n tunnistus API on yksityisessä esikatselussa valituille organisaatioille, ei yleisölle. Käytännössä tämä tarkoittaa: jos vesileimamalli on tuottanut tekstin, etkä ole muokannut sitä täysin, se on merkitty.
Miten poistaa tekoälyn vesileimat tekstistä
- Poista näkymättömät merkit. Korvaa erikoismerkit tavallisilla välilyönneillä ja poista nollaleveydelliset merkit. Turvallista, välitöntä ja häviötöntä.
- Kirjoita uudelleen täysin itsenäisellä mallilla. Kevyet muutokset jättävät tilastollisen vesileiman ehjäksi. Täydellinen uudelleenkirjoitus, jossa lauserakenteet ja sanavalinnat muuttuvat kokonaisuudessaan, ei. Käytä mallia, joka ei vesileimaa omaa tuotantoaan, muuten vaihdat vain toisen tunnuksen toiseen.
- Inhimistä tyyliä. Täydellinen uudelleenkirjoitus plus inhimillistämisprompti oppaastamme tekoälytekstin inhimistämiseen poistaa vakiolausekkeet ja tasaisen rytmin, joita tunnistimet pitävät helposti tunnistettavina.
- Tarkista uudelleen. Suorita merkkien tarkistus uudelleen ennen julkaisua. Se vie vain sekunnin.
Vaihe 1 koodissa: puhdista merkit
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Vaihe 2 koodissa: täydellinen uudelleenkirjoitus NoTrack API:n avulla
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content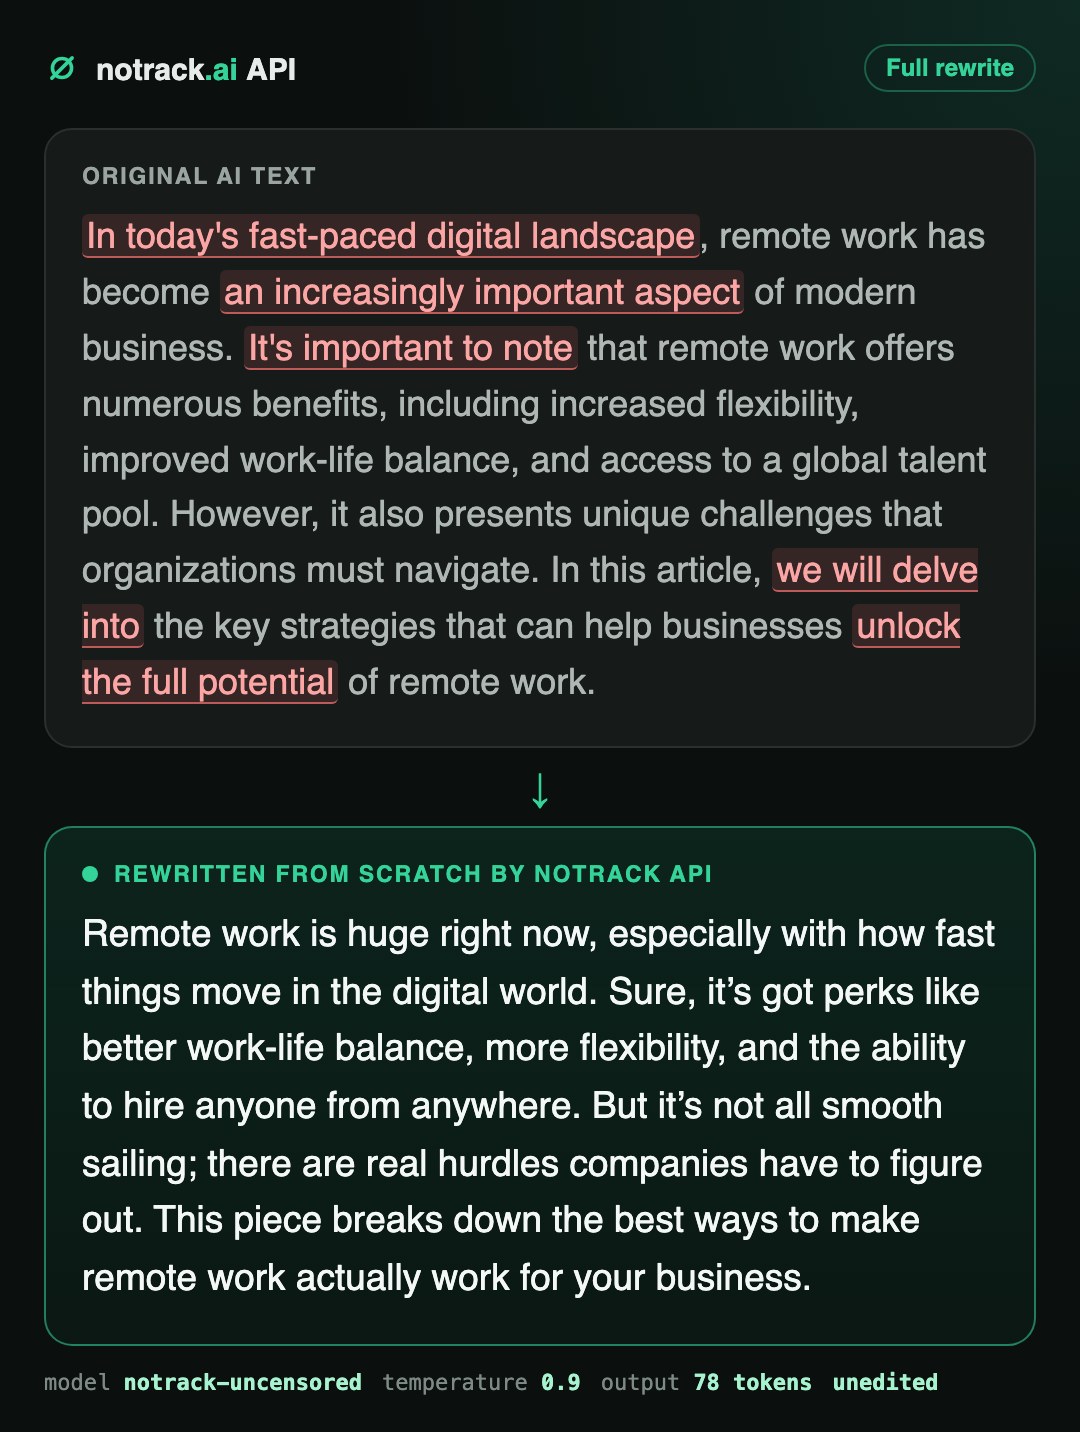
Kirjoita pitkät asiakirjat osio kerrallaan. Tämä säilyttää laadun korkeana ja varmistaa, että teksti muokataan kokonaisuudessaan, ei vain alku.
Tai ohita vesileima kokonaan
Tekstin puhdistaminen jälkikäteen toimii. Sen, että puhdistettavaa ei ole, toimii paremmin. NoTrack API ajaa omaa vesileimamatonta malliaan omilla GPU-laitteillaan. Se ei ole kuori OpenAI:n, Anthropic:n tai Google:n päällä, joten mikään ylävirran tarjoaja ei leimaa tekstiisi tunnuksellaan sen kulkiessa läpi.
- Ei vesileimaa. NoTrack-tuotannossa ei ole tilastollista vesileimaa eikä provenienssiviitettä. Teksti on sinun, siihen ei liity mitään muuta.
- Piilotettuja merkkejä ei ole, mitattu. Skannasimme 26 NoTrack API-vastausta, yhteensä noin 20 000 merkkiä, nollaleveys- ja erikoisvälimerkkien varalta. Yhden hymiön ulkopuolella määrä oli nolla.
- Ei lokitusta. Kysymyksiä ja vastauksia ei kirjoiteta diskille, ei gatewayn eikä mallipalvelimien toimesta. Pidämme pyynnön tunniste- ja token-määrät laskutusta varten. Kukaan ei voi hakea sisältöäsi myöhemmin.
- Ei aiherajauksia. Yökerhoelämää, treffaileminen, aikuisviihde, rahapelit, kryptovaluutat, kumma fantasia: malli kirjoittaa ja muokkaa sisältöä, jota yleiset avustajat kieltävät tai pehmentävät.
- Kaksirivinen vaihto. OpenAI-yhteensopiva. Vaihda perus-URL-osoite muotoon
https://api.notrack.ai/v1ja avain, pidä jäljellä oleva koodisi, työkalut ja lisäosat ennallaan.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
Tuhat 800 sanan artikkelin kirjoittaminen maksaa noin 1,10 dollaria tuottotokeneissa. Ilmainen krediitti ensimmäisellä avaimellasi riittää koko työskentelykulkun testaamiseen ennen kuin käytät senttiäkään. Luo avaimesi tai lue API-dokumentaatio.
UKK
Merkitäänkö ChatGPT:n teksti vesileimalla?
Elokuussa 2026 näin ei ole. OpenAI merkitsee luomiaan kuvia ja ääniä, ja se on ilmoittanut haluavansa laajentaa provenienssin myös tekstiin. Huhtikuussa 2025 jotkin ChatGPT-mallit tuottivat näkymättömiä kapeita ei-välilyöntimerkkejä, jotka OpenAI kuvasi koulutuksen sivutuotteeksi vesileiman sijaan.
Merkitäänkö Claude:n teksti vesileimalla?
Kyllä. Anthropic ilmoitti elokuussa 2026, että uudet Claude-mallit tuottavat vesileimallista tekstiä käyttäen Google:n SynthID-pohjaista tilastollista menetelmää, ja että vanhempien mallien päivitys on käynnissä. Vesileima ei lisää merkkejä; se piilee sanavalinnoissa.
Merkitäänkö Gemini:n teksti vesileimalla?
Kyllä. Google on merkinnyt Gemini:n tekstituotannon vesileimalla SynthID:n avulla vuodesta 2024 lähtien.
Voinko poistaa vesileiman muokkaamalla muutamaa sanaa?
Ei. Tilastolliset vesileimat säilyvät kevyessäkin muokkauksessa. Anthropic itse huomauttaa, että vesileima katoaa, jos teksti kirjoitetaan kokonaan uudelleen ja jokainen sana korvataan. Kirjoita teksti uudelleen kokonaan sellaisen mallin avulla, joka ei lisää omaa vesileimaansa.
Mikä on ChatGPT:n tai Claude:n vesileimanpoistaja?
Se on kaksivaiheinen prosessi: poista näkymättömät merkit ja kirjoita teksti sen jälkeen kokonaan uudelleen riippumattoman mallin avulla. Yllä olevat Python-palautekappaleet tekevät molemmat vaiheet käyttäen NoTrack API:ta uudelleenkirjoitukseen.
Lisääkö NoTrack API vesileiman tai piilotettuja merkkejä?
Ei. NoTrack käyttää omaa malliaan omalla laitteistollaan, eikä se lisää vesileimaa, provenienssimerkkiä eikä piilotettuja merkkejä. Se ei myöskään tallenna syötteitäsi tai tuotoksiasi.
Rangaistaako Google tekoälyn tuottamaa sisältöä?
Google on ilmoittanut palkitsevansa hyödyllistä, korkealaatuista sisältöä riippumatta sen tuotantotavasta. Vesileimat ovat vähemmän merkittäviä sijoituksille ja enemmänkin niille ihmisille ja alustoille, joille sisältöä toimitetaan.