
Mula noong Agosto 2026, ang teksto na kumukuha mo mula sa mga pinakamalaking AI assistant ay hindi na lamang teksto. Ang Claude at Gemini ay ngayon ay nagtatago ng isang estadistikal na watermark sa mga salitang pinipili nila, at ang OpenAI ay nagsabi na ang teksto ang susunod para sa ChatGPT. Hindi mo ito makikita, ngunit maaaring i-check ng tagapagbigay ang pagkakaroon nito, at gayundin ng sinumang ibigay nila ang detector. Kung ikaw ay gumagawa ng mga website, sumusulat para sa mga kliyente o nagpapubliko sa malawak na sukat, narito kung ano ang nasa loob ng AI-generated na teksto ngayon, kung paano i-check ang iyong sariling nilalaman, kung paano alisin ang mga watermark ng AI, at kung paano gumawa ng malinis na teksto gamit ang NoTrack API sa unang pagkakataon.
Ang Hindi Nakikitang Label sa Iyong Nilalaman
Noong Agosto 2, 2026, nagsimulang ipatupad ang mga regulasyon sa transparency ng EU AI Act (Article 50). Ito ay nangangailangan ng mga tagapagbigay ng generative AI na markahan ang mga ginawa ng kanilang mga sistema sa isang paraang nababasa ng makina, upang ito ay maaaring detektahan bilang AI-generated. Ang mga malalabong laboratoryo ay kumilos nang mabilis.
- Anthropic (Claude). Noong Agosto 14, 2026, ang Anthropic nagpahayag na ang mga bagong modelo ng Claude ay nagha-produce ng teksto na naglalaman ng watermark, habang ang mga lumang modelo ay ina-update sa loob ng mga sumusunod na buwan. Isang detector ng API ay kasalukuyang nasa private preview para sa mga regulator, law enforcement, media, mga tagapagpapatunay ng katotohanan, mga mananaliksik at mga organisasyon sa edukasyon.
- Google (Gemini). Ang Gemini ay may watermark na sa kanyang output ng teksto mula noong 2024 gamit ang SynthID, isang paraang ipinubliko ni Google DeepMind sa Nature at open-sourced noong 2024. Ang watermark ng Claude ay nakabatay sa parehong pamamaraan.
- OpenAI (ChatGPT). Ang OpenAI ay may marka na na sa mga ginawang imahe at audio at nagsabi na nais nitong palawakin ang content provenance sa teksto. Ayon sa ulat, mayroon itong nabuo na text watermark sa loob ng kanyang sistema ngunit hindi pa ito inilabas.
Para sa isang casual na gumagamit na humihingi ng reseta, wala nang kahalagahan ang mga ito. Para sa sinumang nagpapubliko ng teksto na sinuportahan ng AI, nagbebenta nito, o iniaalay ito sa mga kliyente, nagbabago ang laro: ang iyong nilalaman ay may kasamang signature na hindi mo idinagdag, hindi mo makikita, at hindi mo mabibawasan.
Dalawang Uri ng Watermark sa Teksto ng AI
Ang "watermark ng AI" ay ginagamit para sa dalawang napaka-kakaibang bagay. Ang pagkakakilanlan kung alin ang iyong kinakaharap ay nagtatakda kung paano ito alisin.
Mga hindi nakikitang karakter
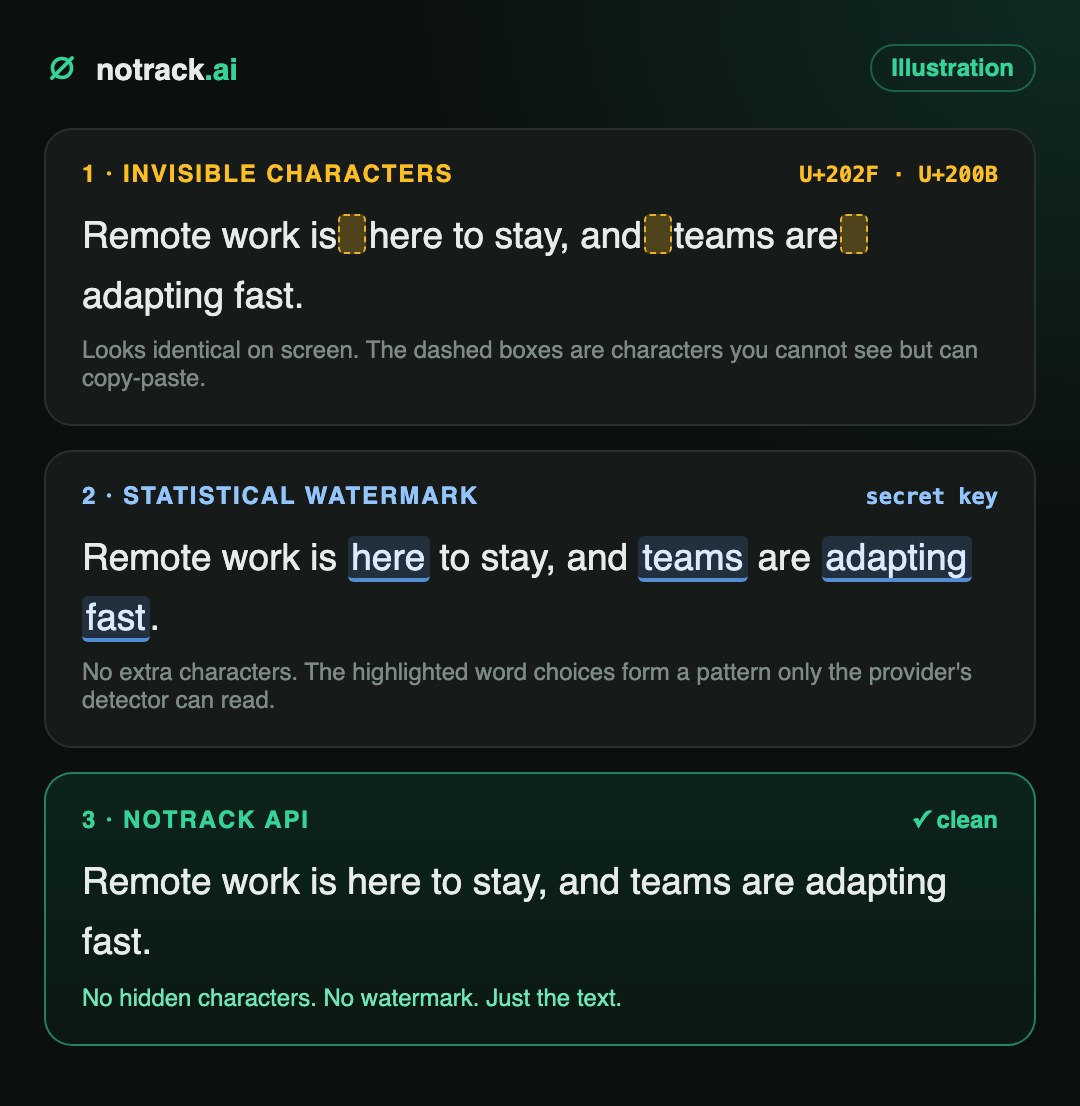
Ang mga karakter na Unicode ay mukhang eksaktong katulad ng isang normal na puwang o parang walang laman: zero-width spaces, word joiners, at narrow no-break spaces.
- Madaling makita gamit ang isang simpleng script
- Madaling alisin: tanggalin o palitan ang mga ito
- Nagiging sanhi ng tahimik na pagkasira: search, word counts, keyword matching, code
Mga statistical na watermark
Walang karagdagang karakter. Ang mga pagpipilian sa salita ng model ay pinangungunahan ng isang lihim na susi, na nag-iwan ng pattern na nababasa lamang ng detector ng tagapagbigay.
- Hindi nakikita ng mga mambabasa at ng anumang text editor
- Nanatili kahit copy-paste at magaan na editing
- Mahina ang epekto kapag mabigat na pagsusulat muli; ang kumpletong pagsusulat muli ay tinatanggal ito.
Mga hindi nakikitang karakter: ang kabanata ng ChatGPT
Noong Abril 2025, napansin ng mga mananaliksik na ang teksto mula sa mga bagong modelo ni OpenAI, ang o3 at o4-mini, ay naglalaman ng mga makitid na karakter na hindi naghihiwalay (U+202F) sa mga lugar kung saan dapat na may karaniwang espasyo. Kapag i-pinaste sa Word habang naka-on ang mga markang pormat, lumalabas ito bilang mga maliit na bilog imbes na puntos. Sinabi ni OpenAI na ang mga karakter ay isang kakaibang katangian ng malawakang reinforcement learning, hindi isang disenyadong watermark, at kalaunan ay tumigil na ang paglitaw ng mga karakter na ito. Nanatiling mahalaga ang aral: ang teksto ng AI ay maaaring magdala ng mga karakter na hindi mo nakikita, at kasama ito sa bawat copy-paste papasok sa iyong CMS.
Mga statistical na watermark: SynthID at Claude
Ang language model ay pipili ng bawat susunod na salita mula sa isang listahan ng mga posibleng kandidato, na may kaunting random na elemento. Ang isang statistical na watermark ay pinalitan ang random na elemento na iyon ng isang pseudo-random na pagpili na naka-seed ng isang lihim na susi. Sa isang mambabasa, mukhang ganap na normal ang teksto. Sa taong hawak ang susi, ang isang sapat na mahabang bahagi ng teksto ay nagpapakita ng isang pattern ng mga pagpili ng salita na halos hindi mangyayari sa random na pagkakataon.
Ang mga salitang pipiliin ni Claude ay nananatiling random, ngunit ngayon, maaaring suriin ang sunod-sunod ng mga salita at tingnan kung ito ay konsistente sa mga pagpipilian na gagawin ni Claude kung ito ay gumagamit ng susi.
Anthropic, Paano gumagana ang watermarking ng teksto ni Claude (Agosto 2026)
Dalawang detalye ang mahalaga para sa mga publisher. Lumalakas ang watermark kapag mas mahaba ang teksto, at ayon kay Anthropic, ang magaan na editing ay hindi nito matatanggal, habang ang kumpletong pagsusulat muli kung saan palitan ang bawat salita ay tatanggalin ito.
Sino ang Nagwo-watermark ng Teksto ng AI (Setyembre 2026)
| Tagapagbigay | Watermark ng teksto | Uri | Sino ang maaaring pagsuriin ito |
|---|---|---|---|
| Google Gemini | Oo, simula noong 2024 | Statistical (SynthID) | Mga kagamitan ni Google na may SynthID |
| Anthropic Claude | Oo, bagong mga modelo mula Agosto 2026 | Pang-statistikal (batay sa SynthID) | Anthropic deteksyon API, pribadong preview para sa mga regulator, midya, guro at mananaliksik |
| OpenAI ChatGPT | Wala pa sa teksto; ang mga imahe at audio ay may marka na | Ang pinagmulan ng teksto ay inangking isang layunin | OpenAI mga kagamitan (para sa mga imahe at audio ngayon) |
| NoTrack API | Hindi | Walang watermark, walang nakatagong karakter | Walang sinuman |
Bakit Nakakapinsala ang Tekstong may Watermark sa mga Gumagawa ng Nilalaman
Ang Google ay nagsabi sa loob ng maraming taon na pinapahalagahan nito ang kalidad ng nilalaman, hindi kung paano ito ginawa. Ang problema ay ang iba pang mga kalahok sa proseso.
- Maaaring i-check ng iyong mga kliyente. Ang mga ahensya at freelancer ay nag-aambag ng teksto sa mga taong lalong kumakapit sa mga pagsusuri gamit ang AI bago sil magbayad. Ang watermark ay nagpapahiwatig ng "AI-assisted and carefully edited" bilang "flagged" nang walang espasyo para sa nuance.
- Ang mga platform at marketplace ay nagpupuno. Ang mga publishing platform, freelance marketplace, ad network at review site ay nagdaragdag ng AI detection. Ang isang detektadong signature ay ang pinakamadaling bagay na mapipili.
- Ipinapakita nito ang iyong workflow. Ang watermark ay nagpapakita sa sinumang may detector kung aling tool ang sumulat ng iyong nilalaman. Para sa isang content business, ito ay impormasyong kompetitibo na hindi mo pinagpasyahan na ipahayag.
- Sumusunod ito sa teksto sa lahat ng lugar. Ang syndicated, lightly translated o reposted na may watermark na teksto ay nananatiling may signature. Hindi mo ma-audit ang hindi mo makikita.
- Ang mga hidden characters ay nagdudulot ng problema. Ang invisible Unicode ay tahimik na nagbubago sa on-site search, exact-match keywords, word counts, spell checkers at anumang code na i-paste mo. Maaari din nitong gawing magkaiba ang dalawang magkaparehong mukhang pahina sa byte para sa byte.
Paano i-check ang iyong teksto para sa AI Watermarks
1. Mga invisible characters: i-check sa loob ng ilang segundo
Mabilis na manual na pagsusuri: i-paste ang teksto sa Microsoft Word at pindutin ang Ctrl+Shift+8 (Cmd+8 sa Mac) upang ipakita ang mga markang pamporma. Ang normal na spaces ay lumilitaw bilang mga tuldok; ang espesyal na spaces ay lumilitaw bilang maliliit na bilog o ibang simbolo. Para sa anumang scale, gumamit ng script:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
Isang mahahalagang paalala: ang zero-width joiner (U+200D) ay bahagi rin ng maraming emoji, tulad ng 🚴♂️. Kung ang hit ay nasa loob ng isang emoji, iwan itong hindi binabagtas.
2. Mga estadistikong watermarks: hindi mo ito maaaring i-check nang sarili
Walang makikita sa teksto. Ang detector ng provider lamang, na may hawak na secret key, ang makakapagsabi kung ang isang talata ay may watermark. Ang Anthropic's detection API ay nasa private preview para sa mga napiling organisasyon, hindi para sa publiko. Sa praktikal na pamamaraan, ito ay nangangahulugang: kung isang watermarking model ang sumulat nito at hindi mo ito ganap na muling isinulat, ito ay may marka.
Paalisin ang AI Watermarks mula sa Teksto
- Alisin ang mga invisible na character. Palitan ang espesyal na espasyo ng karaniwang espasyo at burahin ang mga zero-width na character. Ligtas, mabilis at walang pagkawala ng data.
- Muling isulat nang ganap gamit ang isang independent na model. Ang mga magaan na pag-edit ay nananatiling may estadistikong watermark. Ang isang buong muling pagsusulat, kung saan nagbabago ang istruktura ng pangungusap at pagpili ng salita sa buong teksto, ay hindi. Gamitin ang isang model na hindi nagwawatermark sa sarili nitong output, kung hindi ay palitan mo lamang ang isang signature ng iba.
- I-humanize ang istilo. Ang isang buong muling pagsusulat kasama ang humanizer prompt mula sa aming gabai sa pagpapakatao ng AI na teksto ay nag-aalis ng mga karaniwang parirala at patay na ritmo na mahilig ng mga detector.
- Mag-scan muli. Isagawa ang pagsusuri ng character muli bago i-publish. Kailangan lang ito ng ilang segundo.
Hakbang 1 sa code: linisin ang mga character
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Hakbang 2 sa code: isang buong muling pagsusulat sa pamamagitan ng NoTrack API
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content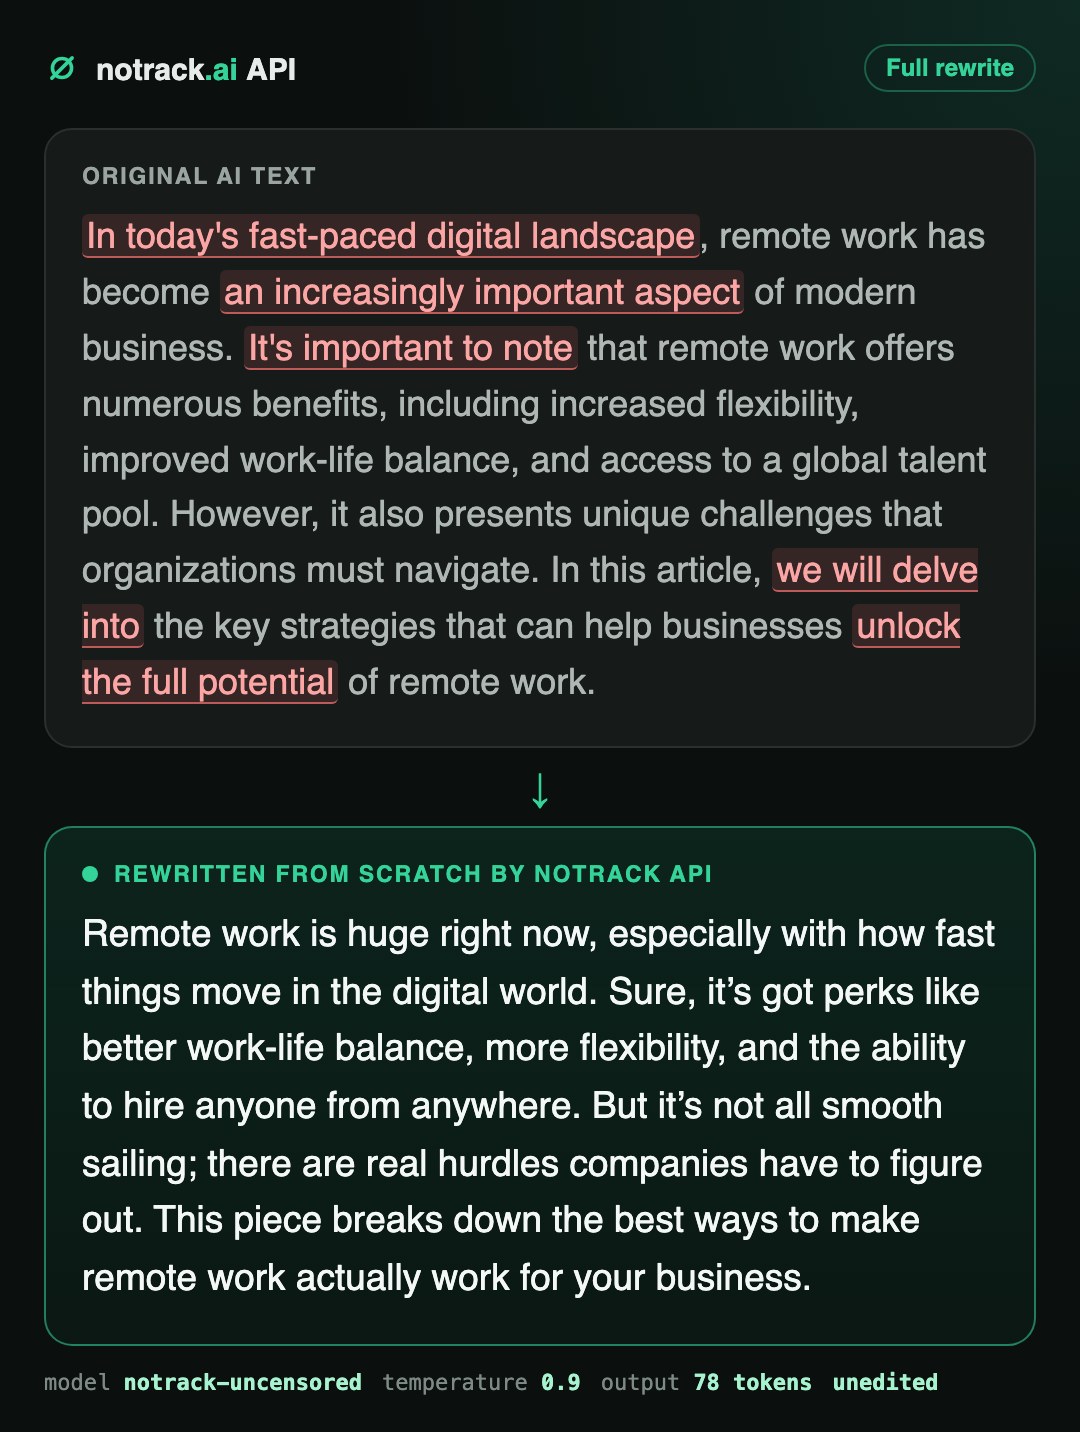
Muling isulat ang mahahabang dokumento bahagi-bahagi. Pinapanatili nito ang mataas na kalidad at siguradong muling isusulat ang bawat bahagi ng teksto, hindi lamang ang pagbubukas.
O Iwasan ang Watermark nang Buong-buo
Ang paglilinis ng teksto pagkatapos ay gumagana. Ang wala nang kailangang linisin ay mas epektibo. Ang NoTrack API ay tumatakbo sa sarili nitong uncensored na model sa sarili nitong GPUs. Hindi ito wrapper ng OpenAI, Anthropic o Google, kaya walang upstream provider ang magpapatibay ng kanyang signature sa iyong teksto habang ito ay dadaan.
- Walang watermark. Ang output ng NoTrack ay walang statistical na watermark at walang signature ng provenance. Ang teksto ay sa iyo na lamang, walang iba nakakabit dito.
- Walong nakatagong character, sinusukat. Sinuri namin ang 26 na mga tugon ng NoTrack API, humigit-kumulang 20,000 karakter, para sa zero-width at espesyal na mga character ng espasyo. Maliban sa isang emoji, ang bilang ay zero.
- Walang logs. Ang mga prompt at tugon ay hindi kailanman isinusulat sa disk, hindi ng gateway at hindi ng mga server ng modelo. Pinapanatili namin ang request ID at bilang ng token para sa billing. Walang makakapaghanap ng iyong nilalaman sa hinaharap.
- Walang filter ng paksa. Nightlife, paghahanap ng kasintahan, adult, gambling, crypto, madilim na nobela: isinusulat at isinusulat muli ng modelo ang mga ito, kung saan ay tumatanggi o binabawasan ng mga mainstream na assistant.
- Dalawang-linya na switch. Compatible sa OpenAI. Baguhin ang base URL sa
https://api.notrack.ai/v1at ang key, panatilihin ang natitirang code, tools, at plugins.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
Ang pagsulat ng 1,000 artikulo na may 800 salita ay nagkakahalaga ng humigit-kumulang $1.10 sa mga output na token. Ang libreng credit sa iyong unang key ay sapat upang subukan ang buong workflow bago ka maglabas ng isang sentimo. Gumawa ng iyong key o basahin ang dokumento ng API.
FAQ
Nagwo-watermark ba ng teksto ang ChatGPT?
Hindi noong Setyembre 2026. Ang OpenAI ay nagmamarka ng mga na-generate na larawan at audio at sinabi nitong nais nitong ipatupad ang provenance sa teksto. Noong Abril 2025, ang ilang mga modelo ng ChatGPT ang nag-produce ng mga invisible na narrow na no-break spaces, na ipinaliwanag ng OpenAI bilang isang training quirk imbes na isang watermark.
Nagwo-watermark ba ng teksto ang Claude?
Oo. Ipinahayag ng Anthropic noong Agosto 2026 na ang mga bagong modelo ng Claude ay nagho-generate ng watermarked na teksto, gamit ang isang statistical na pamamaraan na batay sa SynthID ni Google, at ang mga lumang modelo ay ina-update. Ang watermark ay nagdadagdag ng wala nang mga character; ito ay nakatago sa mga pagpili ng salita.
Nagwo-watermark ba ng teksto ang Gemini?
Oo. Ang Google ay nagwo-watermark na ng teksto ng Gemini gamit ang SynthID simula noong 2024.
Maaari ko bang alisin ang watermark sa pamamagitan ng pag-edit ng ilang salita?
Hindi. Ang mga statistical na watermark ay nananatili kahit sa magaan na editing. Tinitingnan ng Anthropic mismo na ang isang kumpletong pagsusulat muli kung saan palitan ang bawat salita ay nag-aalis ng watermark. Isulat muli nang kumpleto gamit ang isang modelo na hindi nagdadagdag ng sarili nitong watermark.
Ano ang isang ChatGPT o Claude watermark remover?
Ito ay isang dalawang-hakbang na proseso: alisin ang mga invisible na character, pagkatapos ay isulat muli ang teksto nang kumpleto gamit ang isang independent na modelo. Ang mga snippet ng Python sa itaas ay gumagawa ng pareho, gamit ang NoTrack API para sa pagsusulat muli.
Nagdadagdag ba ng watermark o hidden na character ang NoTrack API?
Hindi. Ang NoTrack ay tumatakbo sa sarili nitong modelo sa sarili nitong hardware at hindi nagdadagdag ng watermark, hindi nagdadagdag ng provenance signature at hindi nagdadagdag ng hidden na character. Hindi rin nito inilalagay ang iyong mga prompt o outputs.
Nagpo-penalize ba ang Google sa AI-generated na nilalaman?
Sinabi ng Google na ito ay nagbibigay ng gantimpala sa kapaki-pakinabang, mataas na kalidad na nilalaman anuman ang paraan ng paggawa nito. Ang mga watermark ay mas kaunti ang halaga para sa ranking at mas mahalaga para sa mga tao at platform na iyong iniaalay ang nilalaman.