
Desde agosto de 2026, o texto que recebe dos maiores assistentes de IA já não é apenas texto. Claude e Gemini inserem agora uma marca de água estatística nas palavras que escolhem, e OpenAI anunciou que o texto é o próximo alvo para ChatGPT. Não consegue vê-la, mas o fornecedor pode detetá-la, tal como qualquer entidade a quem seja fornecido um detetor. Se cria websites, escreve para clientes ou publica em escala, aqui fica o que existe atualmente no texto gerado por IA, como verificar o seu próprio conteúdo, como remover marcas de água de IA e como gerar texto limpo desde o início, utilizando a NoTrack API.
A Etiqueta Invisível no Seu Conteúdo
Em 2 de agosto de 2026, entraram em vigor as regras de transparência do Regulamento Europeu sobre a IA (Artigo 50). Estas regras exigem que os fornecedores de IA generativa marquem o que os seus sistemas produzem de forma legível por máquina, para que possa ser detetado como gerado por IA. Os grandes laboratórios agiram rapidamente.
- Anthropic (Claude). Em 14 de agosto de 2026, Anthropic anunciou que os novos modelos Claude geram texto que contém uma marca de água, com modelos mais antigos a serem atualizados nos meses seguintes. Um detetor API já está em pré-visualização privada para reguladores, polícia, media, verificadores de factos, investigadores e organizações educacionais.
- Google (Gemini). Gemini aplica marcas de água às suas saídas de texto desde 2024, através do SynthID, um método que Google DeepMind publicou na Nature e que foi tornado open-source em 2024. A marca de água da Claude baseia-se na mesma abordagem.
- OpenAI (ChatGPT). OpenAI já marca imagens e áudio gerados e anunciou a intenção de estender a proveniência do conteúdo ao texto. Relata-se que desenvolveu internamente uma marca de água para texto, mas ainda não a lançou.
Para um utilizador casual que pede uma receita, nada disto tem importância. Para quem publica texto assistido por IA, o vende ou o entrega a clientes, isto muda as regras do jogo: o seu conteúdo passa a ter uma assinatura que não adicionou, não consegue ver e não consegue desativar.
Dois tipos de marca d'água em texto gerado por IA
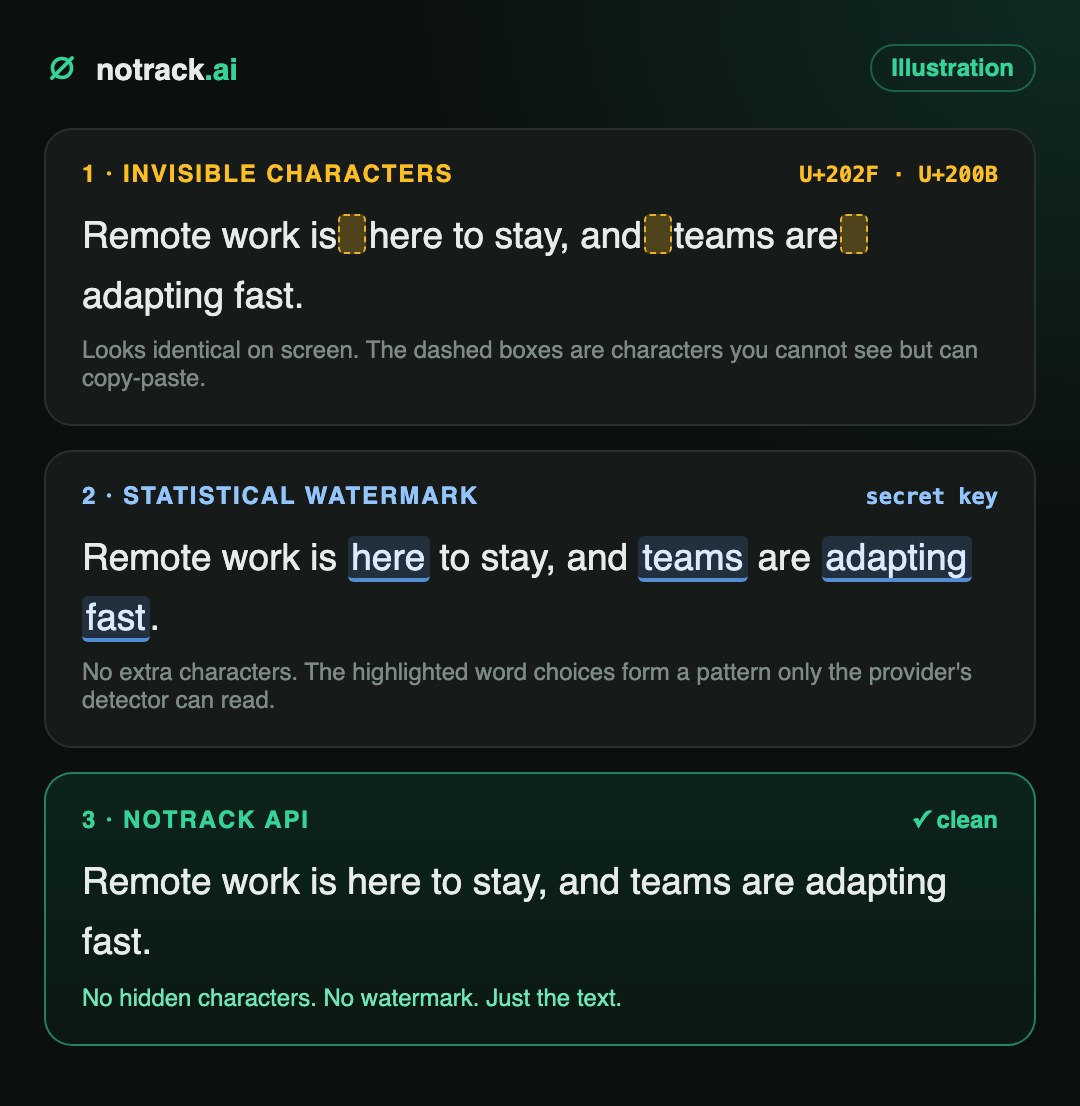
O termo "marca d'água de IA" é usado para duas coisas muito diferentes. Saber com qual está a lidar é decisivo para saber como a remover.
Carateres invisíveis
Carateres Unicode que parecem exatamente um espaço normal ou nada: espaços sem largura, ligadores de palavras e espaços sem quebra de linha estreitos.
- Fáceis de detetar com um script simples
- Fáceis de remover: basta removê-los ou substituí-los
- Quebram coisas em silêncio: pesquisa, contagem de palavras, correspondência de palavras-chave, código
Marcas d'água estatísticas
Sem carateres extras. As escolhas de palavras do modelo são orientadas por uma chave secreta, deixando um padrão que apenas o detetor do fornecedor consegue ler.
- Invisível para os leitores e para qualquer editor de texto
- Sobrevive ao copiar e colar e a edições ligeiras
- Atenua-se com reescrita pesada; uma reescrita completa elimina-o
Carateres invisíveis: o episódio ChatGPT
Em abril de 2025, os investigadores repararam que o texto dos modelos o3 e o4-mini, então recentes, da OpenAI continha espaços invisíveis não separáveis (U+202F) nos locais onde deveria haver um espaço normal. Colados no Word com as marcas de formatação ativas, apareciam como pequenos círculos em vez de pontos. A OpenAI afirmou que os carateres eram uma peculiaridade do reforço de aprendizagem em grande escala e não uma marca de água deliberada, e os carateres deixaram de aparecer mais tarde. A lição ficou: o texto gerado por IA pode conter carateres que nunca vemos, e estes acompanham cada cópia-cola para o seu CMS.
Marcas de água estatísticas: SynthID e Claude
Um modelo de linguagem escolhe cada palavra seguinte a partir de uma lista de candidatos prováveis, com um pouco de aleatoriedade. Uma marca de água estatística substitui essa aleatoriedade por uma escolha pseudoaleatória, sementeada por uma chave secreta. Para um leitor, o texto parece completamente normal. Para quem detém a chave, um trecho suficientemente longo revela um padrão de escolhas de palavras que quase nunca ocorreria por acaso.
As palavras que Claude escolhe continuam a ser aleatórias, mas agora é possível verificar a sequência de palavras e ver se é consistente com as escolhas que Claude faria se estivesse a utilizar a chave.
Anthropic, Como funciona a marca de água de texto do Claude (agosto de 2026)
Dois detalhes são importantes para editores. A marca de água torna-se mais forte quanto maior for o texto e, de acordo com a Anthropic, uma edição ligeira não o elimina, ao passo que uma reescrita completa, onde cada palavra é substituída, sim.
Quem marca texto gerado por IA (setembro de 2026)
| Fornecedor | Marca de água de texto | Tipo | Quem pode verificá-la |
|---|---|---|---|
| Google Gemini | Sim, desde 2024 | Estatística (SynthID) | Ferramentas SynthID do Google |
| Claude Anthropic | Sim, novos modelos desde agosto de 2026 | Estatístico (baseado em SynthID) | Detecção API do Anthropic, pré-visualização privada para reguladores, media, educadores e investigadores |
| ChatGPT OpenAI | Ainda não para texto; imagens e áudio já estão marcados | A proveniência do texto foi anunciada como objetivo | Ferramentas OpenAI (imagens e áudio disponíveis hoje) |
| NoTrack API | Não | Sem marca d'água, sem caracteres ocultos | Ninguém |
Porque é que o texto com marca d'água prejudica os criadores de conteúdo
O Google afirma há anos que classifica o conteúdo com base na qualidade, e não na forma como foi produzido. O problema é o resto da cadeia.
- Os vossos clientes podem verificar. Agências e freelancers entregam textos a pessoas que, cada vez mais, submetem a verificações de IA antes de procederem ao pagamento. Uma marca d'água transforma "assistido por IA e cuidadosamente editado" em "identificado", sem margem para nuances.
- As plataformas e os mercados de trabalho filtram. Plataformas de publicação, mercados de freelancers, redes de publicidade e sites de avaliações estão a implementar a deteção de IA. Uma assinatura detetável é a coisa mais fácil do mundo para filtrar.
- Revela o vosso fluxo de trabalho. Uma marca d'água indica a qualquer pessoa com um detetor qual ferramenta escreveu o vosso conteúdo. Para um negócio editorial, essa é uma informação competitiva que nunca concordaram em publicar.
- Acompanha o texto em todo o lado. Sindicalizado, traduzido ligeiramente ou republicado, o texto com marca d'água mantém a sua assinatura. Não podem auditar o que não conseguem ver.
- Os caracteres ocultos quebram as coisas. Os invisíveis Unicode quebram silenciosamente a pesquisa no site, as palavras-chave de correspondência exata, as contagens de palavras, os corretores ortográficos e qualquer código que coloem. Também podem fazer com que duas páginas visualmente idênticas diferem byte a byte.
Como verificar o vosso texto quanto a marcas d'água de IA
1. Caracteres invisíveis: verificação em segundos
Teste manual rápido: coloem o texto no Microsoft Word e pressionem Ctrl+Shift+8 (Cmd+8 no Mac) para mostrar as marcas de formatação. Os espaços normais aparecem como pontos; os espaços especiais aparecem como pequenos círculos ou outros símbolos. Para qualquer coisa em escala, utilizem um script:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
Uma ressalva que vale a pena saber: o joiner de largura zero (U+200D) é também parte legítima de muitos emojis, como 🚴♂️. Se uma ocorrência estiver dentro de um emoji, deixe-a intacta.
2. Watermarks estatísticos: não os pode verificar sozinho
Não há nada visível no texto. Apenas o detetor do fornecedor, que detém a chave secreta, consegue indicar se um trecho está marcado com watermark. A deteção API da Anthropic está em pré-visualização privada para organizações selecionadas, não para o público em geral. Na prática, isto significa que deve assumir: se um modelo de watermarking o escreveu e não o reescreveu na íntegra, está marcado.
Como remover watermarks de texto gerado por IA
- Remova os caracteres invisíveis. Substitua os espaços especiais por espaços normais e elimine os caracteres de largura zero. Seguro, instantâneo e sem perda de dados.
- Reescreva completamente com um modelo independente. Alterações leves mantêm o watermark estatístico intacto. Uma reescrita total, onde a estrutura das frases e a escolha de palavras mudam em todo o texto, não. Utilize um modelo que não marque com watermark a sua própria saída; caso contrário, estará apenas a substituir uma assinatura por outra.
- Humanize o estilo. Uma reescrita completa combinada com o prompt de humanização do nosso guia para humanizar texto de IA remove as frases feitas e o ritmo uniforme que os detetores adoram.
- Verifique mais uma vez. Execute a verificação de caracteres novamente antes de publicar. Demora apenas um segundo.
Passo 1 no código: limpar os caracteres
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Passo 2 no código: uma reescrita completa através da NoTrack API
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content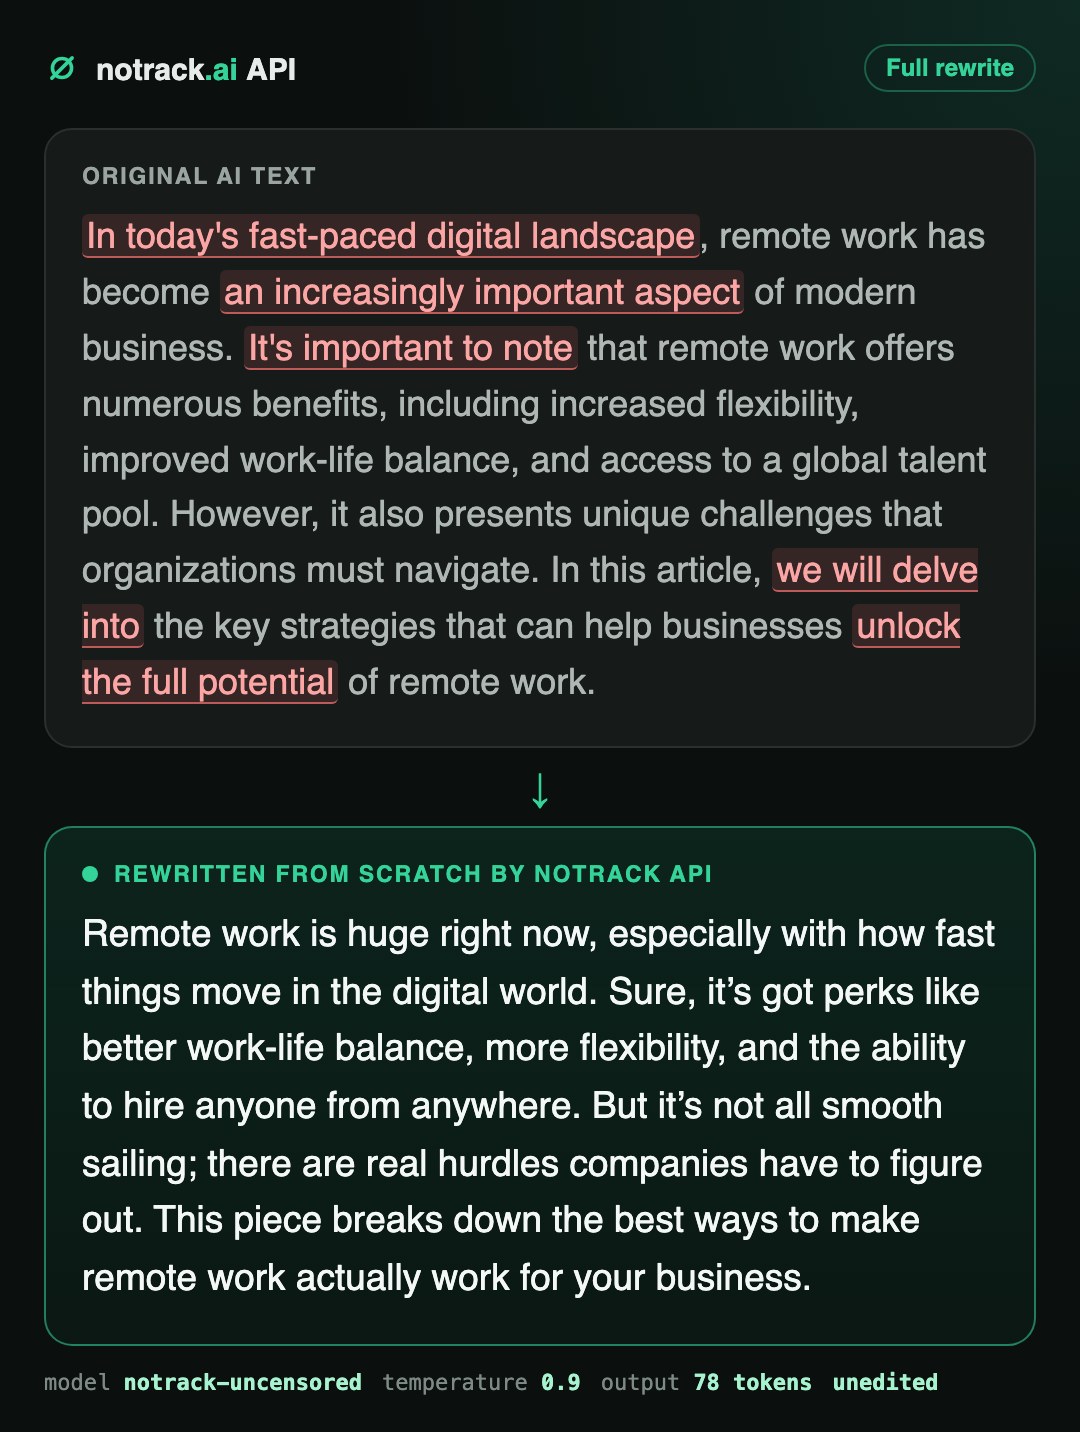
Reescreva documentos longos secção por secção. Isto mantém a qualidade elevada e garante que cada parte do texto é reescrita, e não apenas o início.
Ou evite o watermark completamente
Limpar o texto a posteriori funciona. Não ter nada para limpar funciona melhor. A NoTrack API executa o seu próprio modelo sem censura nas suas próprias GPUs. Não é um wrapper em torno da OpenAI, Anthropic ou Google, pelo que nenhum fornecedor upstream imprime a sua assinatura no seu texto durante o processamento.
- Sem watermark. A saída do NoTrack não inclui marca de água estatística nem assinatura de proveniência. O texto é seu, nada mais fica associado a ele.
- Sem caracteres ocultos, verificado. Analisámos 26 respostas do NoTrack API, totalizando cerca de 20 000 caracteres, à procura de caracteres invisíveis e espaços especiais. À exceção de um emoji, o número de ocorrências foi zero.
- Sem registo de atividades. Os prompts e as respostas nunca são gravados em disco, nem pelo gateway nem pelos servidores do modelo. Guardamos apenas um ID de pedido e as contagens de tokens para faturação. Ninguém consegue consultar o seu conteúdo mais tarde.
- Sem filtro de tópicos. Vida noturna, encontros, adultos, jogos de azar, criptomoedas, ficção sombria: o modelo escreve e reescreve o que os assistentes convencionais recusam ou suavizam.
- Comutação em duas linhas. Compatível com OpenAI. Altere a URL base para
https://api.notrack.ai/v1e a chave, mantendo o resto do seu código, ferramentas e plugins.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
Escrever 1 000 artigos de 800 palavras custa aproximadamente $1,10 em tokens de saída. O crédito gratuito na sua primeira chave é suficiente para testar todo o fluxo de trabalho antes de gastar um cêntimo. Crie a sua chave ou leia a documentação do API.
Perguntas Frequentes
A ChatGPT marca a sua água nos textos?
Até setembro de 2026, não. A OpenAI marca as imagens e o áudio gerados e afirmou pretender estender a proveniência ao texto. Em abril de 2025, alguns modelos da ChatGPT produziram espaços invisíveis estreitos sem quebra, que a OpenAI descreveu como uma peculiaridade do treino, e não como uma marca de água.
A Claude marca a sua água nos textos?
Sim. A Anthropic anunciou em agosto de 2026 que os novos modelos Claude geram texto com marca de água, utilizando um método estatístico baseado na SynthID da Google, e que os modelos mais antigos estão a ser atualizados. A marca de água não adiciona caracteres; reside nas escolhas de palavras.
A Gemini marca a sua água nos textos?
Sim. A Google tem marcado a saída de texto do Gemini com a SynthID desde 2024.
Posso remover uma marca de água editando algumas palavras?
Não. As marcas de água estatísticas sobrevivem a edições ligeiras. A própria Anthropic nota que uma reescrita completa, onde todas as palavras são substituídas, remove a marca de água. Reescreva totalmente com um modelo que não adicione a sua própria marca de água.
O que é um removedor de marca de água ChatGPT ou Claude?
É um processo de duas etapas: remover os caracteres invisíveis e, em seguida, reescrever o texto completamente com um modelo independente. Os excertos da Python acima fazem ambas as coisas, utilizando o NoTrack API para a reescrita.
O NoTrack API adiciona uma marca de água ou caracteres ocultos?
Não. O NoTrack executa o seu próprio modelo no seu próprio hardware e não adiciona marca de água, assinatura de proveniência nem caracteres ocultos. Também não armazena os seus prompts ou saídas.
O Google penaliza o conteúdo gerado por IA?
O Google afirmou recompensar o conteúdo útil e de alta qualidade, independentemente de como foi produzido. As marcas de água importam menos para o ranking e mais para as pessoas e plataformas a quem entrega o conteúdo.