
2026年8月以来、大手AIアシスタントから得られるテキストはもはや単なるテキストではありません。ClaudeとGeminiは選択する単語の中に統計的な透かしを隠すようになり、OpenAIもテキストが次なる対象であると発表しています。ChatGPT。それは目には見えませんが、プロバイダーはそれを確認でき、検出器を渡された誰でもそれを知ることができます。もしあなたがウェブサイトを作ったり、クライアントのために執筆したり、大量に公開したりするのであれば、ここではAI生成テキストに何が潜んでいるか、自分のコンテンツをどう確認するか、AI透かしをどう削除するか、そしてNoTrack APIを使って最初からクリーンなテキストを生成する方法をご紹介します。
あなたのコンテンツに付けられた目印
2026年8月2日、EU AI法(第50条)の透明性ルールが適用開始されました。これは生成AIのプロバイダーに対し、そのシステムが生成したものを機械可読な方法で標識し、AI生成として検出可能にすることを義務付けています。大手ラボは急速に動き出しました。
- Anthropic(Claude)。 2026年8月14日、Anthropicは、新しいClaudeモデルが透かしを含むテキストを生成することを発表しました。古いモデルもその後数ヶ月かけてアップデートされました。規制当局、法執行機関、メディア、ファクトチェッカー、研究者、教育機関向けに、検出APIがすでにプライベートプレビューとして提供されています。
- Google(Gemini)。 Geminiは2024年からテキスト出力に透かしを埋め込んでおり、これはGoogle DeepMindがNature誌で発表した方法であり、2024年にオープンソース化されたSynthIDです。Claudeの透かしも同じアプローチに基づいています。
- OpenAI(ChatGPT)。 OpenAIは生成された画像や音声にはすでに標識を付けており、テキストにもコンテンツの由来(コンテンツ・プロヴェナンス)を拡張したいと考えていると報告されています。内部でテキスト透かしを構築済みですが、まだリリースはされていないとのことです。
レシピを尋ねるようなカジュアルなユーザーにとって、これらはすべてどうでもよい話です。しかし、AI支援によるテキストを公開したり、販売したり、クライアントに納品したりする人にとっては、これはゲームチェンジャーになります。あなたのコンテンツは、あなたが追加したものではなく、確認することもでき、オフにすることもできない「署名」を帯びることになるのです。
AIテキストウォーターマークの2つの種類
「AIウォーターマーク」という用語は、非常に異なる2つのものを指すために使われています。どちらのタイプと戦っているかを知ることが、それを除去する方法を決める鍵となります。
不可視文字
通常のスペースや何もない状態と全く同じに見えるUnicode文字:ゼロ幅スペース、ワードジョイナー、ナローノンブレークスペースなど。
- 簡単なスクリプトで検出可能
- 除去も簡単:これらを削除または置換するだけ
- 検索、単語数、キーワードマッチング、コードなどを静かに破壊する
統計的ウォーターマーク
余分な文字は一切ありません。モデルの単語選択は秘密の鍵によって誘導され、プロバイダの検出器のみが読み取ることのできるパターンを残します。
- 読者やテキストエディタからは不可視
- コピー&ペーストや軽微な編集に耐性がある
- 大規模な書き直しで弱まり、完全な書き直しでは消去される
不可視文字:ChatGPTのエピソード
2025年4月、研究者らはOpenAIの当時新規公開されたo3およびo4-miniモデルのテキストに、通常のスペースの位置に半角スペース(U+202F)が含まれていることを発見した。書式記号を表示させた状態でWordに貼り付けると、それらはドットではなく小さな円として表示された。OpenAIは、これらの文字は大規模強化学習の癖によるものであり、意図的な透かしではないと説明しており、その後これらの文字は表示されなくなった。それでも教訓は残る:AIテキストには見えない文字が含まれる可能性があり、それらはCMSへのコピー&ペーストの際に常に付随して移動する。
統計的透かし:SynthIDとClaude
言語モデルは、次の単語を確からしい候補のリストから選択する際、わずかなランダム性を伴う。統計的透かしは、このランダム性を秘密のキーでシードされた擬似乱数選択に置き換える。読者にはテキストは完全に正常に見えるが、キーを持つ人にとっては、十分な長さのテキストに、偶然にはほとんど起こり得ない単語選択のパターンが現れる。
Claudeが選択する単語は依然としてランダムだが、単語の系列を検査し、Claudeがキーを使用していた場合に選択すると予想される内容と一致するかどうかを確認できる。
Anthropic、Claudeのテキスト透かし機能の仕組み(2026年8月)
出版者にとって重要なのは2点の事実だ。透かしはテキストが長くなるほど強くなり、Anthropicによると、軽い編集では透かしは消えないが、すべての単語が置き換えられる完全な書き直しでは消去される。
AIテキストに透かしを入れるのは誰か(2026年9月)
| プロバイダー | テキスト透かし | タイプ | 誰が確認できるか |
|---|---|---|---|
| Google Gemini | はい、2024年から | 統計的(SynthID) | GoogleのSynthIDツール |
| Anthropic Claude | はい、2026年8月以降の新しいモデル | 統計的(SynthIDベース) | Anthropic検出API、規制当局、メディア、教育者、研究者向けのプライベートプレビュー |
| OpenAI ChatGPT | テキストにはまだ未対応。画像と音声はすでにマーク済み | テキストの出所(プロヴェナンス)が目標として発表 | OpenAIツール(画像と音声は本日対応済み) |
| NoTrack API | いいえ | 透かしなし、隠し文字なし | 誰一人として |
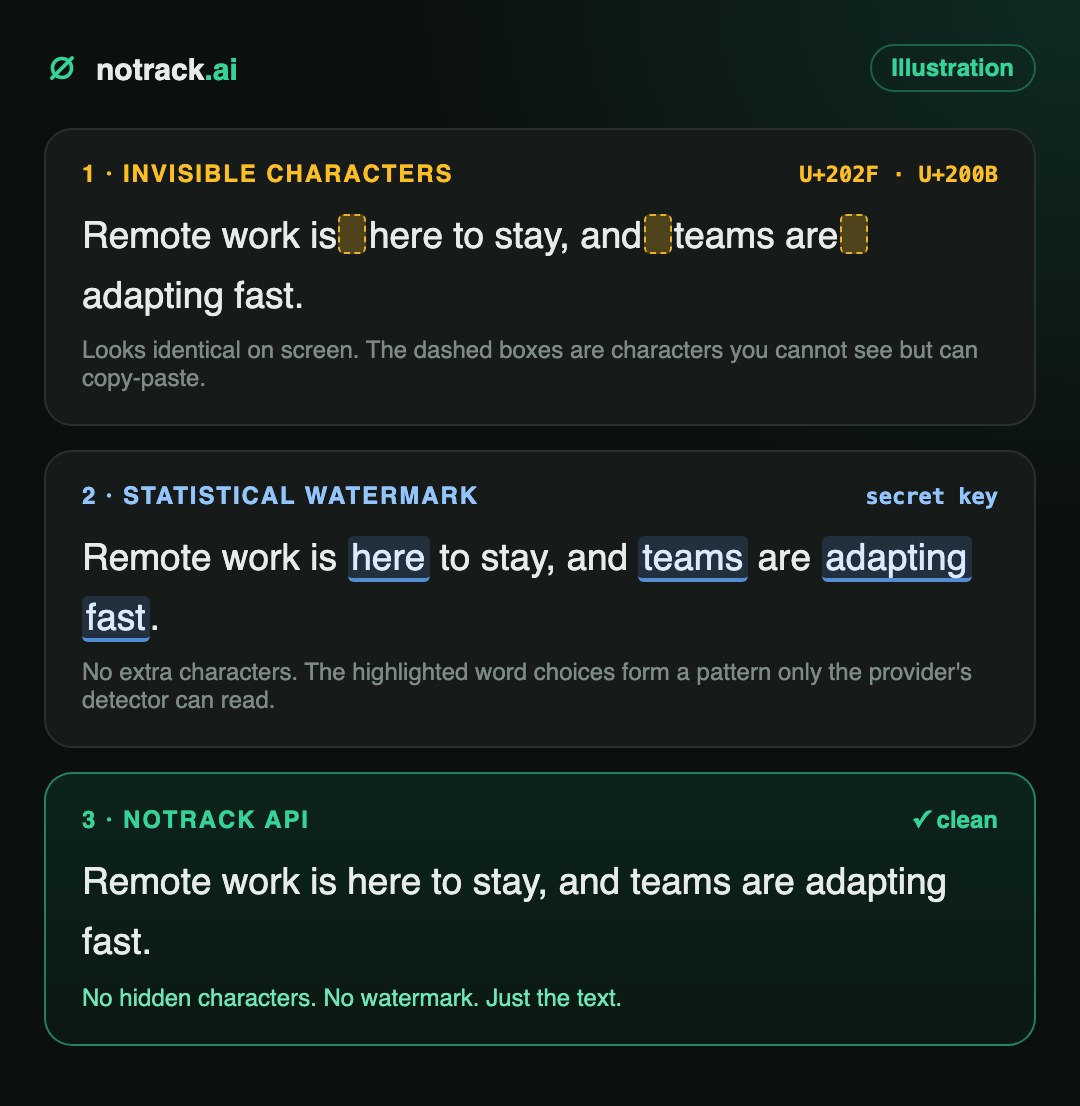
透かし付きテキストがコンテンツクリエイターに与える悪影響
Googleは長年、コンテンツの生成方法ではなく品質に基づいてランキング付けしていると述べています。問題は、そのチェーンの他のすべてにあります。
- あなたのクライアントは確認できます。 代理店やフリーランスは、支払い前にAIチェックを実行する人が増える中、テキストを提供しています。ウォーターマークは、「AI支援を受け、慎重に編集された」コンテンツを、ニュアンスの余地なく「フラグ付き」として扱ってしまいます。
- プラットフォームやマーケットプレイスがスクリーニングしています。 出版プラットフォーム、フリーランスマーケットプレイス、広告ネットワーク、レビューサイトはAI検出機能を追加しています。検出可能なシグネチャは、フィルタリングする際に最も簡単な対象となります。
- あなたのワークフローが明らかになります。 ウォーターマークは、どのツールがコンテンツを作成したかを検出器を持つ誰でも明らかにします。コンテンツビジネスにとって、それは公開に同意しなかった競争上の情報です。
- テキストの随所に付いて回ります。 再配信、軽度の翻訳、または再投稿が行われても、ウォーターマーク付きのテキストはそのシグネチャを保持し続けます。見えないものを監査することはできません。
- 不可視文字が問題を招きます。 不可視のUnicodeは、サイト内検索、完全一致キーワード、文字数カウント、スペルチェッカー、貼り付けたコードなどを静かに壊します。また、外見が同じ2つのページをバイト単位で異なるものにもすることができます。
テキストのAIウォーターマークを確認する方法
1. 不可視文字:数秒でチェック
簡単な手動テスト:テキストをMicrosoft Wordに貼り付け、Ctrl+Shift+8(Macの場合はCmd+8)を押して書式設定記号を表示します。通常のスペースは点として表示され、特殊なスペースは小さな円やその他の記号として表示されます。スケーラブルな規模の場合は、スクリプトを使用してください:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))知っておくべき注意点:ゼロ幅結合文字(U+200D)は、🚴♂️などの絵文字の構成要素としても legitimately に使われています。絵文字の中にこの文字が含まれている場合は、そのままにしておいてください。
2. 統計的透かし:自分で確認できない
テキストには目に見える痕跡はありません。秘密鍵を保持するプロバイダの検出器のみが、その文章が透かし込まれているかどうかを判断できます。Anthropicの検出APIは現在、一般公開ではなく特定の組織向けにプライベートプレビューとして提供されています。実務的には、「透かし込みモデルによって生成され、あなたが完全に書き直していない文章は、透かしが施されているとみなすべき」ということになります。
テキストからAI透かしを削除する方法
- 不可視文字を削除する。 特殊なスペースを通常のスペースに置き換え、ゼロ幅文字を削除します。安全で瞬時、かつ可逆な処理です。
- 独立したモデルで完全に書き直す。 軽微な編集では統計的透かしは残ったままになります。文構造や語彙選択が全体を通じて変わる完全な書き直しであれば、透かしは消去されます。独自の出力に透かしを付けないモデルを使用してください。そうしないと、単に別の署名に置き換えることになってしまいます。
- 人間味のある文体にする。 完全な書き直しに、当社のAIテキストの人間化ガイドにあるヒューマナイザープロンプトを組み合わせることで、検出器が好む定型句や平坦なリズムを排除できます。
- もう一度スキャンする。 公開前に文字チェックを再実行してください。所要時間はわずかです。
コードでのステップ1:文字をクリーンにする
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
コードでのステップ2:NoTrack APIによる完全な書き直し
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content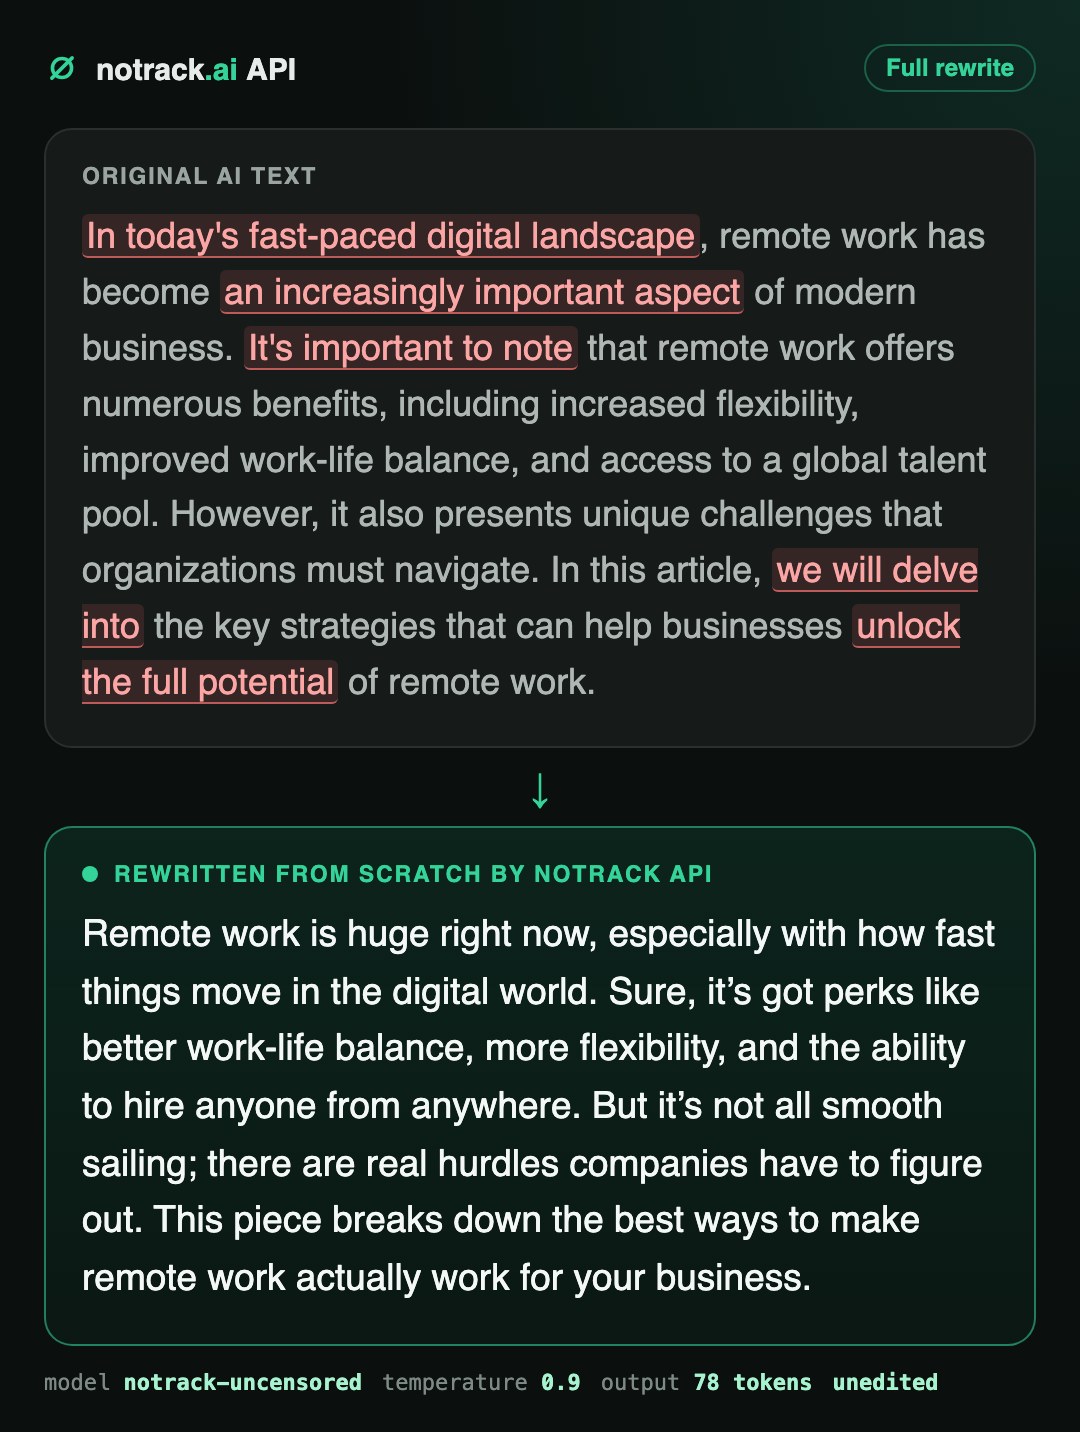
長文書はセクションごとに書き直します。これにより品質を高く保ち、冒頭だけでなくテキストのすべての部分が書き直されることを保証します。
または透かしを完全にスキップする
事後のテキストクリーン化は機能します。クリーン化対象がない状態の方が、さらに効果的です。NoTrack APIは自前のGPU上で独自の無制限モデルを実行しています。OpenAI、Anthropic、Googleのラッパーではないため、処理の過程で上位プロバイダの署名がテキストに刻まれることはありません。
- 透かしなし。 NoTrackの出力には統計的な透かしも、出典を示すシグネチャも含まれません。テキストはあなたのものであり、それ以外の何ものも付随しません。
- 隠し文字なし、測定済み。 私たちは26のNoTrack APIの応答(約20,000文字)をスキャンし、ゼロ幅文字や特殊な空白文字がないか確認しました。絵文字を1つ除き、検出された文字数はゼロでした。
- ログなし。 プロンプトと返信は、ゲートウェイでもモデルサーバーでもディスクに書き込まれません。請求のためにリクエストIDとトークン数だけを保持しています。後からあなたのコンテンツを検索されることはありません。
- トピックフィルタなし。 ナイトライフ、デート、アダルト、ギャンブル、暗号通貨、ダークフィクション:主流のアシスタントが拒否したり、弱めたりする内容を、このモデルは書き出し、書き直します。
- 2行の切り替え。 OpenAI互換。ベースURLを
https://api.notrack.ai/v1に変更し、キーを書き換えるだけで、残りのコード、ツール、プラグインはそのままで使用可能です。
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)800語の記事1,000本を作成するのに要する出力トークンのコストは約$1.10です。最初のキーに付与される無料クレジットがあれば、1セントも使わずにワークフロー全体をテストするのに十分な量です。キーを作成するか、APIのドキュメントをお読みください。
よくある質問
ChatGPTのテキストには透かしが施されますか?
2026年9月時点では、施されていません。OpenAIは生成された画像や音声に透かしを付けており、その範囲をテキストにも広げたい意向を示しています。2025年4月、いくつかのChatGPTモデルは目立たない狭い非改行スペースを生成しましたが、これはOpenAI側が透かしではなく学習上の癖であると説明しています。
Claudeのテキストには透かしが施されますか?
はい。Anthropicは2026年8月、新しいClaudeモデルがGoogleのSynthIDに基づく統計的手法を使って透かし付きのテキストを生成し、旧モデルも更新中であると発表しました。透かしは文字を追加するものではなく、単語の選択の中に存在します。
Geminiのテキストには透かしが施されますか?
はい。Googleは2024年からGeminiのテキスト出力にSynthIDを使って透かしを付けています。
いくつかの単語を編集して透かしを消すことはできますか?
いいえ。統計的な透かしは軽微な編集では消えません。Anthropic自身も、すべての単語が置き換えられる完全な書き直しであれば透かしは消えると指摘しています。透かしを追加しないモデルを使って完全に書き直してください。
ChatGPTやClaudeの透かし除去ツールとは何ですか?
これは2段階のプロセスです。目に見えない文字を削除し、その後、別のモデルでテキストを完全に書き直します。上記のPythonスニペットは両方を実行しており、書き直しにはNoTrack APIを使用しています。
NoTrack APIは透かしや隠し文字を追加しますか?
いいえ。NoTrackは独自のモデルを独自のハードウェアで実行しており、透かし、出典を示すシグネチャ、隠し文字のいずれも追加しません。また、プロンプトや出力も保存しません。
GoogleはAI生成コンテンツに対してペナルティを科しますか?
Googleは、いかなる方法で生成されたものであっても、有用で高品質なコンテンツを評価すると述べています。透かしはランキングにはあまり影響せず、コンテンツを届ける人々やプラットフォームにとってより重要です。