
২০২৬ সালের আগস্ট থেকে বৃহত্তম এআই অ্যাসিস্ট্যান্ট থেকে পাওয়া টেক্সট আর কেবল টেক্সট নেই। Claude এবং Gemini তাদের নির্বাচিত শব্দগুলোর মধ্যে একটি পরিসংখ্যানগত ওয়াটারমার্ক লুকিয়ে রাখে, আর OpenAI ঘোষণা করেছে যে টেক্সট হলো ChatGPT এর পরবর্তী লক্ষ্য। আপনি এটি দেখতে পান না, কিন্তু প্রদানকারী এটি চেক করতে পারে, এবং যাদের কাছে তারা ডিটেক্টর দেয়, তারাও তা চেক করতে পারে। যদি আপনি ওয়েবসাইট তৈরি করেন, ক্লায়েন্টদের জন্য লেখেন বা বৃহৎ পরিসরে প্রকাশ করেন, তবে এআই-তৈরি টেক্সটের ভেতরে আজ কী আছে, আপনার নিজের কন্টেন্ট কীভাবে চেক করবেন, এআই ওয়াটারমার্ক কীভাবে সরানো যায় এবং প্রথমেই NoTrack API ব্যবহার করে পরিষ্কার টেক্সট কীভাবে তৈরি করবেন, তা এখানে আলোচনা করা হয়েছে।
আপনার কন্টেন্টের অদৃশ্য লেবেল
২০২৬ সালের ২ আগস্ট ইউরোপীয় ইউনিয়নের এআই অ্যাক্ট (আর্টিকেল ৫০)-এর স্বচ্ছতা বিধিমালা কার্যকর হয়। এটি জেনারেটিভ এআই প্রদানকারীদের তাদের সিস্টেম দ্বারা উৎপাদিত বিষয়গুলো একটি মেশিন-পাঠযোগ্য উপায়ে চিহ্নিত করতে বাধ্য করে, যাতে এটিকে এআই-তৈরি হিসেবে শনাক্ত করা যায়। বড় ল্যাবগুলো দ্রুত কাজ করেছিল।
- Anthropic (Claude). ২০২৬ সালের ১৪ আগস্ট Anthropic ঘোষণা করেছিল যে নতুন Claude মডেলগুলো এমন টেক্সট তৈরি করে যা একটি ওয়াটারমার্ক ধারণ করে, এবং আগের মডেলগুলো পরবর্তী কয়েক মাসে আপডেট করা হয়েছিল। রেগুলেটর, আইন প্রয়োগকারী সংস্থা, মিডিয়া, তথ্য যাচাইকারী, গবেষক এবং শিক্ষাপ্রতিষ্ঠানদের জন্য একটি ডিটেকশন API ইতিমধ্যে প্রাইভেট প্রিভিউতে রয়েছে।
- Google (Gemini). Gemini ২০২৪ সাল থেকেই এর টেক্সট আউটপুটে ওয়াটারমার্ক যুক্ত করছে SynthID ব্যবহার করে, যা Google DeepMind ন্যাচারে প্রকাশিত একটি পদ্ধতি এবং ২০২৪ সালে ওপেন-সোর্স করা হয়েছিল। Claude-এর ওয়াটারমার্ক একই পদ্ধতির ওপর ভিত্তি করে তৈরি।
- OpenAI (ChatGPT). OpenAI ইতিমধ্যে উৎপাদিত ইমেজ এবং অডিও চিহ্নিত করে এবং জানিয়েছে যে এটি কন্টেন্ট প্রভেনেন্স টেক্সটেও প্রসারিত করতে চায়। জানা গেছে যে এটি অভ্যন্তরীণভাবে একটি টেক্সট ওয়াটারমার্ক তৈরি করেছে কিন্তু এখনও তা চালু করেনি।
একজন সাধারণ ব্যবহারকারীর কাছে যদি রেসিপি চাওয়ার কথা আসে, তবে এই সবকিছুই গুরুত্বহীন। কিন্তু যারা এআই-সহায়ক টেক্সট প্রকাশ করেন, বিক্রি করেন বা ক্লায়েন্টদের কাছে সরবরাহ করেন, তাদের জন্য এটি খেলা বদলে দেয়: আপনার কন্টেন্ট এখন এমন একটি স্বাক্ষর বহন করে যা আপনি যোগ করেননি, যা আপনি দেখতেও পান না এবং যা বন্ধও করা যায় না।
এআই টেক্সট ওয়াটারমার্কের দুই ধরন
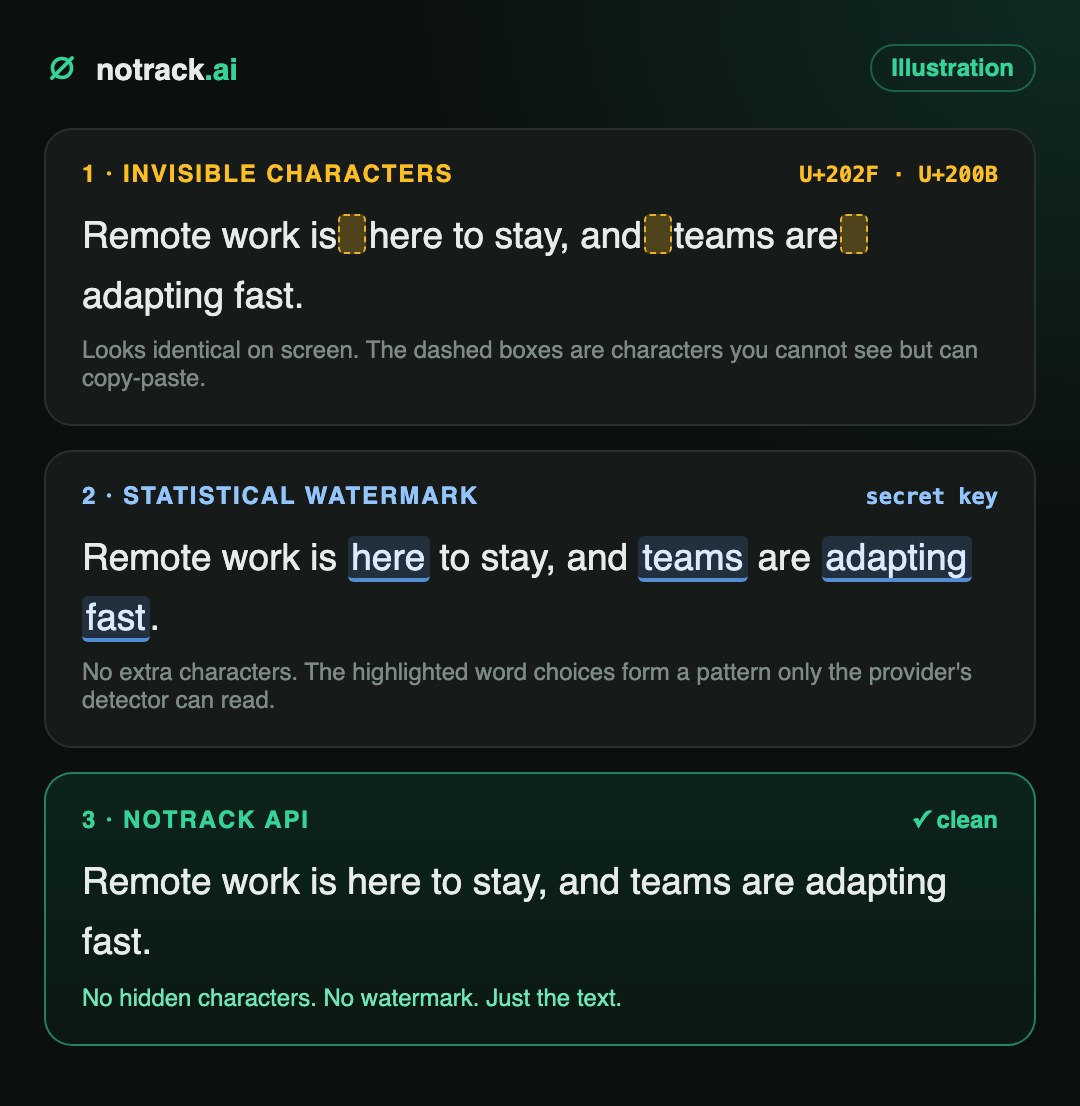
"এআই ওয়াটারমার্ক" শব্দটি দুটি সম্পূর্ণ ভিন্ন বিষয়ের জন্য ব্যবহৃত হয়। আপনি কোনটির সাথে কাজ করছেন তা জানা আপনার জন্য এটি সরানোর পদ্ধতি নির্ধারণে সাহায্য করবে।
অদৃশ্য অক্ষর
Unicode অক্ষর যা দেখতে একদম সাধারণ স্পেসের মতো বা একদম কিছুই নয়: জিরো-উইডথ স্পেস, ওয়ার্ড জয়েনার, সরু নো-ব্রেক স্পেস।
- একটি সহজ স্ক্রিপ্ট দিয়ে এটি শনাক্ত করা সহজ
- সরানো সহজ: এগুলো মুছে ফেলুন বা প্রতিস্থাপন করুন
- চুপচাপ সমস্যা তৈরি করে: সার্চ, শব্দ গণনা, কীওয়ার্ড ম্যাচিং, কোড
পরিসংখ্যানগত ওয়াটারমার্ক
কোনো অতিরিক্ত অক্ষর নেই। মডেলের শব্দ নির্বাচন একটি গোপন কী দ্বারা নিয়ন্ত্রিত হয়, যা একটি প্যাটার্ন তৈরি করে যা শুধুমাত্র প্রদানকারীর ডিটেক্টর পড়তে পারে।
- পাঠকদের জন্য এবং যেকোনো টেক্সট এডিটরের জন্য এটি অদৃশ্য
- কপি-পেস্ট এবং হালকা এডিটিংয়ের মধ্যে এটি টিকে থাকে
- ভারী রিরাইট করলে তা দুর্বল হয়ে পড়ে; সম্পূর্ণ রিরাইট করলে তা সম্পূর্ণভাবে মুছে যায়
অদৃশ্য অক্ষর: ChatGPT পর্ব
২০২৫ সালের এপ্রিল মাসে, গবেষকরা লক্ষ্য করেন যে OpenAI-এর তখনকার নতুন o3 এবং o4-mini মডেলগুলোর টেক্সটে সাধারণ স্পেস দেওয়ার জায়গায় সংকীর্ণ নো-ব্রেক স্পেস (U+202F) ছিল। ফরম্যাটিং মার্কস চালু করে ওয়ার্ডে পেস্ট করলে সেগুলো ডটের বদলে ছোট ছোট বৃত্ত হিসেবে দেখা যেত। OpenAI বলেছিল যে, এই অক্ষরগুলো বৃহৎ স্কেলের রিইনফোর্সমেন্ট লার্নিং-এর একটি বিচিত্রতা, কোনো উদ্দেশ্যমূলক ওয়াটারমার্ক নয়, এবং পরবর্তীতে এই অক্ষরগুলো আর দেখা যায়নি। তবে শিক্ষাটি থেকে গেছে: এআই টেক্সটে এমন অক্ষর থাকতে পারে যা আপনি কখনো দেখতে পান না, আর তা আপনার CMS-এ কপি-পেস্ট করার সময়ও সাথে চলে আসে।
পরিসংখ্যানগত ওয়াটারমার্ক: SynthID এবং Claude
একটি ল্যাঙ্গুয়েজ মডেল পরবর্তী শব্দটি সম্ভাব্য প্রার্থীদের তালিকা থেকে বেছে নেয়, একটু এলোমেলো ভাব সহ। একটি পরিসংখ্যানগত ওয়াটারমার্ক সেই এলোমেলো ভাবকে একটি গোপন কী দিয়ে সেড করা একটি পিওডো-র্যান্ডম চয়েস দিয়ে প্রতিস্থাপন করে। একজন পাঠকের কাছে টেক্সটটি সম্পূর্ণ স্বাভাবিক দেখায়। কিন্তু কী হাতে থাকা একজন মানুষের কাছে, যথেষ্ট দীর্ঘ কোনো অংশ শব্দ নির্বাচনের এমন একটি প্যাটার্ন দেখায় যা কাকতালীয়ভাবে ঘটার প্রায় সম্ভাবনা নেই বললেই চলে।
Claude যে শব্দগুলো বেছে নেয় তারা এখনও এলোমেলো, কিন্তু এখন শব্দগুলোর ক্রম পরীক্ষা করা যায় এবং দেখা যায় যে এটি Claude যদি কীটি ব্যবহার করত তবে সে যে শব্দ বেছে নিত, তার সাথে সামঞ্জস্যপূর্ণ কিনা।
Anthropic, Claude-এর টেক্সট ওয়াটারমার্কিং কীভাবে কাজ করে (আগস্ট ২০২৬)
প্রকাশকদের জন্য দুটি বিষয় গুরুত্বপূর্ণ। টেক্সট যত দীর্ঘ হয়, ওয়াটারমার্ক তত শক্তিশালী হয়, আর Anthropic-এর মতে, হালকা এডিটিং এটি সরিয়ে ফেলতে পারবে না, কিন্তু প্রতিটি শব্দ পরিবর্তন করা হলে সম্পূর্ণ রিরাইট করলে তা সরিয়ে ফেলা যাবে।
কিভাবে এআই টেক্সট ওয়াটারমার্ক করা হয় (সেপ্টেম্বর ২০২৬)
| প্রদানকারী | টেক্সট ওয়াটারমার্ক | ধরন | কে এটি পরীক্ষা করতে পারে |
|---|---|---|---|
| Google Gemini | হ্যাঁ, ২০২৪ সাল থেকে | পরিসংখ্যানগত (SynthID) | Google-এর SynthID টুলস |
| Anthropic Claude | হ্যাঁ, আগস্ট ২০২৬-এর পরের নতুন মডেল | পরিসংখ্যানগত (SynthID-ভিত্তিক) | Anthropic ডিটেকশন API, রেগুলেটর, মিডিয়া, শিক্ষক এবং গবেষকদের জন্য প্রাইভেট প্রিভিউ |
| OpenAI ChatGPT | টেক্সটে এখনো নেই; ইমেজ এবং অডিওতে ইতিমধ্যে মার্ক করা হয়েছে | টেক্সট প্রভেন্যান্স একটি লক্ষ্য হিসেবে ঘোষণা করা হয়েছে | OpenAI টুলস (ইমেজ এবং অডিওর জন্য আজ) |
| NoTrack API | না | ওয়াটারমার্ক নেই, কোনো হাইডেন চ্যারেক্টার নেই | কেউ নয় |
ওয়াটারমার্কযুক্ত টেক্সট কন্টেন্ট ক্রিয়েটরদের কেন ক্ষতি করে
Google বছর ধরে বলে আসছে যে এটি গুণগত মানের ভিত্তিতে কন্টেন্ট র্যাংক করে, কীভাবে তা তৈরি হয়েছে তার ভিত্তিতে নয়। সমস্যা হলো শৃঙ্খলের বাকিরা।
- আপনার ক্লায়েন্টরা এটি চেক করতে পারেন। এজেন্সি এবং ফ্রিল্যান্সাররা এমন মানুষদের কাছে টেক্সট সরবরাহ করছেন যারা পেমেন্ট করার আগে increasingly AI চেক চালাচ্ছেন। একটি ওয়াটারমার্ক "AI-সহায়ক এবং সাবধানে এডিট করা" কন্টেন্টকে "ফ্ল্যাগ করা" হিসেবে চিহ্নিত করে, যেখানে কোনো সূক্ষ্মতা বা নুয়ান্সের সুযোগ থাকে না।
- প্ল্যাটফর্ম এবং মার্কেটপ্লেসগুলো স্ক্রিন করছে। পাবলিশিং প্ল্যাটফর্ম, ফ্রিল্যান্স মার্কেটপ্লেস, বিজ্ঞাপন নেটওয়ার্ক এবং রিভিউ সাইটগুলো AI ডিটেকশন যুক্ত করছে। একটি ডিটেক্টেবল সিগনেচার ফিল্টার করার জন্য সবচেয়ে সহজ জিনিস।
- এটি আপনার ওয়ার্কফ্লো প্রকাশ করে। একটি ওয়াটারমার্ক যেকোনো ডিটেক্টর ব্যবহারকারীকে জানায় কোন টুল আপনার কন্টেন্ট লিখেছিল। একটি কন্টেন্ট বিজনেসের জন্য এটি প্রতিযোগিতামূলক তথ্য যা আপনি প্রকাশ করার জন্য কখনোই সম্মত হননি।
- এটি টেক্সটের সাথে সব জায়গায় চলে। সিন্ডিকেটেড, হালকা অনুবাদিত বা পুনঃপ্রকাশিত ওয়াটারমার্কযুক্ত টেক্সট তার সিগনেচার বজায় রাখে। আপনি যা দেখতে পান না, তার অডিট করা সম্ভব নয়।
- লুকানো অক্ষরগুলো সমস্যা সৃষ্টি করে। অদৃশ্য Unicode সাইটের সার্চ, এক্সাক্ট-ম্যাচ কিওয়ার্ড, শব্দ গণনা, স্পেল চেকার এবং আপনার পেস্ট করা যেকোনো কোডকে নীরবে নষ্ট করে দেয়। এটি একই রকম দেখতে দুটি পেজকেও বাইট-ফর-বাইট ভিন্ন করে তুলতে পারে।
আপনার টেক্সটে AI ওয়াটারমার্ক চেক করার উপায়
১. অদৃশ্য অক্ষর: সেকেন্ডে চেক করুন
দ্রুত ম্যানুয়াল টেস্ট: টেক্সটটি Microsoft Word-এ পেস্ট করুন এবং ফরম্যাটিং মার্কস দেখাতে Ctrl+Shift+8 (Mac-এ Cmd+8) চাপুন। সাধারণ স্পেসগুলো ডট হিসেবে দেখায়; বিশেষ স্পেসগুলো ছোট বৃত্ত বা অন্য কোনো প্রতীক হিসেবে দেখায়। বৃহৎ পরিসরে ব্যবহারের জন্য একটি স্ক্রিপ্ট ব্যবহার করুন:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
একটি সতর্কবার্তা জানা জরুরি: জিরো-উইডথ জয়েনার (U+200D) ইমোজির অনেকের মধ্যে, যেমন 🚴♂️-এর একটি বৈধ অংশ। যদি কোনো ম্যাচ ইমোজির ভেতরে থাকে, তবে সেটি ছেড়ে দিন।
২. পরিসংখ্যানগত ওয়াটারমার্ক: আপনি নিজে এটি চেক করতে পারবেন না
টেক্সটে দেখার মতো কিছু নেই। শুধুমাত্র গোপন কী হাতে থাকা প্রদানকারীর ডিটেক্টরই জানতে পারবেন কোনো অংশ ওয়াটারমার্কযুক্ত কিনা। Anthropic-এর ডিটেকশন API বর্তমানে নির্বাচিত সংস্থাগুলোর জন্য ব্যক্তিগত প্রিভিউতে রয়েছে, সাধারণ জনতার জন্য নয়। ব্যবহারিক ক্ষেত্রে এর অর্থ হলো: যদি একটি ওয়াটারমার্ক মডেল এটি লিখে থাকে এবং আপনি সম্পূর্ণভাবে এটি রিওয়াইট না করে থাকেন, তবে এটি চিহ্নিত থাকবে।
টেক্সট থেকে AI ওয়াটারমার্ক কীভাবে সরানো যায়
- অদৃশ্য অক্ষরগুলো সরান। বিশেষ স্পেসগুলিকে সাধারণ স্পেস দিয়ে প্রতিস্থাপন করুন এবং জিরো-উইডথ অক্ষরগুলো মুছে ফেলুন। নিরাপদ, তাৎক্ষণিক এবং লসলেস পদ্ধতি।
- স্বাধীন মডেল দিয়ে সম্পূর্ণ রিওয়াইট করুন। হালকা সম্পাদনায় পরিসংখ্যানগত ওয়াটারমার্ক অক্ষুণ্ণ থাকে। সম্পূর্ণ রিওয়াইটে বাক্য গঠন এবং শব্দচয়ন বদলে যায়, যা ওয়াটারমার্ককে ভেঙে দেয়। এমন একটি মডেল ব্যবহার করুন যা নিজের আউটপুটে ওয়াটারমার্ক যুক্ত করে না, অন্যথায় আপনি শুধু একটি সাইনেশন অন্যটির বদলে বসিয়ে দেবেন।
- স্টাইলকে মানবিক করুন। সম্পূর্ণ রিওয়াইট এবং আমাদের AI টেক্সট হিউম্যানাইজ করার গাইড থেকে হিউম্যানাইজার প্রম্পট ব্যবহার করলে ডিটেক্টররা যে সাধারণ বাক্যাংশ এবং সমতল লয়্যামার পছন্দ করে, তা দূর হয়ে যায়।
- আবার স্ক্যান করুন। প্রকাশ করার আগে আবার অক্ষর চেক রান করুন। এতে মাত্র এক সেকেন্ড সময় লাগে।
কোডে ধাপ ১: অক্ষর পরিষ্কার করুন
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
কোডে ধাপ ২: NoTrack API-এর মাধ্যমে সম্পূর্ণ রিওয়াইট
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content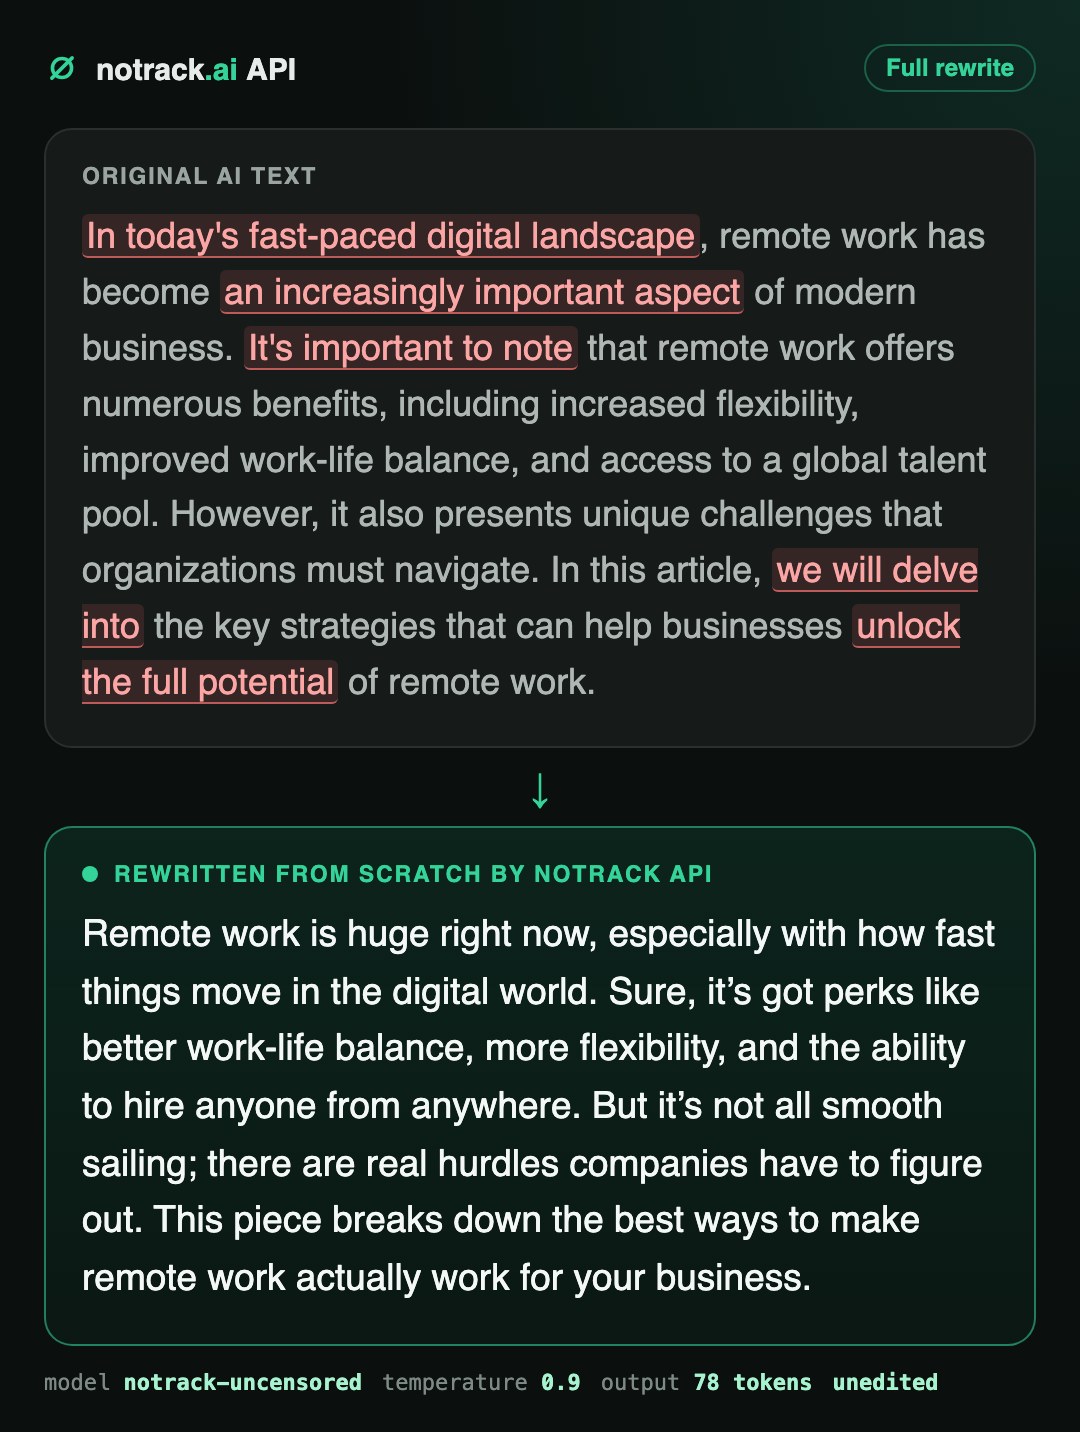
দীর্ঘ ডকুমেন্টগুলো বিভাগভিত্তিক করে রিওয়াইট করুন। এতে গুণমান উচ্চ থাকে এবং নিশ্চিত করে যে টেক্সটের প্রতিটি অংশ রিওয়াইট হয়েছে, শুধু শুরুটি নয়।
অথবা ওয়াটারমার্ক সম্পূর্ণভাবে এড়িয়ে চলুন
পরে থেকে টেক্সট পরিষ্কার করা কাজ করে। পরিষ্কার করার মতো কিছু না থাকলে এটি আরও ভালো কাজ করে। NoTrack API আমাদের নিজস্ব ইউনসেন্সরড মডেল আমাদের নিজস্ব GPU-তে চালায়। এটি OpenAI, Anthropic বা Google-এর ওপর ভিত্তি করে তৈরি ওয়েপার নয়, তাই আপনার টেক্সট যাওয়ার সময় কোনো আপস্ট্রিম প্রদানকারী তার সাইনেশন যুক্ত করে না।
- কোনো ওয়াটারমার্ক নেই। NoTrack-এর আউটপুটে কোনো পরিসংখ্যানগত ওয়াটারমার্ক বা প্রভেনেন্স সই থাকে না। টেক্সটটি আপনার, এর সাথে অন্য কিছু যুক্ত থাকে না।
- কোনো লুকানো অক্ষর নেই, পরিমাপ করা হয়েছে। আমরা ২৬টি NoTrack API রেসপন্স, প্রায় ২০,০০০ অক্ষর স্ক্যান করেছি জিরো-উইডথ এবং বিশেষ স্পেস অক্ষরগুলোর জন্য। একটি ইমোজি ছাড়া সব জায়গায় গণনা শূন্য ছিল।
- কোনো লগ নেই। প্রম্পট এবং উত্তর কখনোই ডিস্কে লেখা হয় না, গ্যাটওয়ে দ্বারাও নয় এবং মডেল সার্ভার দ্বারাও নয়। আমরা বিলিংয়ের জন্য একটি রিকোয়েস্ট আইডি এবং টোকেন সংখ্যা রাখি। কেউ আপনার কন্টেন্ট পরে খুঁজে পাবেন না।
- কোনো টপিক ফিল্টার নেই। নাইটলাইফ, ডেটিং, অ্যাডাল্ট, গ্যাম্বলিং, ক্রিপ্টো, ডার্ক ফিকশন: মডেল লেখে এবং পুনরায় লেখে যা প্রধান সহায়করা প্রত্যাখ্যান করে বা হালকা করে দেয়।
- দুই-লাইনের সুইচ। OpenAI-এর সাথে সামঞ্জস্যপূর্ণ। বেস ইউআরএল
https://api.notrack.ai/v1-এ পরিবর্তন করুন এবং কীটি পরিবর্তন করুন, আপনার কোড, টুলস এবং প্লাগিনের বাকি অংশ একই রাখুন।
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
৮০০ শব্দের ১,০০০টি আর্টিকেল লিখতে আউটপুট টোকেনে প্রায় $১.১০ খরচ হয়। আপনার প্রথম কী-তে ফ্রি ক্রেডিটটি আপনার পুরো ওয়ার্কফ্লোটি পরীক্ষা করার জন্য যথেষ্ট, তার আগে আপনি একটি পয়সাও খরচ করবেন না। আপনার কী তৈরি করুন অথবা API ডকস পড়ুন।
প্রশ্নোত্তর
ChatGPT কি তার টেক্সটে ওয়াটারমার্ক যুক্ত করে?
২০২৬ সালের সেপ্টেম্বর পর্যন্ত নয়। OpenAI তৈরি করা ছবি এবং অডিওতে চিহ্ন দেয় এবং প্রমাণপত্র (provenance) টেক্সটেও প্রসারিত করার ইচ্ছা প্রকাশ করেছে। ২০২৫ সালের এপ্রিলে কিছু ChatGPT মডেল অদৃশ্য সরু নো-ব্রেক স্পেস তৈরি করেছিল, যা OpenAI প্রশিক্ষণের একটি বিশেষত্ব হিসেবে বর্ণনা করেছে, ওয়াটারমার্ক হিসেবে নয়।
Claude কি তার টেক্সটে ওয়াটারমার্ক যুক্ত করে?
হ্যাঁ। Anthropic ২০২৬ সালের আগস্টে ঘোষণা করেছে যে নতুন Claude মডেল Google-এর SynthID-এর ওপর ভিত্তি করে একটি পরিসংখ্যানগত পদ্ধতি ব্যবহার করে ওয়াটারমার্কযুক্ত টেক্সট তৈরি করে, এবং পুরানো মডেলগুলো আপডেট করা হচ্ছে। ওয়াটারমার্ক কোনো অক্ষর যুক্ত করে না; এটি শব্দ নির্বাচনের মধ্যেই থাকে।
Gemini কি তার টেক্সটে ওয়াটারমার্ক যুক্ত করে?
হ্যাঁ। Google ২০২৪ সাল থেকে Gemini-এর টেক্সট আউটপুটে SynthID ব্যবহার করে ওয়াটারমার্ক যুক্ত করে আসছে।
কিছু কথার সম্পাদনা করে ওয়াটারমার্ক অপসারণ করা যায় কি?
না। পরিসংখ্যানগত ওয়াটারমার্ক হালকা সম্পাদনার মধ্যে টিকে থাকে। Anthropic নিজেই উল্লেখ করেছে যে সম্পূর্ণ রিরাইট বা পুনর্লিখন, যেখানে প্রতিটি শব্দ বদলে দেওয়া হয়, তা ওয়াটারমার্ক সরিয়ে দেয়। এমন কোনো মডেল দিয়ে সম্পূর্ণভাবে পুনর্লিখন করুন যা নিজস্ব ওয়াটারমার্ক যুক্ত করে না।
ChatGPT বা Claude ওয়াটারমার্ক রিমুভার কী?
এটি একটি দুই-ধাপের প্রক্রিয়া: অদৃশ্য অক্ষরগুলো সরিয়ে ফেলা এবং তারপর একটি স্বাধীন মডেল দিয়ে সম্পূর্ণ টেক্সট পুনর্লিখন করা। উপরের Python স্নিপেটগুলো দুটোই করে, যেখানে পুনর্লিখনের জন্য NoTrack API ব্যবহার করা হয়েছে।
NoTrack API কি কোনো ওয়াটারমার্ক বা লুকানো অক্ষর যুক্ত করে?
না। NoTrack নিজস্ব হার্ডওয়্যারে নিজস্ব মডেল চালায় এবং কোনো ওয়াটারমার্ক, প্রমাণপত্রের স্বাক্ষর বা লুকানো অক্ষর যুক্ত করে না। এটি আপনার প্রম্পট বা আউটপুটও সংরক্ষণ করে না।
Google কি এআই-তৈরি কন্টেন্টের জন্য শাস্তি দেয়?
Google বলেছে যে এটি সাহায্যকারী এবং উচ্চমানের কন্টেন্টকে যাইভাবে তৈরি করা হোক না কেন, পুরস্কার দেয়। র্যাঙ্কিং-এর জন্য ওয়াটারমার্কের গুরুত্ব কম, আর আপনার কন্টেন্ট যে মানুষ এবং প্ল্যাটফর্মগুলোর কাছে পৌঁছায়, সেখানেই এর গুরুত্ব বেশি।