
Da agosto 2026 il testo che ottieni dai principali assistenti AI non è più solo testo. Claude e Gemini nascondono ora un watermark statistico nelle parole che scelgono, e OpenAI ha annunciato che il testo è il prossimo obiettivo per ChatGPT. Non è visibile a occhio nudo, ma il provider può rilevarlo, così come chiunque riceva un detector da parte loro. Se crei siti web, scrivi per clienti o pubblichi su larga scala, ecco cosa si nasconde nel testo generato dall'IA oggi, come verificare i tuoi contenuti, come rimuovere i watermark AI e come generare testo pulito utilizzando la NoTrack API fin dall'inizio.
L'etichetta invisibile sui tuoi contenuti
Il 2 agosto 2026 sono entrate in vigore le regole di marcatura del Regolamento UE sull'IA (articolo 50). Esse obbligano i fornitori di IA generativa a contrassegnare in modo leggibile dalla macchina ciò che i loro sistemi producono, in modo che possa essere rilevato come generato dall'IA. I grandi laboratori si sono mossi rapidamente.
- Anthropic (Claude). Il 14 agosto 2026 Anthropic ha annunciato che i nuovi modelli Claude generano testo contenente un watermark, con i modelli più vecchi aggiornati nei mesi successivi. Un detector di rilevamento API è già in anteprima privata per autorità di regolamentazione, forze dell'ordine, media, fact-checker, ricercatori e organizzazioni educative.
- Google (Gemini). Gemini applica watermark al suo output testuale dal 2024 tramite SynthID, un metodo pubblicato da Google DeepMind su Nature e open-sourced nel 2024. Il watermark di Claude si basa sullo stesso approccio.
- OpenAI (ChatGPT). OpenAI contrassegna già le immagini e l'audio generati e ha dichiarato di voler estendere la provenienza dei contenuti anche al testo. Si dice abbia sviluppato internamente un watermark per il testo ma non lo abbia ancora rilasciato.
Per un utente occasionale che chiede una ricetta, nessuno di questi aspetti ha importanza. Per chiunque pubblichi testi generati con l'IA, li venda o li consegni ai clienti, però, cambia completamente il quadro: i tuoi contenuti ora portano una firma che non hai aggiunto, non puoi vedere e non puoi disattivare.
Due tipi di watermark per il testo generato dall'IA
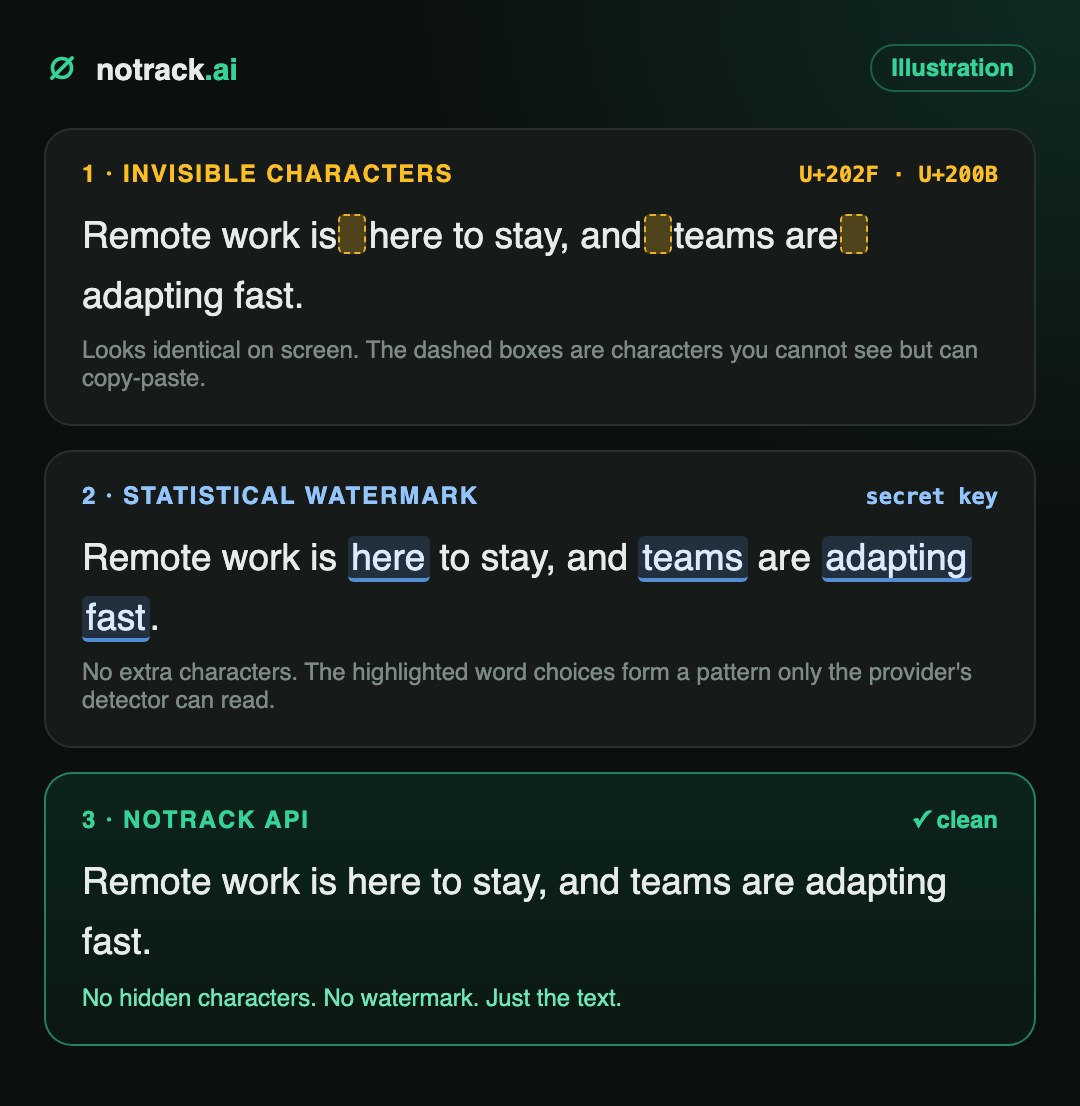
Il termine "watermark per l'IA" viene utilizzato per due cose molto diverse. Sapere con quale tipo hai a che fare determina come rimuoverlo.
Caratteri invisibili
Caratteri Unicode che appaiono esattamente come uno spazio normale o come nulla di visibile: spazi zero-width, separatori di parola (word joiners), spazi non separabili stretti.
- Facili da rilevare con uno script semplice
- Facili da rimuovere: basta eliminarli o sostituirli
- Rompono le cose in silenzio: ricerca, conteggio delle parole, corrispondenza di parole chiave, codice
Watermark statistici
Nessun carattere aggiuntivo. Le scelte lessicali del modello sono guidate da una chiave segreta, lasciando un pattern leggibile solo dal rilevatore del fornitore.
- Invisibili ai lettori e a qualsiasi editor di testo
- Sopravvivono al copia-incolla e a modifiche leggere
- Si indebolisce con riscritture pesanti; una riscrittura completa lo elimina
Caratteri invisibili: l'episodio di ChatGPT
Nell'aprile 2025, i ricercatori hanno notato che il testo dei modelli o3 e o4-mini di OpenAI, appena lanciati, conteneva spazi non separabili stretti (U+202F) nei punti in cui ci si aspettava una normale spaziatura. Incollati in Word con la visualizzazione dei segni di formattazione attivata, apparivano come piccoli cerchi invece che come punti. OpenAI ha spiegato che i caratteri erano un effetto collaterale dell'apprendimento per rinforzo su larga scala, non un watermark deliberato, e in seguito hanno smesso di apparire. La lezione è rimasta comunque: il testo generato dall'IA può contenere caratteri invisibili che viaggiano con ogni copia-incolla nel tuo CMS.
Watermark statistici: SynthID e Claude
Un modello linguistico sceglie ogni parola successiva da un elenco di candidati probabili, introducendo un po' di casualità. Un watermark statistico sostituisce quella casualità con una scelta pseudo-casuale generata da una chiave segreta. Per un lettore il testo appare completamente normale. Per chi possiede la chiave, un brano sufficientemente lungo rivela un modello di scelte lessicali che si verificherebbe quasi per caso.
Le parole scelte da Claude sono ancora casuali, ma ora è possibile analizzare la sequenza di parole e verificare se è coerente con le scelte che Claude avrebbe effettuato se avesse utilizzato la chiave.
Anthropic, Come funziona il watermarking del testo di Claude (agosto 2026)
Due dettagli sono importanti per gli editori. Il watermark diventa più evidente all'aumentare della lunghezza del testo e, secondo Anthropic, una leggera modifica non lo elimina, mentre una riscrittura completa in cui ogni parola viene sostituita sì.
Chi applica il watermark al testo generato dall'IA (settembre 2026)
| Fornitore | Watermark del testo | Tipo | Chi può verificarlo |
|---|---|---|---|
| Google Gemini | Sì, dal 2024 | Statistico (SynthID) | Strumenti SynthID di Google |
| Anthropic Claude | Sì, nuovi modelli da agosto 2026 | Statistico (basato su SynthID) | Rilevamento API di Anthropic, anteprima privata per regolatori, media, educatori e ricercatori |
| OpenAI ChatGPT | Ancora non sul testo; immagini e audio già contrassegnati | La provenienza del testo annunciata come obiettivo | Strumenti OpenAI (immagini e audio oggi) |
| NoTrack API | No | Nessuna filigrana, nessun carattere nascosto | Nessuno |
Perché il testo con filigrana danneggia i creatori di contenuti
Google sostiene da anni di classificare i contenuti in base alla qualità, non al modo in cui sono stati prodotti. Il problema è che tutti gli altri attori della catena.
- I tuoi clienti possono verificare. Le agenzie e i freelance consegnano testi a clienti che sempre più spesso eseguono controlli AI prima di pagare. Un watermark trasforma "AI-assisted and carefully edited" in "segnalato", senza lasciare spazio alle sfumature.
- Le piattaforme e i marketplace effettuano screening. Le piattaforme di pubblicazione, i marketplace freelance, le reti pubblicitarie e i siti di recensioni stanno introducendo il rilevamento AI. Una firma rilevabile è la cosa più semplice al mondo da filtrare.
- Rivela il tuo flusso di lavoro. Un watermark dice a chiunque abbia un detector quale strumento ha scritto il tuo contenuto. Per un'azienda di contenuti, questa è un'informazione competitiva che non hai mai acconsentito a pubblicare.
- Segue il testo ovunque. Sindacato, tradotto in modo leggero o ripubblicato, il testo con watermark mantiene la sua firma. Non puoi verificare ciò che non puoi vedere.
- I caratteri nascosti rompono le cose. Gli invisibili Unicode rompono silenziosamente la ricerca sul sito, le parole chiave esatte, i conteggi delle parole, i correttori ortografici e qualsiasi codice che incolli. Può anche far sì che due pagine apparentemente identiche differiscano byte per byte.
Come verificare il tuo testo per i watermark AI
1. Caratteri invisibili: verifica in pochi secondi
Test manuale rapido: incolla il testo in Microsoft Word e premi Ctrl+Shift+8 (Cmd+8 su Mac) per mostrare i segni di formattazione. Gli spazi normali appaiono come punti; gli spazi speciali appaiono come piccoli cerchi o altri simboli. Per qualsiasi operazione su larga scala, usa uno script:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
Un dettaglio importante da conoscere: il carattere zero-width joiner (U+200D) è anche parte integrante di molti emoji, come 🚴♂️. Se un match si trova all'interno di un emoji, lascialo stare.
2. Watermark statistici: non puoi verificarli da solo
Nel testo non c'è nulla da vedere. Solo il detector del provider, che possiede la chiave segreta, può stabilire se un brano è watermarked. Il detection API di Anthropic è in anteprima privata per organizzazioni selezionate, non per il pubblico. In pratica, significa che devi assumere: se un modello di watermarking l'ha scritto e tu non l'hai riscritto completamente, è marcato.
Come rimuovere i watermark AI dal testo
- Rimuovi i caratteri invisibili. Sostituisci gli spazi speciali con spazi normali ed elimina i caratteri zero-width. Sicuro, istantaneo e senza perdita di dati.
- Riscrivi completamente con un modello indipendente. Modifiche leggere lasciano intatto il watermark statistico. Una riscrittura completa, in cui la struttura delle frasi e la scelta delle parole cambiano in tutto il testo, no. Usa un modello che non appone watermark ai propri output, altrimenti ti limiti a sostituire una firma con un'altra.
- Umanizza lo stile. Una riscrittura completa più il prompt di umanizzazione della nostra guida all'umanizzazione del testo AI rimuove le frasi fatte e il ritmo piatto che piacciono ai detector.
- Scansiona di nuovo. Esegui di nuovo il controllo dei caratteri prima di pubblicare. Ci vuole un secondo.
Passaggio 1 nel codice: pulisci i caratteri
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Passaggio 2 nel codice: una riscrittura completa tramite NoTrack API
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content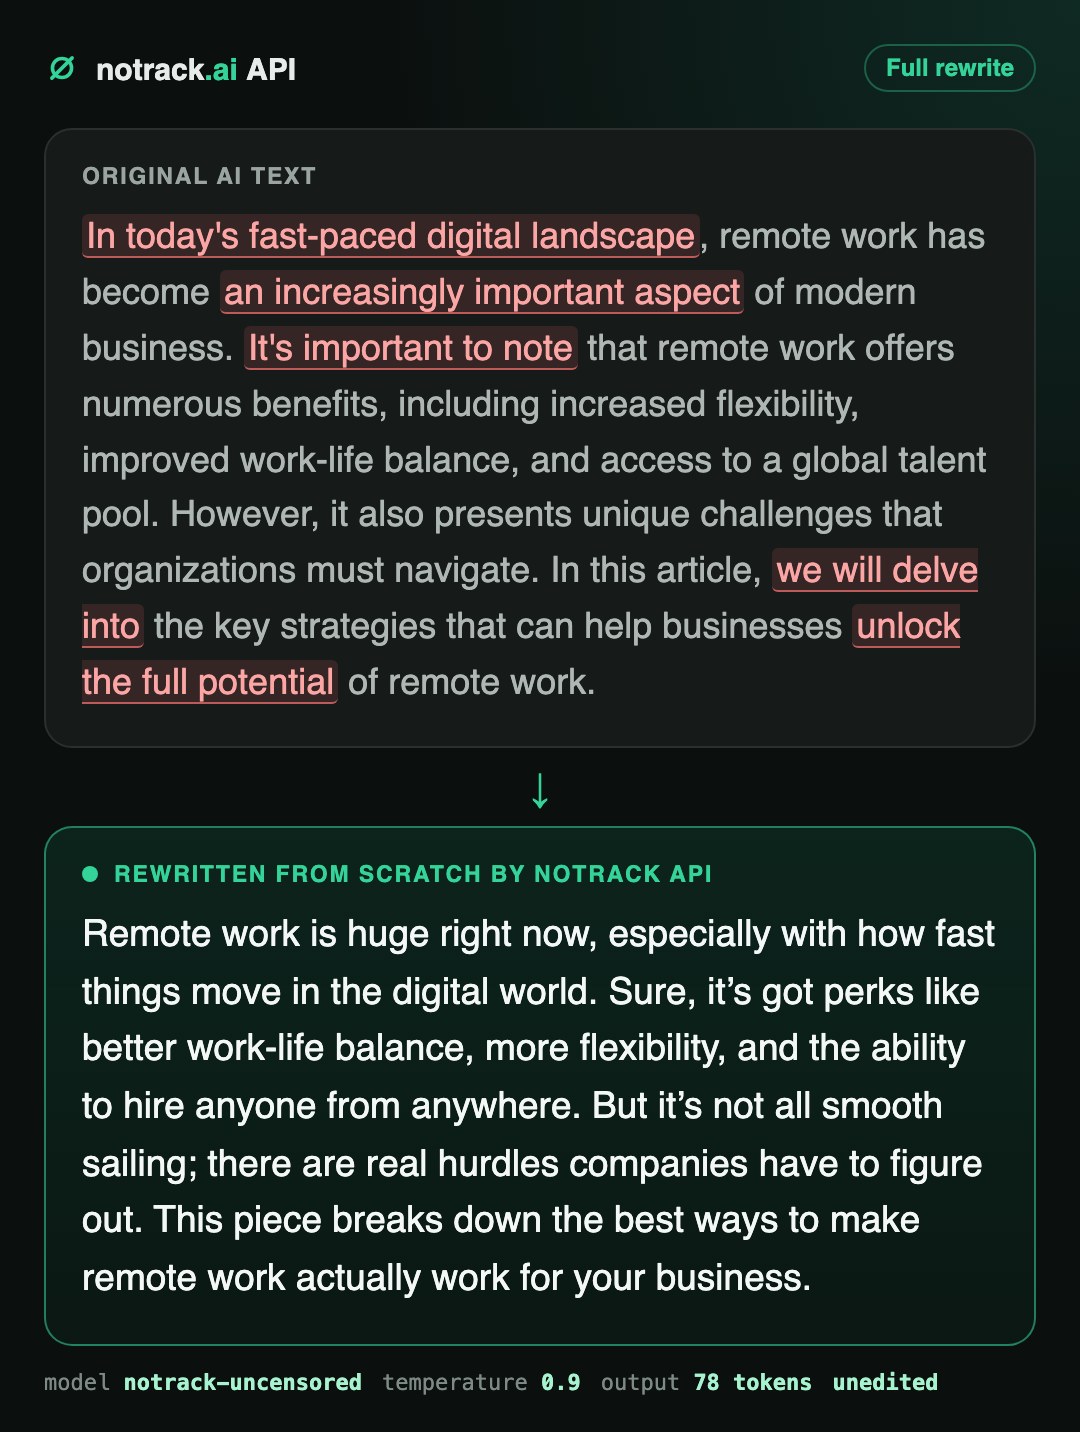
Riscrivi i documenti lunghi sezione per sezione. Questo mantiene alta la qualità e garantisce che ogni parte del testo venga riscritta, non solo l'inizio.
Oppure salta del tutto il watermark
Pulire il testo a posteriori funziona. Non avere nulla da pulire funziona meglio. NoTrack API esegue il nostro modello uncensored su GPU di nostra proprietà. Non è un wrapper di OpenAI, Anthropic o Google, quindi nessun provider upstream appone la sua firma sul tuo testo durante il passaggio.
- Nessun watermark. L'output di NoTrack non presenta filigrana statistica né firma di provenienza. Il testo è tuo, non è associato nient'altro.
- Nessun carattere nascosto, verificato. Abbiamo analizzato 26 risposte di NoTrack API, per circa 20.000 caratteri, alla ricerca di caratteri zero-width e spazi speciali. Escluso un emoji, il conteggio è stato zero.
- Nessun log. Prompt e risposte non vengono mai scritti su disco, né dal gateway né dai server del modello. Conserviamo un ID richiesta e i conteggi dei token per la fatturazione. Nessuno potrà recuperare i tuoi contenuti in seguito.
- Nessun filtro tematico. Vita notturna, appuntamenti, adulti, gioco d'azzardo, criptovalute, narrativa dark: il modello scrive e riscrive ciò che gli assistenti mainstream rifiutano o attenuano.
- Commutazione su due righe. Compatibile con OpenAI. Modifica l'URL di base in
https://api.notrack.ai/v1e la chiave, mantenendo il resto del tuo codice, strumenti e plugin.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
Scrivere 1.000 articoli da 800 parole costa circa 1,10 $ in token di output. Il credito gratuito sulla tua prima chiave è sufficiente per testare l'intera workflow prima di spendere un solo centesimo. Crea la tua chiave o leggi la documentazione di API.
FAQ
ChatGPT applica un watermark al suo testo?
Non a settembre 2026. OpenAI marca le immagini e l'audio generati e ha dichiarato di voler estendere la provenienza anche al testo. Nell'aprile 2025 alcuni modelli ChatGPT hanno prodotto spazi bianchi stretti invisibili e non interrotti, che OpenAI ha descritto come un bizzarro effetto collaterale dell'addestramento piuttosto che un vero watermark.
Claude applica un watermark al suo testo?
Sì. Anthropic ha annunciato ad agosto 2026 che i nuovi modelli Claude generano testo con watermark, utilizzando un metodo statistico basato su SynthID di Google, e che i modelli più vecchi sono in fase di aggiornamento. Il watermark non aggiunge caratteri; risiede nelle scelte lessicali.
Gemini applica un watermark al suo testo?
Sì. Google applica un watermark all'output testuale di Gemini con SynthID dal 2024.
Posso rimuovere un watermark modificando poche parole?
No. I watermark statistici sopravvivono a modifiche leggere. Anthropic stesso nota che una riscrittura completa in cui ogni parola viene sostituita elimina il watermark. Riscrivi completamente il testo con un modello che non aggiunga il proprio watermark.
Cos'è un rimozione watermark per ChatGPT o Claude?
È un processo in due fasi: rimuovere i caratteri invisibili e poi riscrivere completamente il testo con un modello indipendente. Gli snippet Python sopra riportati fanno entrambe le cose, utilizzando NoTrack API per la riscrittura.
NoTrack API aggiunge un watermark o caratteri nascosti?
No. NoTrack esegue il proprio modello su hardware dedicato e non aggiunge watermark, firme di provenienza né caratteri nascosti. Inoltre, non memorizza i tuoi prompt o le tue risposte.
Google penalizza i contenuti generati dall'IA?
Google ha dichiarato di premiare i contenuti utili e di alta qualità, indipendentemente da come sono stati prodotti. I watermark contano meno per il ranking e contano di più per le persone e le piattaforme a cui consegni i contenuti.