
Sinds augustus 2026 is de tekst die je van de grootste AI-assistenten krijgt niet langer zomaar tekst. Claude en Gemini verbergen nu een statistisch watermerk in de woorden die ze kiezen, en OpenAI heeft aangegeven dat tekst de volgende stap is voor ChatGPT. Je kunt het niet zien, maar de aanbieder kan erop controleren, en iedereen aan wie ze een detector geven ook. Als je websites bouwt, voor klanten schrijft of op grote schaal publiceert, lees dan hier wat er vandaag in door AI gegenereerde tekst zit, hoe je je eigen content controleert, hoe je AI-watermerken verwijdert en hoe je van tevoren schone tekst genereert met de NoTrack API.
Het onzichtbare label op je content
Op 2 augustus 2026 zijn de transparantieregels van de EU AI Act (Artikel 50) van kracht geworden. Deze vereisen dat aanbieders van generatieve AI aangeven wat hun systemen produceren op een machineleesbare manier, zodat het als door AI gegenereerd kan worden gedetecteerd. De grote labs waren snel.
- Anthropic (Claude). Op 14 augustus 2026 kondigde Anthropic aan dat nieuwe Claude-modellen tekst genereren die een watermerk bevat, waarbij oudere modellen in de daaropvolgende maanden werden bijgewerkt. Een detectieAPI is al in private preview beschikbaar voor regelgevers, rechtshandhavingsinstanties, media, factcheckers, onderzoekers en onderwijsinstellingen.
- Google (Gemini). Gemini watermarkt zijn tekstuitvoer sinds 2024 met SynthID, een methode die Google DeepMind publiceerde in Nature en in 2024 open source maakte. Het watermerk van Claude is gebaseerd op dezelfde aanpak.
- OpenAI (ChatGPT). OpenAI markeert al gegenereerde afbeeldingen en audio en heeft aangegeven de contentprovenance naar tekst te willen uitbreiden. Het zou volgens berichten een watermerk voor tekst intern hebben ontwikkeld, maar nog niet hebben uitgebracht.
Voor een gebruiker die gewoon een recept opzoekt, doet dit er niet toe. Voor iedereen die met AI-ondersteunde tekst publiceert, deze verkoopt of aan klanten levert, verandert het echter alles: je content draagt nu een handtekening die je niet hebt toegevoegd, niet kunt zien en niet kunt uitzetten.
Twee soorten AI-watermerk
De term 'AI-watermerk' wordt gebruikt voor twee zeer verschillende dingen. Het is belangrijk om te weten met welke variant je te maken hebt, omdat dit bepaalt hoe je het verwijdert.
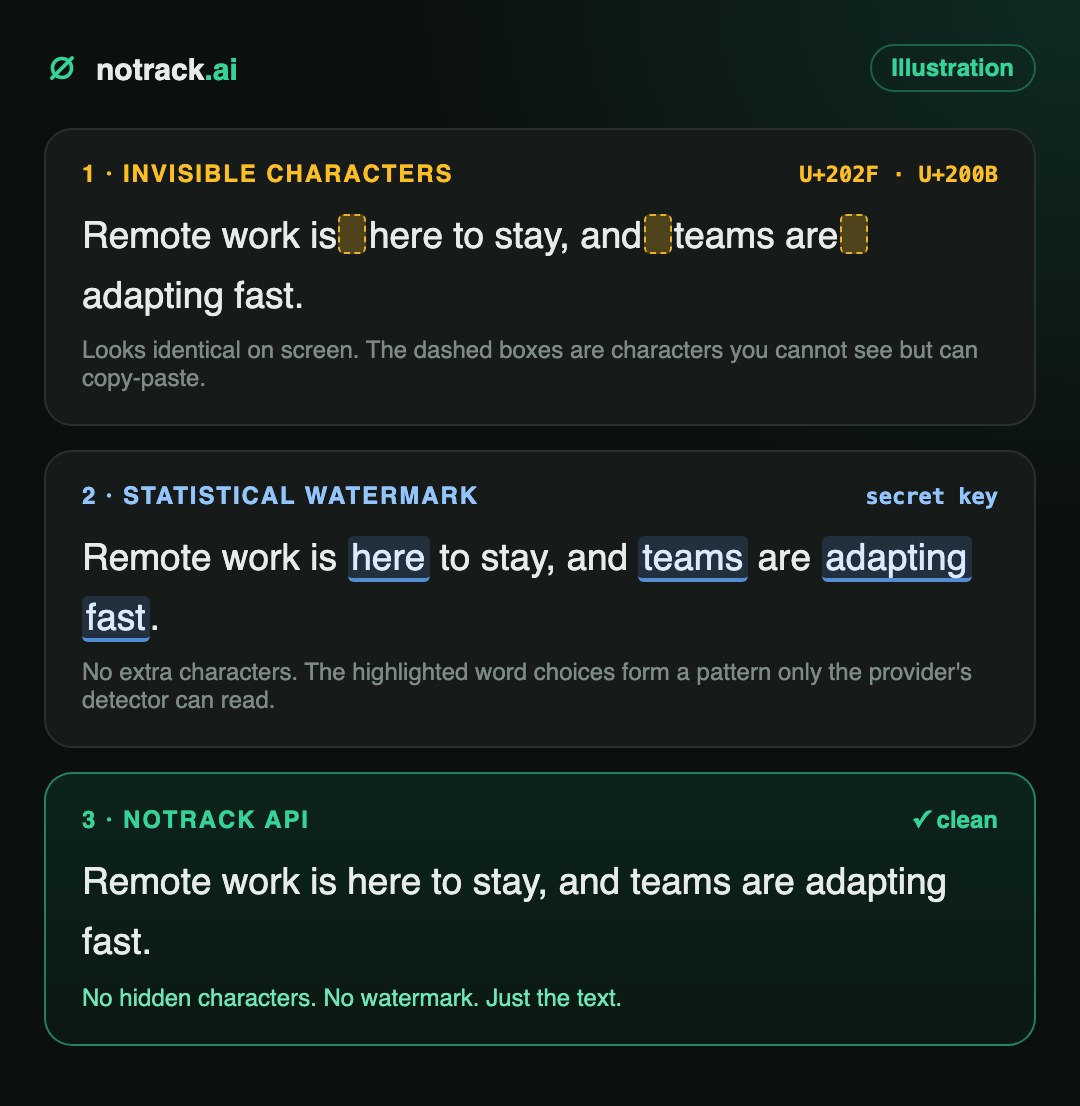
Onzichtbare tekens
Unicode-tekens die er precies uitzien als een normale spatie of helemaal niets zijn: zero-width spaces, word joiners en smalle niet-afbreekbare spaties.
- Gemakkelijk te detecteren met een eenvoudige script
- Gemakkelijk te verwijderen: verwijder ze of vervang ze
- Dingens stil verstoren: zoeken, woordtellingen, trefwoordmatching, code
Statistische watermerken
Geen extra tekens. De woordkeuzes van het model worden gestuurd door een geheime sleutel, wat een patroon achterlaat dat alleen de detector van de aanbieder kan lezen.
- Onzichtbaar voor lezers en voor elke teksteditor
- Overleeft kopiëren-plakken en licht bewerken
- Verzwakt bij zware herschrijving; een volledige herschrijving verwijdert het
Onzichtbare tekens: de aflevering ChatGPT
In april 2025 merkten onderzoekers op dat tekst van de toen nieuwe OpenAI-modellen o3 en o4-mini smalle niet-afbreekende spaties (U+202F) bevatte op plekken waar een normale spatie hoorde te staan. Plakken in Word met de weergave van opmaaktekens aan, toonden ze zich als kleine cirkels in plaats van punten. OpenAI verklaarde dat de tekens een bijverschijnsel waren van grootschalige versterkingsleren, geen opzettelijke watermerk, en dat de tekens later ophielden met verschijnen. De les bleef hangen: AI-tekst kan tekens bevatten die je nooit ziet, en deze worden meegekopiëerd bij elk plak- en plakactie in je CMS.
Statistische watermerken: SynthID en Claude
Een taalmodel kiest elk volgend woord uit een lijst met waarschijnlijke kandidaten, met een beetje willekeur. Een statistisch watermerk vervangt die willekeurigheid door een pseudo-willekeurige keuze die wordt gestart met een geheime sleutel. Voor een lezer ziet de tekst er volledig normaal uit. Voor iemand die de sleutel vasthoudt, toont een lang genoeg passage een patroon van woordkeuzes dat bij toeval bijna nooit zou voorkomen.
De woorden die Claude kiest zijn nog steeds willekeurig, maar nu kan men de woordvolgorde controleren en zien of deze consistent is met de keuzes die Claude zou maken als het de sleutel gebruikte.
Anthropic, Hoe het tekstwatermerk van Claude werkt (augustus 2026)
Twee details zijn belangrijk voor uitgevers. Het watermerk wordt sterker naarmate de tekst langer is, en volgens Anthropic verwijdert licht bewerken het niet, terwijl een volledige herschrijving waarbij elk woord wordt vervangen, het wel verwijdert.
Wie watermerkt AI-tekst (september 2026)
| Aanbieder | Tekstwatermerk | Type | Wie kan het controleren |
|---|---|---|---|
| Google Gemini | Ja, sinds 2024 | Statistisch (SynthID) | Gereedschappen van Google voor SynthID |
| Anthropic Claude | Ja, nieuwe modellen sinds augustus 2026 | Statistisch (op SynthID gebaseerd) | Anthropic detectie API, privé-preview voor toezichthouders, media, onderwijzers en onderzoekers |
| OpenAI ChatGPT | Nog niet voor tekst; afbeeldingen en audio zijn al gemarkeerd | Tekstherkomst aangekondigd als doel | OpenAI gereedschappen (voor afbeeldingen en audio vandaag) |
| NoTrack API | Nee | Geen watermerk, geen verborgen tekens | Niemand |
Waarom gemarkeerde tekst contentcreators schaadt
Google zegt al jaren dat het inhoud rangschikt op kwaliteit, niet op hoe deze is geproduceerd. Het probleem is iedereen anders in de keten.
- Je klanten kunnen dit controleren. Bureaus en freelancers leveren tekst aan mensen die steeds vaker AI-controles uitvoeren voordat ze betalen. Een watermerk verandert "AI-ondersteund en zorgvuldig bewerkt" in "gemarkeerd", zonder ruimte voor nuance.
- Platformen en marktplaatsen screenen. Publicatieplatforms, freelance marktplaatsen, advertentienetwerken en review-sites voegen AI-detectie toe. Een detecteerbaar signatuur is de makkelijkste manier om te filteren.
- Het onthult je workflow. Een watermerk vertelt iedereen met een detector welk hulpmiddel je content heeft geschreven. Voor een contentbedrijf is dat concurrentie-informatie die je niet hebt goedgekeurd om te publiceren.
- Het volgt de tekst overal. Gesignaleerde tekst behoudt zijn signatuur, of hij nu wordt gesyndiceerd, licht vertaald of opnieuw gepost. Je kunt niet controleren wat je niet kunt zien.
- Verborgen tekens breken dingen. Onzichtbare Unicode breekt stil de interne zoekfunctie, exact-match zoektermen, woordtellingen, spellingscontroles en elke code die je plakt. Het kan ook twee op het eerste gezicht identieke pagina's byte voor byte laten verschillen.
Hoe je tekst controleren op AI-watermerken
1. Onzichtbare tekens: controleren in seconden
Snelle handmatige test: plak de tekst in Microsoft Word en druk op Ctrl+Shift+8 (Cmd+8 op Mac) om opmaaktekens te tonen. Normale spaties worden weergegeven als stippen; speciale spaties worden weergegeven als kleine cirkels of andere symbolen. Voor alles op grotere schaal, gebruik een script:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
Eén caveat die het weten waard is: de zero-width joiner (U+200D) is ook een legitiem onderdeel van veel emoji’s, zoals 🚴♂️. Als een hit binnen een emoji zit, laat het dan met rust.
2. Statistische watermerken: die kun je niet zelf controleren
In de tekst is niets te zien. Alleen de detector van de aanbieder, die de geheime sleutel vasthoudt, kan bepalen of een passage een watermerk heeft. Anthropic's detectie-API is in private preview voor geselecteerde organisaties, niet voor het publiek. In de praktijk betekent dit dat je moet aannemen: als een watermerkend model het heeft geschreven en je hebt het niet volledig herschreven, dan is het gemarkeerd.
Hoe AI-watermerken uit tekst verwijderen
- Verwijder onzichtbare tekens. Vervang speciale spaties door normale spaties en verwijder zero-width tekens. Veilig, direct en verliesvrij.
- Schrijf volledig opnieuw met een onafhankelijk model. Lichte bewerkingen laten een statistisch watermerk intact. Een volledige herschrijving, waarbij de zinsopbouw en woordkeuze overal veranderen, niet. Gebruik een model dat zijn eigen output niet van een watermerk voorziet, anders vervang je slechts één handtekening door een andere.
- Geef de tekst een menselijk tintje. Een volledige herschrijving plus de humanizer-prompt uit onze gids over het menselijk maken van AI-tekst verwijdert de standaardzinswendingen en het eentonige ritme waar detectors op af gaan.
- Controleer nog één keer. Voer de tekenscontrole opnieuw uit voordat je publiceert. Het kost slechts een seconde.
Stap 1 in de code: tekens opschonen
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Stap 2 in de code: een volledige herschrijving via NoTrack API
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content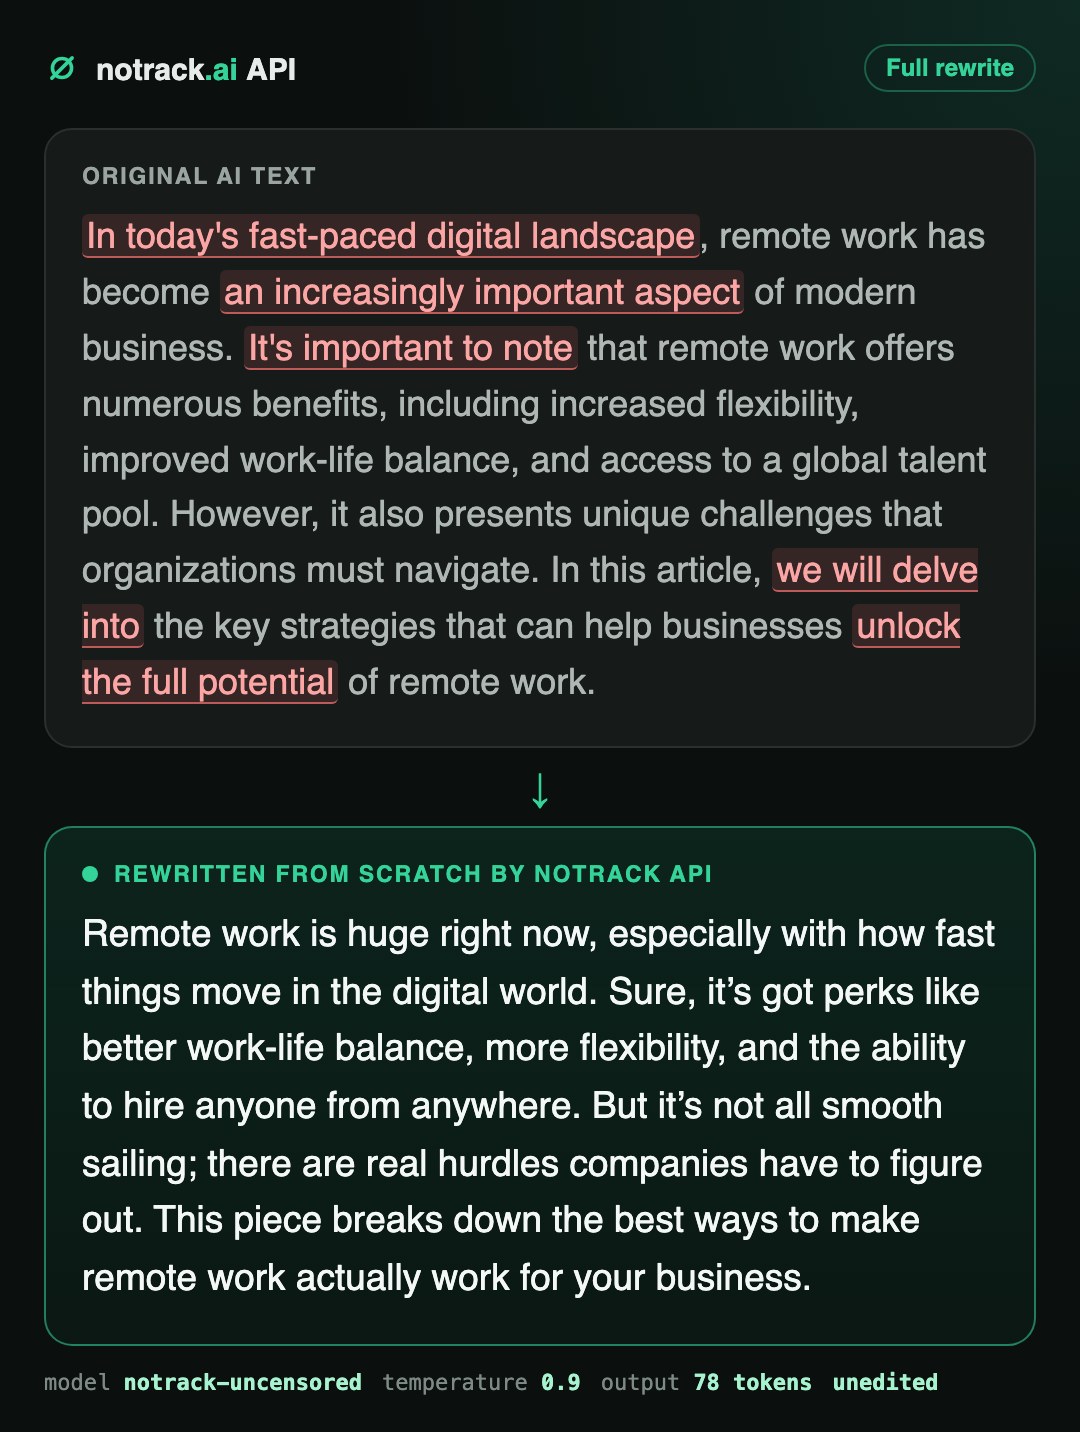
Herschrijf lange documenten sectie voor sectie. Dit houdt de kwaliteit hoog en zorgt ervoor dat elk deel van de tekst wordt herschreven, niet alleen het begin.
Of sla het watermerk volledig over
Tekst achteraf opschonen werkt. Geen tekst hebben die opgeschoond hoeft te worden, werkt beter. NoTrack API draait ons eigen ongecensureerde model op onze eigen GPUs. Het is geen wrapper voor OpenAI, Anthropic of Google, dus een bovenliggende aanbieder stempelt geen handtekening op je tekst terwijl deze door de API loopt.
- Geen watermerk. De NoTrack-output bevat geen statistisch watermerk en geen provenance-handtekening. De tekst is van jou, er is niets anders aan gekoppeld.
- Geen verborgen tekens, gemeten. We hebben 26 NoTrack API-antwoorden, ongeveer 20.000 tekens, gescand op null-breedte- en speciale spatiekarakters. Buiten één emoji was het aantal nul.
- Geen logs. Prompts en antwoorden worden nooit op schijf geschreven, noch door de gateway, noch door de modelservers. We bewaren een request-ID en token-aantallen voor de facturatie. Niemand kan je inhoud later opvragen.
- Geen onderwerpfilter. Nachtleven, dating, volwassen, gokken, crypto, donkere fictie: het model schrijft en herschrijft wat mainstream-assistenten weigeren of afzwakken.
- Twee-regels schakelaar. Compatibel met OpenAI. Wijzig de basis-URL naar
https://api.notrack.ai/v1en de sleutel, behoud de rest van je code, tools en plugins.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
Het schrijven van 1.000 artikelen van 800 woorden kost ongeveer $1,10 aan uitvoertokens. Het gratis tegoed op je eerste sleutel is genoeg om de hele workflow te testen voordat je een cent uitgeeft. Maak je sleutel aan of lees de API-documentatie.
Veelgestelde vragen
Watermerkt ChatGPT zijn tekst?
Niet per september 2026. OpenAI markeert gegenereerde afbeeldingen en audio en heeft aangegeven de herkomstproblematiek (provenance) ook op tekst uit te willen breiden. In april 2025 produceerden sommige ChatGPT-modellen onzichtbare smalle niet-afbrekende spaties, wat OpenAI omschreef als een trainingseigenaardigheid en niet als een watermerk.
Watermerkt Claude zijn tekst?
Ja. Anthropic kondigde in augustus 2026 aan dat nieuwe Claude-modellen watergemerkte tekst genereren met behulp van een statistische methode gebaseerd op Google's SynthID, en dat oudere modellen worden bijgewerkt. Het watermerk voegt geen tekens toe; het zit in de woordkeuzes.
Watermerkt Gemini zijn tekst?
Ja. Google watermerkt de tekstuitvoer van Gemini al met SynthID sinds 2024.
Kan ik een watermerk verwijderen door een paar woorden aan te passen?
Nee. Statistische watermerken overleven lichte bewerkingen. Anthropic zelf geeft aan dat een volledige herschrijving waarbij elk woord wordt vervangen het watermerk verwijdert. Herschrijf volledig met een model dat geen eigen watermerk toevoegt.
Wat is een ChatGPT- of Claude-watermerkverwijderaar?
Het is een tweestapsproces: onzichtbare tekens verwijderen en vervolgens de tekst volledig herschrijven met een onafhankelijk model. De bovenstaande Python-fragmenten doen beide, waarbij NoTrack API wordt gebruikt voor de herschrijving.
Voegt NoTrack API een watermerk of verborgen tekens toe?
Nee. NoTrack draait zijn eigen model op eigen hardware en voegt geen watermerk, geen herkomstsignatuur en geen verborgen tekens toe. Het bewaart ook geen van je prompts of outputs.
Straft Google AI-gegenereerde inhoud af?
Google heeft aangegeven nuttige, hoogwaardige inhoud te belonen, ongeacht hoe deze is geproduceerd. Watermerken zijn minder belangrijk voor de ranking en belangrijker voor de mensen en platforms aan wie je de inhoud levert.