
Sedan augusti 2026 är texten du får från de största AI-assistenter inte längre bara text. Claude och Gemini döljer nu ett statistiskt vattenmärke i orden de väljer, och OpenAI har sagt att text är nästa steg för ChatGPT. Du kan inte se det, men leverantören kan kontrollera för det, och det kan alla som de ger en detektor till. Om du bygger webbplatser, skriver åt kunder eller publicerar i stor skala är här vad som finns i AI-genererad text idag, hur du kontrollerar ditt eget innehåll, hur du tar bort AI-vattenmärken, och hur du genererar ren text med NoTrack API från början.
Den osynliga etiketten på ditt innehåll
Den 2 augusti 2026 började transparensreglerna i EU:s AI-förordning (artikel 50) att gälla. De kräver att leverantörer av generativ AI markerar vad deras system producerar på ett maskinläsbart sätt, så att det kan upptäckas som AI-genererat. De stora labben har rört på sig snabbt.
- Anthropic (Claude). Den 14 augusti 2026 meddelade Anthropic att nya Claude-modeller genererar text som innehåller ett vattenmärke, med äldre modeller som uppdateras under de följande månaderna. En detektor API är redan i privat förhandsvisning för myndigheter, polis, media, faktagranskare, forskare och utbildningsorganisationer.
- Google (Gemini). Gemini har vattenmärkt sin textutdata sedan 2024 med SynthID, en metod som Google DeepMind publicerade i Nature och som öppnades upp 2024. Claude:s vattenmärke bygger på samma tillvägagångssätt.
- OpenAI (ChatGPT). OpenAI markerar redan genererade bilder och ljud och har sagt att man vill utöka innehållsursprung till text. Det har rapporterats att man byggt ett textvattenmärke internt men inte släppt det ännu.
För en tillfällig användare som frågar efter ett recept spelar allt detta ingen roll. För den som publicerar AI-assisterad text, säljer den eller levererar den till kunder ändrar det dock spelreglerna: ditt innehåll bär nu en signatur som du inte lade till, inte kan se och inte kan stänga av.
Två typer av AI-textvattenmärke
Begreppet "AI-vattenmärke" används för två mycket olika saker. Vilken typ du har att göra med avgör hur du tar bort det.
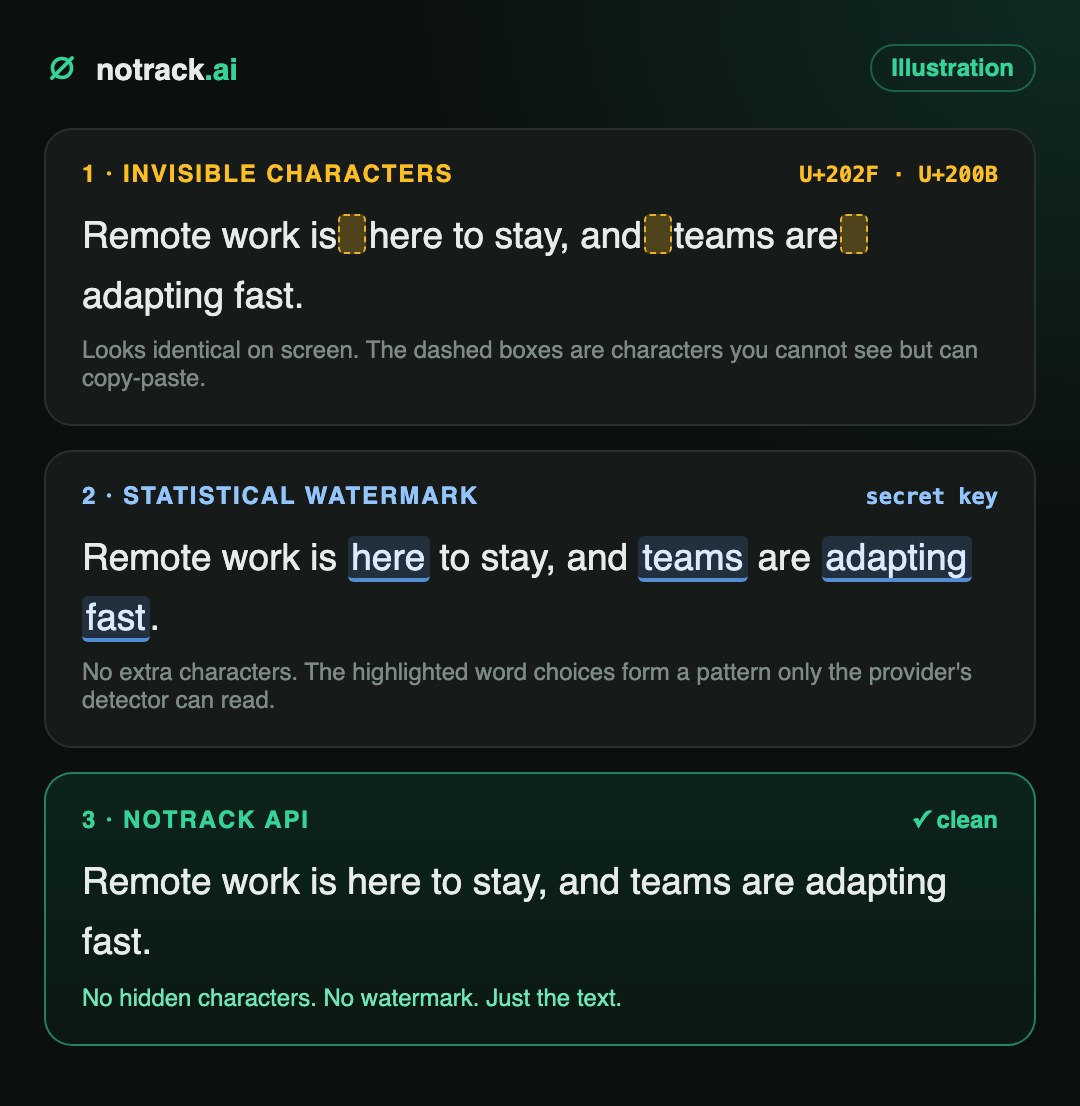
Osynliga tecken
Unicode-tecken som ser exakt ut som ett vanligt mellanslag eller som ingenting alls: tecken med noll bredd, ordbindare och smala icke-brytande mellanslag.
- Lätt att upptäcka med ett enkelt skript
- Lätt att ta bort: stryp eller ersätt dem
- Stör saker i det tysta: sökning, ordantal, nyckelordsmatchning, kod
Statistiska vattenmärken
Inga extra tecken alls. Modellens ordval styrs av en hemlig nyckel, vilket lämnar ett mönster som bara leverantörens detektor kan läsa.
- Osynligt för läsare och för alla textredigerare
- Överlever klistra in och lätt redigering
- Svagas vid omfattande omskrivning; en fullständig omskrivning tar bort den
Osynliga tecken: avsnittet ChatGPT
I april 2025 upptäckte forskare att text från OpenAI:s då nyutvecklade modeller o3 och o4-mini innehöll smala icke-brytande mellanslag (U+202F) på ställen där ett vanligt mellanslag hörde hemma. Klistrade in i Word med formateringsmarkeringar aktiverade visades de som små cirklar istället för prickar. OpenAI förklarade att tecknen var en biverkning av förstärkningsinlärning i stor skala, inte ett avsiktligt vattenmärke, och att tecknen senare upphörde att visas. Lektionen satt ändå: AI-text kan bära på tecken som du aldrig ser, och de följer med vid varje klistra in-klistra ut till din CMS.
Statistiska vattenmärken: SynthID och Claude
En språkmodell väljer varje nästa ord från en lista med sannolika kandidater, med en smula slumpmässighet. Ett statistiskt vattenmärke ersätter den slumpmässigheten med ett pseudo-slumpmässigt val som fröas med en hemlig nyckel. För en läsare ser texten helt normal ut. För någon som innehar nyckeln visar en tillräckligt lång passage ett mönster i ordval som nästan aldrig skulle inträffa av slumpen.
Orden som Claude väljer är fortfarande slumpmässiga, men nu kan man kontrollera ordsekvensen och se om den stämmer överens med de val Claude skulle göra om den använde nyckeln.
Anthropic, Hur Claude:s textvattenmärkning fungerar (augusti 2026)
Två detaljer är viktiga för utgivare. Vattenmärket blir starkare ju längre texten är, och enligt Anthropic kommer ljum redigering inte att ta bort det, medan en fullständig omskrivning där varje ord ersätts kommer att göra det.
Vem vattenmärker AI-text (september 2026)
| Leverantör | Textvattenmärke | Typ | Vem kan kontrollera det |
|---|---|---|---|
| Google Gemini | Ja, sedan 2024 | Statistiskt (SynthID) | Google:SynthIDs verktyg |
| Anthropic Claude | Ja, nya modeller sedan augusti 2026 | Statistisk (SynthID-baserad) | Anthropic detektering API, privat förhandsvisning för myndigheter, media, utbildare och forskare |
| OpenAI ChatGPT | Inte för text ännu; bilder och ljud är redan märkta | Textursprung tillkännagavs som ett mål | OpenAI verktyg (bilder och ljud idag) |
| NoTrack API | Nej | Ingen vattenstämpel, inga dolda tecken | Ingen |
Varför vattenmärkt text skadar innehållsskapare
Google har under åratal hävdat att den rankar innehåll efter kvalitet, inte efter hur det har producerats. Problemet är att alla andra i kedjan också gör så.
- Dina kunder kan kontrollera detta. Byråer och frilansare levererar text till personer som allt oftare kontrollerar den med AI-detektorer innan de betalar. En vattenmärkning gör att "AI-assisterat och noggrant redigerat" snabbt blir "flaggat" utan utrymme för nyanser.
- Plattformar och marknader granskar. Publiceringsplattformar, frilansmarknader, annonsnätverk och recensionssajter lägger till AI-detektion. En upptäckbar signatur är det enklaste att filtrera på i världen.
- Det avslöjar ditt arbetsflöde. Ett vattenmärke berättar för vem som helst med en detektor vilket verktyg som skrev ditt innehåll. För ett innehållsföretag är detta konkurrensinformation som du aldrig har samtyckt till att publicera.
- Det följer texten överallt. Syndikerad, lätt översatt eller återpublicerad behåller vattenmärkt text sin signatur. Du kan inte granska det du inte kan se.
- Dolda tecken kan störa saker. Osynliga Unicode bryter tyst webbplatsens sökning, exakta matchningar av nyckelord, ordräkningar, stavningskontroller och all kod du klistrar in. Det kan också få två sidor som ser identiska ut att skilja sig byte för byte.
Så här kontrollerar du din text på AI-vattenmärken
1. Osynliga tecken: kontrollera på sekunder
Snabb manuell test: klistra in texten i Microsoft Word och tryck på Ctrl+Shift+8 (Cmd+8 på Mac) för att visa formateringsmarkeringar. Vanliga mellanslag visas som prickar; specialmellanslag visas som små cirklar eller andra symboler. För allt i större skala, använd ett skript:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
En detalj värd att känna till: tecknet för nollbreddskoppling (U+200D) är också en legitim del av många emoji, som 🚴♂️. Lämna ett sådant tecknet i fred om det befinner sig inuti en emoji.
2. Statistiska vattenmärken: du kan inte kontrollera dem själv
Det finns inget att se i texten. Endast leverantörens detektor, som innehar den hemliga nyckeln, kan avgöra om en textpassage är vattenmärkt. Anthropic:s detektering API finns i privat förhandsvisning för utvalda organisationer, inte för allmänheten. I praktiken innebär det att du måste utgå från att: om en vattenmärkningsmodell skrev texten och du inte har omarbetat den helt, är den märkt.
Ta bort AI-vattenmärken från text
- Ta bort osynliga tecken. Ersätt specialmellanslag med vanliga mellanslag och ta bort tecken med nollbredd. Säkert, omedelbart och förlustfritt.
- Skriv om helt med en oberoende modell. Lätta ändringar lämnar ett statistiskt vattenmärke intakt. En fullständig omarbetning, där meningsbyggnad och ordförråd ändras genomgående, gör det inte. Använd en modell som inte vattenmärker sin egen utdata, annars byter du bara ut ett signaturmotiv mot ett annat.
- Människogör stilen. En fullständig omarbetning kombinerat med humaniseringsprompten från vår guide till att humanisera AI-text tar bort de typiska fraser och det släta flöde som detektorer gillar.
- Skanna en gång till. Kör teckenkontrollen igen innan du publicerar. Det tar bara en sekund.
Steg 1 i koden: rensa tecknen
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
Steg 2 i koden: en fullständig omarbetning via NoTrack API
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content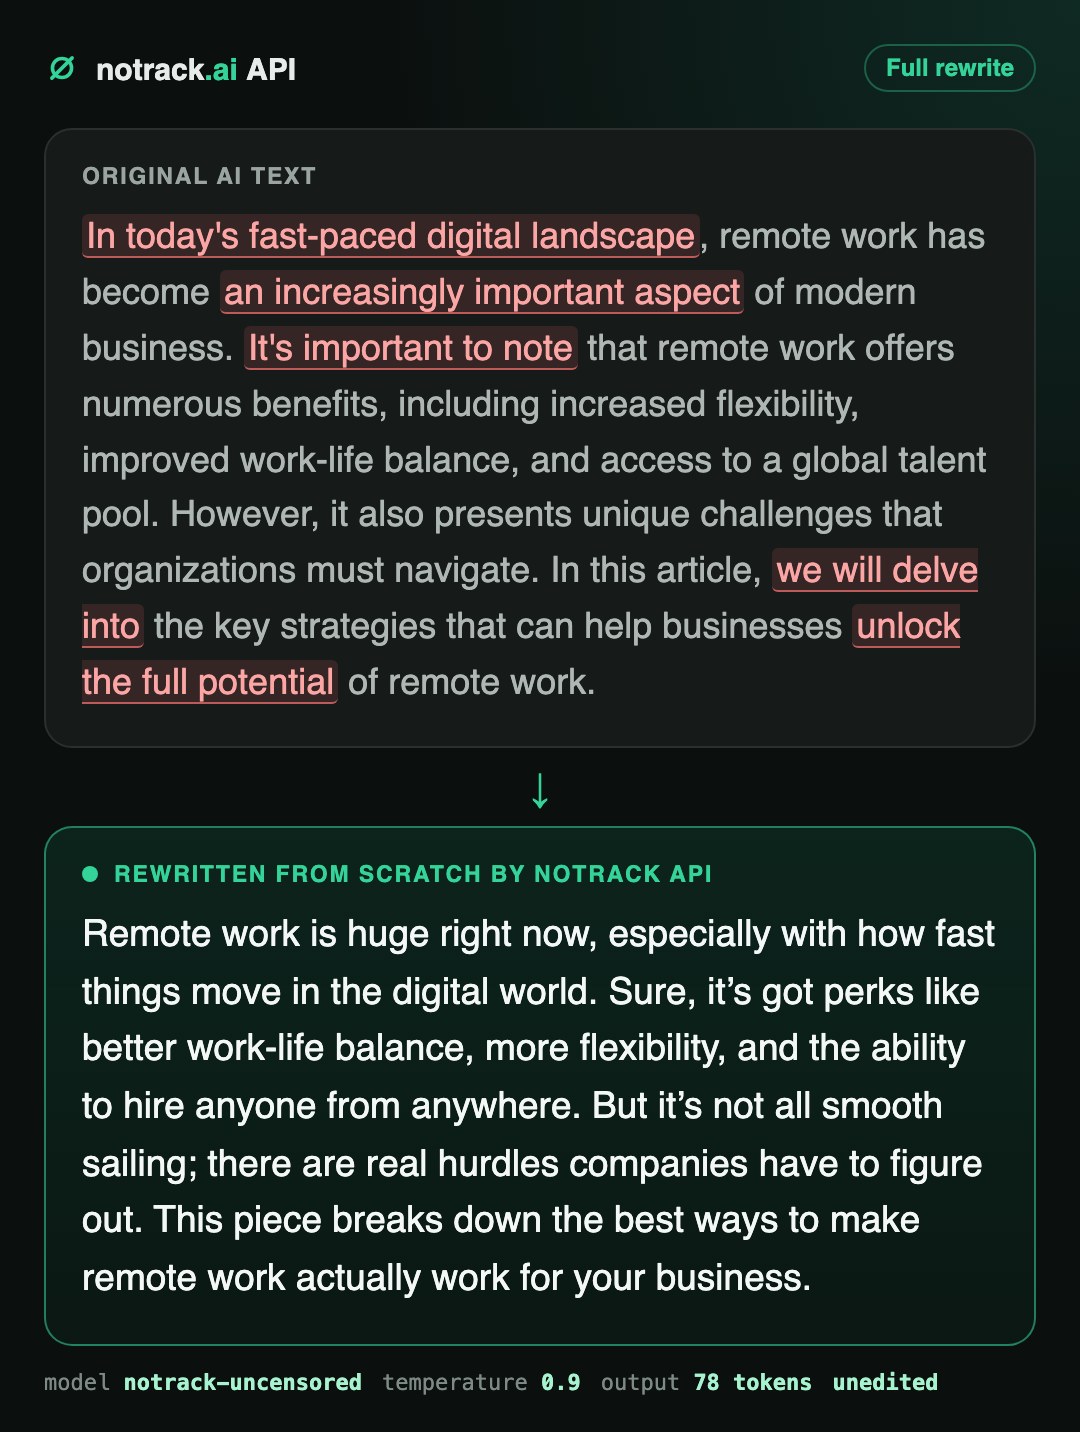
Omarbetade långa dokument avsnitt för avsnitt. Det håller kvaliteten hög och säkerställer att varje del av texten omarbetas, inte bara inledningen.
Eller hoppa över vattenmärket helt
Att rensa texten i efterhand fungerar. Att inte ha något att rensa fungerar bättre. NoTrack API kör vår egen obegränsade modell på egna GPU:er. Det är ingen omslutning av OpenAI, Anthropic eller Google, så ingen leverantör i kedjan stämplar sin signatur på din text när den passerar.
- Inget vattenmärke. NoTrack-utmatningen bär ingen statistisk vattenstämpel och ingen provenienssignatur. Texten är din, inget annat är kopplat till den.
- Inga dolda tecken, verifierat. Vi skannade 26 NoTrack API-svar, cirka 20 000 tecken, efter tecken med nollbredd och specialmellanslag. Utom för en emoji var antalet noll.
- Inga loggar. Promptar och svar skrivs aldrig till disk, varken av gatewayn eller modellserverna. Vi sparar ett begärandegener och tokenantal för fakturering. Ingen kan söka upp ditt innehåll senare.
- Ingen ämnesfilter. Nattliv, dejting, vuxet, spel, krypto, mörk skönlitteratur: modellen skriver och omskriver det som huvudström-assistenter vägrar eller utvattar.
- Tvåradig växling. OpenAI-kompatibel. Ändra bas-URL:en till
https://api.notrack.ai/v1och nyckeln, behåll resten av din kod, verktyg och plugins.
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
Att skriva 1 000 artiklar på 800 ord kostar cirka 1,10 $ i utmatningstokens. Den gratis kredit du får på din första nyckel räcker för att testa hela arbetsflödet innan du spenderar en krona. Skapa din nyckel eller läs API-dokumentationen.
Vanliga frågor
Vattensmärker ChatGPT sina texter?
Inte senast i september 2026. OpenAI märker genererade bilder och ljud och har uppgett att det vill utöka provenansen till text. I april 2025 producerade vissa ChatGPT-modeller osynliga smala icke-brytande mellanslag, vilket OpenAI beskrev som en träningskuriositet snarare än ett vattenmärke.
Vattensmärker Claude sina texter?
Ja. Anthropic meddelade i augusti 2026 att nya Claude-modeller genererar vattenmärkta texter med hjälp av en statistisk metod baserad på Google:s SynthID, och att äldre modeller uppdateras. Vattenmärket tillför inga tecken; det finns i ordvalen.
Vattensmärker Gemini sina texter?
Ja. Google har vattenmärkt Gemini:s textutdata med SynthID sedan 2024.
Kan jag ta bort ett vattenmärke genom att redigera några få ord?
Nej. Statistiska vattenmärk överlever lätt redigering. Anthropic noterar själv att en komplett omskrivning där varje ord ersätts tar bort vattenmärket. Skriv om texten helt med en modell som inte lägger till sitt eget vattenmärke.
Vad är en ChatGPT- eller Claude-vattenmärkesborttagare?
Det är en tvåstegsprocess: ta bort osynliga tecken och skriv sedan om texten helt med en oberoende modell. Snippetsen Python ovan gör båda delarna, med NoTrack API för omskrivningen.
Lägger NoTrack API till ett vattenmärke eller dolda tecken?
Nej. NoTrack kör sin egen modell på egen hårdvara och lägger till inget vattenmärke, ingen provenienssignatur och inga dolda tecken. Den lagrar heller inte dina prompts eller utdata.
Straffar Google AI-genererat innehåll?
Google har sagt att det belönar hjälpsamt, högkvalitativt innehåll oavsett hur det produceras. Vattenmärken spelar mindre roll för rankingen och mer för de personer och plattformar som du levererar innehåll till.